Журнал разработки Николая Ланца

24 сент. 2026 г.

Настроено кеширование статических ресурсов через Varnish

Для сайта gorodskie-bani.ru настроено проксирование статических ресурсов через Varnish с TTL 7 дней. Через кеш проходят JS, CSS, шрифты, изображения, иконки и ресурсы /styles/ от tileserver. Динамические страницы намеренно не кешируются и продолжают обрабатываться приложением напрямую (return (pass)).

Зачем это нужно

Основная задача кеширования — отдавать неизменяемые и редко меняющиеся ресурсы не из Node.js-приложения и tileserver при каждом запросе, а непосредственно из памяти/кеша Varnish.

Это даёт сайту несколько практических преимуществ:

  • Снижается время отдачи статики. После первого запроса ресурс попадает в кеш, последующие запросы обслуживаются Varnish без обращения к backend.
  • Уменьшается нагрузка на приложение и tileserver. JS, CSS, изображения, шрифты и стили карты не создают повторную нагрузку на backend-контейнеры.
  • Повышается стабильность под нагрузкой. При одновременных заходах пользователей большая часть запросов к статике обслуживается на уровне кеширующего прокси.
  • Ускоряется загрузка страниц для пользователей. Быстрая отдача CSS, JS, шрифтов и изображений уменьшает ожидание ресурсов, необходимых для отрисовки страницы.
  • Создаётся положительный технический эффект для SEO. Скорость загрузки и пользовательские метрики производительности, в том числе связанные с Core Web Vitals, являются частью технического качества сайта. Varnish не меняет позиции в поиске напрямую, но помогает уменьшить сетевые задержки и нагрузку на origin, что создаёт более стабильные условия для быстрой загрузки и обхода сайта поисковыми роботами.

Конфигурация Varnish

Настроены два backend:

  • основной backend приложения — gorodskie-bani--agent-app-1:3000;
  • отдельный backend tileserver — gorodskie-bani-ru-tileserver-1:80.
vcl 4.1;

backend default {
    .host = "gorodskie-bani--agent-app-1";
    .port = "3000";
}

backend tileserver {
    .host = "gorodskie-bani-ru-tileserver-1";
    .port = "80";
}

В vcl_recv запросы к /styles/ отправляются в tileserver. Для кешируемых ресурсов Cookie удаляются, чтобы пользовательские cookies не дробили кеш и не мешали повторному использованию одного объекта разными запросами.

sub vcl_recv {
    if (req.url ~ "^/styles/") {
        set req.backend_hint = tileserver;
        unset req.http.Cookie;
        return (hash);
    }
    if (req.url ~ "\.(js|css|woff2?|ttf|eot|svg|ico|png|jpg|jpeg|gif|webp|avif)(\?.*)?$") {
        unset req.http.Cookie;
        return (hash);
    }
    return (pass);
}

Все остальные запросы идут через pass, то есть HTML и динамические ответы приложения этим правилом не кешируются. Это снижает риск отдачи устаревшего персонализированного или динамического контента.

Ключ кеша строится по URL и host:

sub vcl_hash {
    hash_data(req.url);
    hash_data(req.http.host);
    return (lookup);
}

Это позволяет раздельно хранить ресурсы разных URL и не смешивать кеш между хостами. Query string остаётся частью req.url, поэтому версии ассетов с cache-busting параметрами получают отдельные записи кеша.

Для /styles/ и статических файлов задан TTL 7 дней, а Set-Cookie удаляется из кешируемых backend-ответов:

sub vcl_backend_response {
    if (bereq.url ~ "^/styles/") {
        set beresp.ttl = 7d;
        unset beresp.http.Set-Cookie;
    }
    if (bereq.url ~ "\.(js|css|woff2?|ttf|eot|svg|ico|png|jpg|jpeg|gif|webp|avif)(\?.*)?$") {
        set beresp.ttl = 7d;
        unset beresp.http.Set-Cookie;
    }
}

TTL 7 дней позволяет долго обслуживать повторные запросы из Varnish, при этом стандартный подход с версионированными именами файлов или query-параметрами позволяет получать новую версию ресурса после деплоя без ожидания истечения старого кеша.

Для диагностики добавлены служебные заголовки X-Cache и X-Cache-TTL:

sub vcl_deliver {
    if (obj.hits > 0) {
        set resp.http.X-Cache = "HIT";
    } else {
        set resp.http.X-Cache = "MISS";
    }
    set resp.http.X-Cache-TTL = obj.ttl;
}

По ним можно быстро проверить фактическую работу кеша: первый запрос обычно отдаётся как MISS, последующие — как HIT, а X-Cache-TTL показывает оставшееся время жизни объекта.

Маршрутизация Traefik

Чтобы нужные запросы действительно попадали в Varnish, в Traefik добавлены отдельные роутеры с высоким приоритетом.

Статические файлы:

gorodskie-bani.ru-static:
  rule: 'Host(`gorodskie-bani.ru`) && PathRegexp(`^.*\.(js|css|woff2?|ttf|eot|svg|ico|png|jpg|jpeg|gif|webp|avif)$`)'
  entryPoints:
    - websec
  service: gorodskie-bani.ru-varnish
  tls:
    certResolver: letsencrypt
  priority: 200

Ресурсы /styles:

gorodskie-bani.ru-styles:
  rule: "Host(`gorodskie-bani.ru`) && PathPrefix(`/styles`)"
  entryPoints:
    - websec
  middlewares: []
  service: gorodskie-bani.ru-varnish
  tls:
    certResolver: letsencrypt
  priority: 200

Таким образом, Traefik отделяет кешируемые запросы на входе и передаёт их в сервис Varnish, после чего Varnish либо отдаёт объект из кеша, либо получает его с соответствующего backend и сохраняет на 7 дней.

Итог для сайта и SEO

В результате статическая часть gorodskie-bani.ru обслуживается через отдельный кеширующий слой. Это уменьшает количество обращений к приложению и tileserver, ускоряет повторную загрузку ресурсов и делает время ответа более стабильным при росте трафика.

Для SEO это полезно прежде всего как инфраструктурная оптимизация производительности: браузер быстрее получает критические CSS/JS/шрифты/изображения, backend меньше конкурирует за ресурсы со статическими запросами, а сайт устойчивее сохраняет нормальную скорость ответа под нагрузкой. В совокупности это помогает техническому качеству сайта и пользовательскому опыту, которые важны для поисковой видимости и эффективности органического трафика.
Настроить кеширование varnish

23 сент. 2026 г.

Диагностика аномального потребления памяти MySQL 5.7 в Docker и устранение причины

В процессе работы с Docker-окружением была обнаружена нетипичная проблема при старте контейнера mysql:5.7: перед нормальным запуском MySQL контейнер в течение нескольких минут резко увеличивал потребление памяти, доходя примерно до четверти доступной RAM хоста, затем освобождал память и повторял цикл. На машине с ~64 ГБ RAM всплески доходили примерно до 16 ГБ; в среде с ~2 ГБ RAM наблюдалось порядка 500 МБ. После нескольких таких циклов потребление стабилизировалось на нормальном уровне.

Исходная конфигурация MySQL была практически минимальной:

mysql:
  image: mysql:5.7
  environment:
    - MYSQL_ROOT_PASSWORD=${MYSQL_ROOT_PASSWORD:-your_mysql_password}

Отдельных настроек innodb_buffer_pool_size или memory limit не было.

Первичное наблюдение

По графику docker stats было видно характерную «пилу»: процесс быстро набирал гигабайты памяти, доходил до некоторого предела, затем память почти полностью освобождалась, после чего цикл повторялся. При этом в начале старта логов почти не было, что создавало впечатление, будто MySQL просто долго инициализируется без каких-либо сообщений.

После запуска с очищенным datadir удалось увидеть точную последовательность событий. До исправления лог выглядел так:

03:33:05 Entrypoint script for MySQL Server 5.7.44 started
        ... 37 секунд тишины ...
03:33:42 Switching to dedicated user 'mysql'
03:33:42 Entrypoint script for MySQL Server 5.7.44 started
        ... ещё 37 секунд тишины ...
03:34:19 Initializing database files

То есть практически всё аномальное время уходило не на инициализацию InnoDB и не на создание файлов базы, а на действия docker-entrypoint.sh, выполняемые до полноценного запуска сервера.

При этом сам MySQL явно сообщал:

InnoDB: Initializing buffer pool, total size = 128M

Это исключило гипотезу, что огромный расход памяти связан с InnoDB buffer pool. По умолчанию в данной конфигурации он составлял всего 128 МБ.

Причина

Проблема оказалась связана с известным поведением MySQL 5.7 при чрезмерно большом лимите открытых файлов (RLIMIT_NOFILE).

Официальный Docker entrypoint для MySQL перед реальным запуском сервера делает служебные вызовы mysqld, в частности в режиме вида:

mysqld --verbose --help

Это используется для проверки конфигурации и получения значений вроде datadir, socket и других параметров.

В MySQL 5.7 есть известная проблема: если RLIMIT_NOFILE аномально большой, служебный запуск mysqld --verbose --help может инициировать очень большую временную аллокацию памяти. В Docker такое проявляется особенно заметно, если контейнер наследует огромный nofile от Docker daemon / systemd.

Из-за этого происходила следующая последовательность:

docker-entrypoint.sh
    ↓
служебный запуск mysqld --verbose --help
    ↓
огромная временная аллокация из-за RLIMIT_NOFILE
    ↓
рост RAM и CPU в течение десятков секунд
    ↓
служебный процесс завершается
    ↓
память освобождается
    ↓
entrypoint выполняет следующий аналогичный вызов
    ↓
повторный всплеск

Это объяснило сразу несколько наблюдений:

  • большие всплески памяти происходили до нормального запуска MySQL;
  • память после каждого всплеска возвращалась системе;
  • было несколько одинаковых по длительности циклов;
  • в этот момент почти не было обычных серверных логов;
  • после завершения bootstrap-процедуры MySQL работал с нормальным потреблением памяти.

Решение

В Docker Compose был явно задан нормальный предел количества открытых файлов:

mysql:
  image: mysql:5.7
  environment:
    - MYSQL_ROOT_PASSWORD=${MYSQL_ROOT_PASSWORD:-your_mysql_password}

  ulimits:
    nofile:
      soft: 65536
      hard: 65536

Важно: этот параметр не является ограничением памяти контейнера. Он ограничивает только число файловых дескрипторов, которые процесс может одновременно открыть. В дескрипторы входят файлы, сокеты и соединения.

То есть nofile: 65536 не означает 64 МБ, 64 ГБ или какой-либо иной объём памяти и никак напрямую не задаёт memory limit контейнера.

Значение 65536 выбрано как нормальный и достаточно большой предел для обычного MySQL в веб-проекте. Оно оставляет большой запас по количеству файлов/сокетов, но не позволяет MySQL 5.7 попасть в проблемный сценарий с огромным RLIMIT_NOFILE.

Проверка результата на существующей базе

После добавления ulimits.nofile повторный запуск существующего datadir изменился радикально:

03:38:54 Entrypoint started
03:38:54 Switching to dedicated user 'mysql'
03:38:54 Entrypoint started
03:38:54 mysqld starting
03:38:54 mysqld: ready for connections

Обе прежние паузы примерно по 37 секунд исчезли полностью. Сервер стал готов к подключениям практически мгновенно.

Проверка на полностью чистом datadir

Для корректной проверки первичной инициализации данные MySQL были реально очищены с учётом того, что использовались bind mounts:

volumes:
  - ./mysql/data:/var/lib/mysql
  - ./mysql/conf.d:/etc/mysql/conf.d

После этого был выполнен полный cold start. Новый лог:

03:41:42 Entrypoint started
03:41:42 Switching to dedicated user 'mysql'
03:41:42 Entrypoint started
03:41:43 Initializing database files
03:41:45 Database files initialized
03:41:45 Starting temporary server
03:41:49 MySQL init process done. Ready for start up
03:41:49 mysqld: ready for connections

Таким образом, полный первый запуск с пустой базой занял примерно 7 секунд вместо нескольких минут.

При этом InnoDB по-прежнему использовал штатный буфер:

InnoDB: Initializing buffer pool, total size = 128M

То есть исправление не уменьшало рабочую память MySQL искусственным лимитом — оно устранило именно ошибочную временную аллокацию на bootstrap-этапе.

Фактическое потребление памяти после исправления

После нормального запуска docker stats показывал:

173.4MiB / 61.5GiB

То есть контейнер реально использовал около 173 МБ RAM. Число 61.5GiB справа — это доступная контейнеру память хоста при отсутствии отдельного memory limit, а не резерв MySQL.

ulimits.nofile на это значение напрямую не влияет. Для ограничения RAM контейнера потребовался бы отдельный Docker memory limit (mem_limit, resources limits и т. п.), но в рамках данной проблемы это не требовалось.

Итог

Причина долгого старта и огромных всплесков памяти была не в реальном рабочем потреблении MySQL, не в InnoDB buffer pool и не в объёме данных. Проблему вызывал MySQL 5.7 на служебных запусках из Docker entrypoint при чрезмерно большом RLIMIT_NOFILE.

Исправление:

ulimits:
  nofile:
    soft: 65536
    hard: 65536

Результат:

  • исчезли повторные гигабайтные всплески RAM;
  • исчезли паузы по ~37 секунд на служебных вызовах entrypoint;
  • cold start пустой базы сократился примерно до 7 секунд;
  • рабочее потребление памяти стабилизировалось примерно на 170–180 МБ;
  • лимит памяти контейнера при этом не вводился и не изменялся;
  • nofile=65536 оставлен как постоянный workaround для mysql:5.7 в текущем Docker-окружении.
Разобраться почему на хеппибеби mysql много памяти сжирает

23 сент. 2026 г.

Доработка контактов в ИИ-чате: WhatsApp и MAX

В интерфейс ИИ-чата добавлен компактный блок связи с магазином через WhatsApp и MAX. Он ориентирован на потенциальных покупателей, которые пришли на сайт за конкретным товаром, но не нашли подходящую позицию в каталоге или хотят уточнить наличие, характеристики и возможные альтернативы.

Не весь ассортимент магазина представлен на сайте, поэтому теперь безрезультатный поиск не обязательно заканчивается уходом посетителя. После начала диалога пользователю предлагается напрямую связаться с сотрудниками магазина и получить помощь в подборе.

Как выглядит блок связи

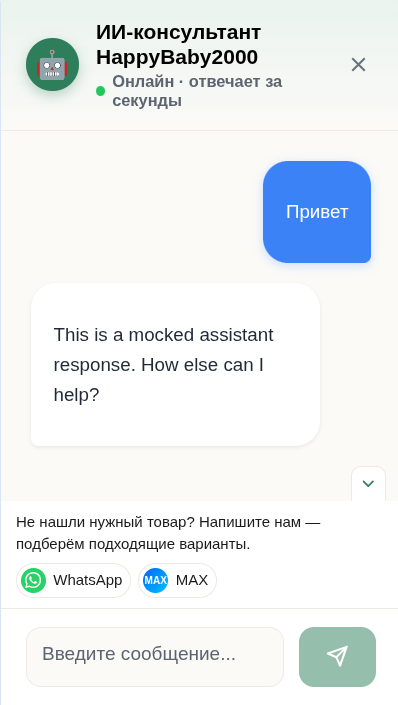
В раскрытом состоянии посетителю сразу доступны варианты связи с магазином. Блок расположен рядом с полем ввода сообщения, поэтому не нужно переходить на отдельную страницу контактов или самостоятельно искать номер телефона.

Контакты открыты

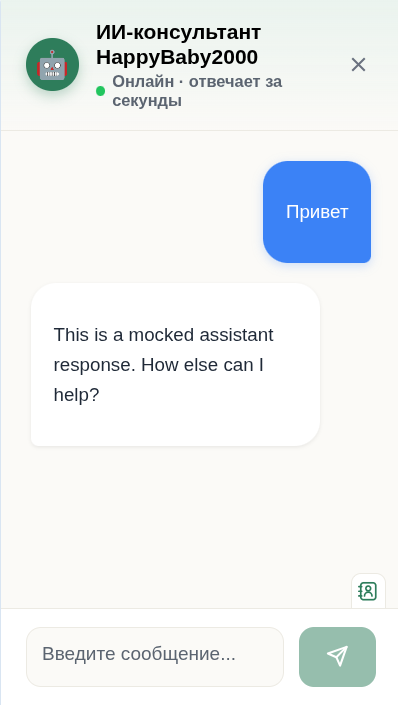
Если обращение к консультанту пока неактуально, блок можно свернуть. При этом доступ к контактам сохраняется и остаётся под рукой в интерфейсе чата.

Контакты закрыты

Что реализовано

  • добавлен компактный блок связи с сотрудниками магазина;
  • доступны быстрые переходы в WhatsApp и MAX;
  • блок появляется после начала диалога, когда пользователь уже вовлечён в поиск товара;
  • предложение можно свернуть, если связь с консультантом пока не нужна;
  • кнопка контактов остаётся доступной рядом с полем ввода;
  • оформление адаптировано под интерфейс чата: компактные иконки, читаемый текст и плавное раскрытие без перегрузки экрана.

Польза для потенциальных клиентов

Доработка закрывает важный коммерческий сценарий: посетитель ищет товар, не находит его в каталоге и вместо ухода с сайта получает понятный следующий шаг — уточнить наличие товара у консультанта, запросить аналог или получить персональную помощь в подборе.

Это особенно важно для товаров, которые могут быть в офлайн-ассортименте или на складе, но ещё не опубликованы на сайте. Для потенциального клиента путь становится короче и понятнее:

поиск товара → консультация → уточнение наличия → подбор подходящего варианта → потенциальная покупка.

SEO и коммерческий эффект

Функциональность усиливает коммерческую ценность поискового трафика по запросам, связанным с покупкой и подбором товаров. Посетители из поисковых систем получают не только каталог, но и прямой канал связи с магазином, если нужной позиции нет на странице.

Это помогает лучше отрабатывать запросы с высоким намерением к покупке — например, когда пользователь хочет купить товар, узнать наличие, подобрать аналог, уточнить цену или характеристики.

Ожидаемый эффект доработки — рост числа обращений из чата, снижение доли уходов после безрезультатного поиска по каталогу и увеличение числа потенциальных клиентов, которых можно довести до покупки через консультацию.

Проработать контакты в ИИ-чате

22 сент. 2026 г.

Перенос старого сайта на новый движок и унификация модели данных

Основная работа на этом этапе — не просто перенос отдельных страниц или ресурсов, а фактически пересборка старого сайта на новом движке haih-agent с окончательным отказом от старой структуры данных, которая исторически сложилась ещё во времена MODX.

Проблема здесь по сути такая же, как и при обновлении других старых сайтов: со временем вокруг первоначальной CMS накопилась собственная структура данных, множество шаблонов, TV-полей, специальных типов ресурсов и прикладной логики, завязанной на особенности старого движка. Поэтому обычного «обновления» приложения недостаточно — новый сайт нужно переносить архитектурно, сохраняя существующий контент, но избавляясь от старых технических ограничений.

Что было в старой версии

Изначально сайт работал на MODX, и значительная часть структуры базы данных до сих пор наследовала эту модель. Разные смысловые сущности существовали отдельно друг от друга и зачастую имели собственные шаблоны и наборы TV-полей.

В частности, отдельно существовали:

  • города;
  • компании;
  • бани и сауны;
  • отзывы;
  • статьи и публикации;
  • обычные ресурсы/страницы;
  • блоги и другие типы контента.

То есть различие между объектами было зафиксировано не только на уровне бизнес-смысла, но и на уровне самой структуры хранения: разные сущности, разные шаблоны, разные поля и отдельная логика работы с ними. Для MODX это было естественным способом организации сайта, но при развитии нового приложения такая схема только усложняет поддержку и заставляет переносить старые ограничения в новую архитектуру.

Переход на KbConcept

Сейчас сайт окончательно уходит от старой базы и старой модели сущностей. Для всех основных типов данных уже написаны и работают импортёры, которые переносят записи из старой базы в новую.

Ключевое архитектурное изменение состоит в том, что практически весь контент теперь приводится к одной базовой сущности — KbConcept. Семантическое различие между объектами определяется не отдельной таблицей или отдельным классом модели, а полем type.

Например:

  • city:default — город;
  • company:default — компания;
  • resource:default — обычная веб-страница;
  • review:company — отзыв о компании;
  • blog:default — публичный блог;
  • blog:personal — персональный блог;
  • topic:default — публикация.

Таким образом, вместо большого набора исторически разросшихся сущностей получается единая модель данных с понятной системой типов. Это заметно упрощает GraphQL-схему, фронтенд, повторное использование компонентов, выборки, импорт данных и дальнейшее развитие сайта.

При этом унификация не означает потери типизации. Наоборот, TypeScript позволяет поверх общего KbConcept достаточно строго описать конкретные подтипы и безопасно работать с ними в прикладном коде.

Типизация KbConcept через template literal types

Особенно удачно здесь пригодилась возможность TypeScript использовать шаблонные строковые литералы в типах (template literal types). Сейчас код типов выглядит так:

import { EnumValueConfigMap, SchemaTypes } from '@pothos/core'
import { KbConceptFragment } from 'src/gql/generated'

export const CustomKbConceptType = {
  City: {
    value: 'city:default',
    description: 'Город',
  },
  Company: {
    value: 'company:default',
    description: 'Компания',
  },
  ResourceDefault: {
    value: 'resource:default',
    description: 'Веб-страница',
  },
  ReviewCompany: {
    value: 'review:company',
    description: 'Отзыв о компании',
  },
  BlogDefault: {
    value: 'blog:default',
    description: 'Публичный блог',
  },
  BlogPersonal: {
    value: 'blog:personal',
    description: 'Персональный блог',
  },
  TopicDefault: {
    value: 'topic:default',
    description: 'Публикация',
  },
} as const satisfies EnumValueConfigMap<SchemaTypes>

export type MapItemCompany = KbConceptFragment & {
  type: `company:${string}`
  lat: number
  lng: number
}

export function isMapItemCompany(
  concept: KbConceptFragment,
): concept is MapItemCompany {
  return concept.type?.startsWith('company:') && concept.lat && concept.lng
    ? true
    : false
}

export type Company = KbConceptFragment & {
  type: `company:${string}`
}

export function isCompany(concept: KbConceptFragment): concept is Company {
  return concept.type?.startsWith('company:') ? true : false
}

export type City = KbConceptFragment & {
  type: `city:${string}`
}

export function isCity(concept: KbConceptFragment): concept is City {
  return concept.type?.startsWith('city:') ? true : false
}

export type ReviewCompany = KbConceptFragment & {
  type: typeof CustomKbConceptType.ReviewCompany.value
}

export function isReviewCompany(
  concept: KbConceptFragment,
): concept is ReviewCompany {
  return concept.type === CustomKbConceptType.ReviewCompany.value
}

Здесь есть несколько особенно полезных моментов.

as const satisfies ...

Конструкция:

} as const satisfies EnumValueConfigMap<SchemaTypes>

решает сразу две задачи.

as const не даёт TypeScript расширить значения вроде 'city:default' до общего типа string. В результате конкретные строки сохраняются как литеральные типы. Например, CustomKbConceptType.ReviewCompany.value имеет тип именно 'review:company', а не просто string.

При этом satisfies EnumValueConfigMap<SchemaTypes> проверяет, что весь объект соответствует контракту, ожидаемому Pothos, но не уничтожает точную информацию о литеральных значениях внутри объекта. Получается удобное сочетание строгой проверки структуры и максимально точного вывода типов.

Шаблонные литералы в типах

Самая интересная часть:

type: `company:${string}`

и аналогично:

type: `city:${string}`

Это позволяет выразить на уровне системы типов сам принцип устройства KbConcept.type: объект считается компанией не только при одном конкретном значении company:default, а при любом типе из пространства company:*.

Например, если в дальнейшем появятся company:premium, company:branch или другие специализированные варианты, тип Company уже сможет описывать их без создания отдельного union вручную.

То есть соглашение об именовании типов вида:

<группа>:<подтип>

становится не просто строковым соглашением в базе, а частью статической типизации приложения.

Type guards

Функции вида:

export function isCompany(concept: KbConceptFragment): concept is Company

являются пользовательскими type guard'ами. После проверки isCompany(concept) TypeScript уже знает, что внутри соответствующей ветки concept.type имеет форму company:${string}.

То же самое используется для городов и отзывов.

Отдельно полезен isMapItemCompany: он не только проверяет префикс company:, но и сужает объект до типа, в котором гарантированно доступны координаты lat и lng как числа. Благодаря этому код карты дальше работает не с «возможно компанией с возможно координатами», а уже с нормальным типизированным объектом карты.

Для точных специализированных вариантов можно использовать ещё более строгую проверку:

type: typeof CustomKbConceptType.ReviewCompany.value

Здесь тип ReviewCompany привязан непосредственно к значению из центрального объекта CustomKbConceptType. Если строковое значение типа будет изменено там, тип не придётся дублировать вручную в нескольких местах.

В итоге общая сущность KbConcept не превращает приложение в набор нетипизированных объектов. Наоборот, за счёт соглашения о type, template literal types и type guards получается сохранить удобство единой модели данных и одновременно получить строгую типизацию конкретных сценариев на фронтенде.

Импорт старых данных

На текущий момент импортёры старых сущностей уже написаны и работают. Импортированы основные данные, в том числе ресурсы, компании и связанные типы контента.

Это важный этап именно в контексте полного переезда: новая версия сайта уже не должна продолжать читать старую MODX-базу как основной источник данных. Старые сущности преобразуются в новую унифицированную модель и дальше приложение работает уже с новой базой и KbConcept.

Таким образом, задача постепенно перестаёт быть «новым интерфейсом поверх старого сайта» и становится полноценной миграцией на новую платформу.

Карта

Также перенесена карта с отображением компаний. Функциональность кластеризации маркеров сохранена: при большом количестве объектов близко расположенные точки объединяются в кластеры, а при изменении масштаба раскрываются в отдельные элементы.

Для карты как раз используется специализированный тип MapItemCompany, чтобы после фильтрации на уровне TypeScript были гарантированы и принадлежность концепта к company:*, и наличие координат.

Текущий результат

На данный момент:

  • новая архитектура сайта уже строится вокруг KbConcept;
  • основные старые сущности больше не требуют отдельных моделей в новом приложении;
  • написаны и работают импортёры данных из старой базы;
  • ресурсы, компании и другие основные сущности импортированы;
  • типы контента приведены к единой схеме <группа>:<подтип>;
  • на фронтенде добавлены type guards и строгая типизация конкретных разновидностей KbConcept;
  • перенесена карта;
  • восстановлена кластеризация объектов на карте.

Следующий этап — завершить оформление и довести визуальную часть нового сайта. После этого планируется публикация новой версии сайта и окончательный переход на неё.

Перенести сайт на haih-agent

20 сент. 2026 г.

Первичный рабочий результат

Реализован GraphQL-резолвер для локального вьетнамского TTS. Также сделана админская страница, которая даёт общую картину по буквам, сочетаниям, слогам и их значениям/озвучке.

То есть базовый технический контур уже работает: локальный синтез можно вызывать через API, а учебные единицы можно просматривать и проверять в одном интерфейсе.

До конечной пользовательской системы ещё потребуется доработка интерфейса, структуры данных, качества/валидации озвучек и самого учебного сценария, но первичный рабочий результат уже есть.

Исследовать и реализовать локальную TTS-озвучку через локальный сервер

20 сент. 2026 г.

Найден рабочий локальный вариант TTS

Локально в Docker поднят VieNeu-TTS, сейчас используется версия 2.

Главный практический результат: модель стабильно озвучивает одиночные вьетнамские графемы, включая формы с тоновыми знаками. Это закрывает ключевую проблему, из-за которой OpenRouter/Gemini не подходил для букваря: минимальные входы вроде одной буквы там давали HTTP 400 или нестабильный результат.

Проверен набор из 18 форм группы a / ă / â с шестью тонами (a á à ả ã ạ, ă ắ ằ ẳ ẵ ặ, â ấ ầ ẩ ẫ ậ). VieNeu-TTS умеет адресно генерировать такие единицы, поэтому его можно использовать как генератор фонетического словаря: графема/слог → сохранённый аудиофайл.

Следующий шаг — прогнать более широкий набор букв, слогов и коротких слов, проверить качество с носителями языка и затем подключить локальный генератор к постоянному хранилищу аудио, чтобы не синтезировать записи повторно при каждом воспроизведении.

Связанная родительская задача: «Разработать собственный пайплайн озвучки вьетнамского языка и словарь аудио».

Исследовать и реализовать локальную TTS-озвучку через локальный сервер

20 сент. 2026 г.

Полный промежуточный итог по TTS и локальной озвучке вьетнамского

Работа относится к задаче «Разработать собственный пайплайн озвучки вьетнамского языка и словарь аудио».

Исходная проблема

Изначально рассматривались browser speechSynthesis и затем генерация через OpenRouter + Google Gemini.

Browser speechSynthesis для вьетнамского оказался непригоден как базовый механизм курса: установка голоса непрозрачна, зависит от конкретного браузера/поставщика, может зависать на Downloading voices ..., а требовать от пользователя вручную устанавливать языковые голоса нельзя.

Далее был реализован TTS-пайплайн через OpenRouter. В целом он работает для обычного текста, но на минимальных входах обнаружилось критичное ограничение: при попытке озвучить одну отдельную букву OpenRouter/Gemini возвращает HTTP 400 или не даёт пригодного результата. Для обычного TTS это может быть допустимо, но для букваря — блокирующая проблема, потому что нам нужны отдельные буквы, графемы, короткие слоги и минимальные фонетические единицы.

Из-за этого была вынесена отдельная техническая ветка: «Исследовать и реализовать локальную TTS-озвучку через локальный сервер».


Переход к локальной генерации

Локально в Docker поднят проект VieNeu-TTS.

Пока используется версия 2, с которой уже были предыдущие эксперименты; существует и более новая версия 3.

Ключевой практический результат: VieNeu-TTS стабильно и чётко умеет озвучивать отдельные вьетнамские буквы/графемы. Это принципиально отличает его от текущего Gemini-пайплайна.

Почему это важно именно для букваря

Для вьетнамского нам нужен не просто универсальный «читатель текста», а генератор минимальных учебных единиц:

  • отдельные гласные;
  • отдельные графемы с тонами;
  • короткие слоги;
  • дифтонги/трифтонги;
  • минимальные контрасты;
  • отдельные слова;
  • затем короткие фразы.

То есть TTS должен поддерживать адресный запрос вида: «озвучь именно эту графему/слог», а не требовать контекста предложения.

На этом критерии VieNeu-TTS уже показывает существенное преимущество.

Теоретическая база по тому, какие именно единицы нужно уметь озвучивать, зафиксирована в концептах:

Пример: 18 форм группы A

Для базовой латинской формы a во вьетнамском есть три разные гласные:

  • a;
  • ă;
  • â.

Каждая из них может нести один из шести тонов, что даёт 18 письменных форм:

  • a á à ả ã ạ;
  • ă ắ ằ ẳ ẵ ặ;
  • â ấ ầ ẩ ẫ ậ.

VieNeu-TTS способен отдельно озвучивать такие минимальные единицы.

Для курса это означает естественную структуру:

графема → сохранённая аудиозапись.

После генерации каждый вариант можно сохранить в файловое хранилище и использовать повторно без обращения к TTS на каждом воспроизведении.

Акустическая ценность синтетического набора

По спектрограмме сгенерированного набора видно, что отдельные произнесения хорошо разделяются и обладают различимой внутренней структурой.

Для дальнейшего анализа полезно рассматривать 18 вариантов не как 18 полностью независимых классов, а как комбинацию двух факторов:

  1. качество гласного: a / ă / â;
  2. тон: ngang / sắc / huyền / hỏi / ngã / nặng.

Теоретически это позволяет анализировать признаки раздельно:

  • F1/F2 и длительность → какой гласный;
  • F0-контур, длительность, энергия, voicing и признаки фонации → какой тон;
  • затем объединять результат в конкретную графему.

Это может быть полезно не только для генерации, но и как основа синтетического ground truth для будущих экспериментов «звук → фонетические признаки/графема».

Почему VieNeu-TTS выглядит перспективно

Проект специализирован именно на вьетнамском языке, разработан во Вьетнаме и обучался на большом объёме вьетнамской речи. По имеющейся информации, версия 2 использовала более 10 000 часов вьетнамских записей.

Это не отменяет валидацию, но делает модель гораздо более релевантной для нашей задачи, чем универсальный мультиязычный TTS.

Валидация качества

Финальное качество отдельных звуков и тонов будет проверяться с носителями языка.

Проверять нужно прежде всего:

  • различимость тонов;
  • корректность hỏi/ngã;
  • краткость ă/â;
  • естественность отдельных букв/слогов вне контекста;
  • региональный акцент;
  • отсутствие артефактов на очень коротких входах.

Таким образом, архитектура доверия сейчас видится так:

VieNeu-TTS = основной локальный генератор кандидатов

носители языка = валидаторы качества

наша база = хранит подтверждённые/принятые аудиозаписи

Требования к этой части системы собраны также в концепте «Озвучка и аудиослой курса вьетнамского языка».

Архитектура хранения

Озвучку не нужно генерировать каждый раз.

Для каждой учебной единицы нужно хранить:

  • текст/графему/слог;
  • тип единицы;
  • аудиофайл;
  • движок и версию модели;
  • параметры генерации;
  • вариант произношения/диалект при необходимости;
  • статус проверки;
  • возможность перегенерации;
  • возможность заменить синтетическую запись живой записью носителя.

Статусы разумно оставить в духе:

  • generated;
  • needs_review;
  • approved;
  • rejected.

Текущий практический вывод

Для Vietnamguru локальный VieNeu-TTS сейчас выглядит намного более подходящим базовым механизмом для букваря, чем Google Gemini через OpenRouter, потому что он стабильно работает на минимальных входах и умеет озвучивать отдельные буквы/графемы.

Даже если позднее другой движок окажется качественнее на длинной речи, возможность надёжно синтезировать минимальные единицы — отдельный критичный критерий для нашего проекта.

Вся методическая рамка проекта собрана в концепте «Вьетнамский язык: система и методика изучения», а практическая разработка курса ведётся в задаче «Разработать систему изучения вьетнамского языка для взрослой аудитории».

Разработать собственный пайплайн озвучки вьетнамского языка и словарь аудио

20 сент. 2026 г.

Проблема с озвучкой одиночных букв через OpenRouter

Базовая механика TTS через OpenRouter в целом реализована и работает для обычных текстовых единиц. Однако обнаружена техническая проблема на минимальных входах: если отправлять на озвучку только одну букву, OpenRouter возвращает HTTP 400.

Для vietnamguru.ru это критично, поскольку букварю нужна отдельная озвучка букв, звуков и других очень коротких фонетических единиц.

Текущее решение

Не блокировать весь TTS-пайплайн из-за этого ограничения, а отдельно исследовать локальную генерацию через собственный локальный сервер и локальную TTS-модель. Цель — получить механизм, который стабильно принимает одиночные буквы/слоги и сохраняет результат в уже предусмотренный словарь аудио.

Связанная задача

Создана дочерняя задача «Исследовать и реализовать локальную TTS-озвучку через локальный сервер», taskId cmu90kv7v0wm0qw0qnov80p68.

В ней нужно подобрать и проверить локальную модель для вьетнамского, качество тонов и коротких единиц, API локального сервера, аппаратные требования и интеграцию с существующим хранением озвучек.

Разработать собственный пайплайн озвучки вьетнамского языка и словарь аудио

19 сент. 2026 г.

Первичное исследование озвучки вьетнамского

Проверен вариант использования browser speechSynthesis для озвучки курса. По результатам исследования использовать его как базовый механизм нельзя.

Что обнаружено

  • Вьетнамский голос не удаётся надёжно установить в браузер.
  • Доступный через Reading Mode путь крайне неудобен для обычного пользователя: открыть режим чтения → перейти в настройки → открыть языки → добавить вьетнамский.
  • После включения вьетнамского появляется Downloading voices ..., но загрузка может зависать бесконечно и фактически не завершаться.
  • Официальная документация не даёт понятной гарантии наличия и поддержки конкретного вьетнамского голоса.
  • В Chromium язык может быть заявлен в исходниках, но сам Chromium не поставляет конечные голосовые словари. Это зона ответственности конкретного браузерного/облачного поставщика, в нашем случае Google, и прозрачной гарантии наличия такого словаря нет.
  • Даже если установка сработает у разработчика, нельзя строить курс на требовании к пользователю самостоятельно ставить дополнительные голоса/словари.

Дополнительный риск

Разработчик не является носителем вьетнамского языка и не может самостоятельно гарантировать, что синтез корректно передаёт качество звуков и тонов. Поэтому финальное качество необходимо проверять с носителем языка.

Принятое решение

Перейти на собственный контролируемый пайплайн озвучки через OpenRouter + Google Gemini.

Озвучку не генерировать при каждом воспроизведении. Нужно завести постоянный словарь аудио: однажды сгенерировать букву/слог/слово/фразу, сохранить метаданные в БД и сам аудиофайл в файловом хранилище, после чего многократно переиспользовать готовую запись.

Также предусмотреть:

  • перегенерацию конкретной озвучки;
  • хранение версии модели и параметров генерации;
  • статусы проверки качества;
  • последующую проверку носителем языка;
  • при необходимости отдельные северные/южные варианты;
  • возможность вручную заменить синтетическую запись эталонной записью носителя.

Связанная задача

Создана дочерняя задача на проектирование и реализацию собственного TTS-пайплайна и словаря озвучек: «Разработать собственный пайплайн озвучки вьетнамского языка и словарь аудио», taskId cmu8uqhzc0we6qw0qlviqsm7q.

Первый целевой набор для генерации — букварь: базовые звуки, сочетания, тоны, дифтонги/трифтонги и примеры слов. После проверки качества тем же механизмом расширять озвучку на основной словарь курса.

Разработать систему изучения вьетнамского языка для взрослой аудитории

19 сент. 2026 г.

Разложена методика обучения вьетнамскому на родительскую задачу и четыре дочерних направления. Зафиксированы ключевые решения: взрослой аудитории сначала даётся обзорный букварь как карта системы звучания/письма; букварь остаётся постоянно доступным через отдельный корешок; основной учебный поток идёт через знакомые смыслы и реальные слова с возвратами в букварь; отдельная статья объясняет пользователю правила работы с курсом; слова должны быстро переходить в комбинации и продуктивные фразы, чтобы развивать экспромт, а не только узнавание.

Разработать систему изучения вьетнамского языка для взрослой аудитории

19 сент. 2026 г.

Усилена проверка og:image после ошибок Google

Google сообщил для части карточек ошибку «Недопустимый URL в поле image». Предполагаемая причина — исходные пути к изображениям содержали незакодированные кириллические символы и пробелы, которые прежняя проверка не выявляла.

Доработан скрипт agent/scripts/check-page-image/index.ts проекта happybaby2000.ru:

  • проверяется исходное значение og:image до какой-либо нормализации;
  • URL должен быть абсолютным HTTP(S)-адресом с хостом;
  • выявляются незакодированные пробелы, кириллица, управляющие и другие недопустимые символы;
  • проверяется корректность %-escape-последовательностей;
  • выявляются незакодированные квадратные скобки в path/query/fragment и повторный # во фрагменте, при этом IPv6 в квадратных скобках допускается;
  • проверяются все og:image на странице, а не только первый;
  • диагностика указывает номер изображения, исходный URL и причину ошибки; для недопустимых символов также выводятся Unicode-код и позиция;
  • при ошибках скрипт возвращает код 1, при успехе — 0.

Рядом добавлен постоянный тест agent/scripts/check-page-image/index.test.ts на Vitest. Конфигурация Vitest расширена на scripts/**/*.test.ts. Набор покрывает 28 сценариев, включая валидные и невалидные URL, encoded-символы, IPv6, отсутствие изображения, несколько og:image и точность диагностики.

Проверка проходит успешно: 28 тестов пройдены, ESLint, Prettier и git diff --check — без ошибок.

Команда теста:

npm run test -- scripts/check-page-image/index.test.ts

Ограничение проверки: она валидирует синтаксис URL из og:image, но не проверяет доступность самого изображения и не гарантирует принятие URL сервисами Google. Автоматического исправления URL скрипт не выполняет.

Настроить Open Graph / meta-теги для корректных превью страниц в мессенджерах

18 сент. 2026 г.

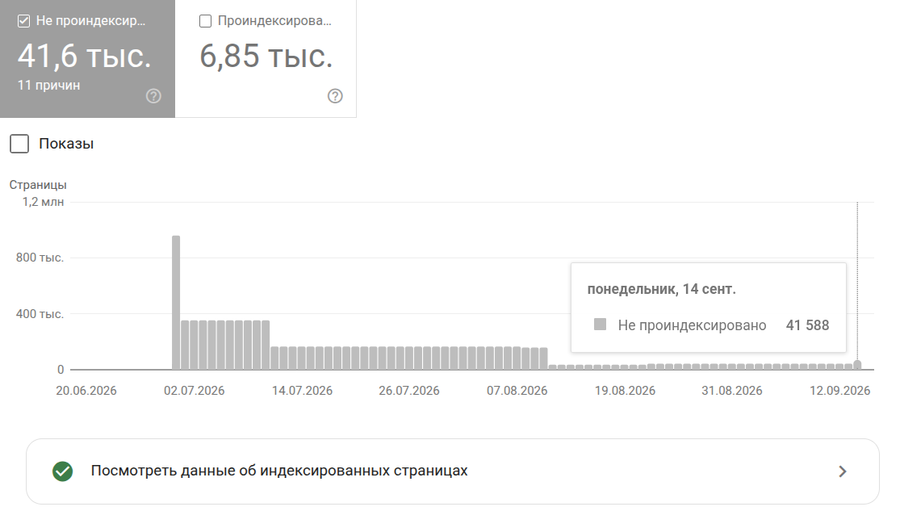
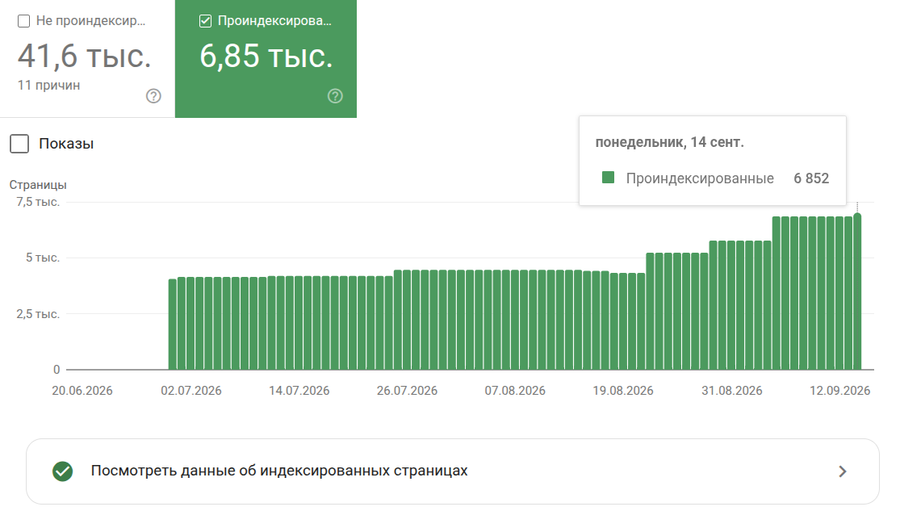
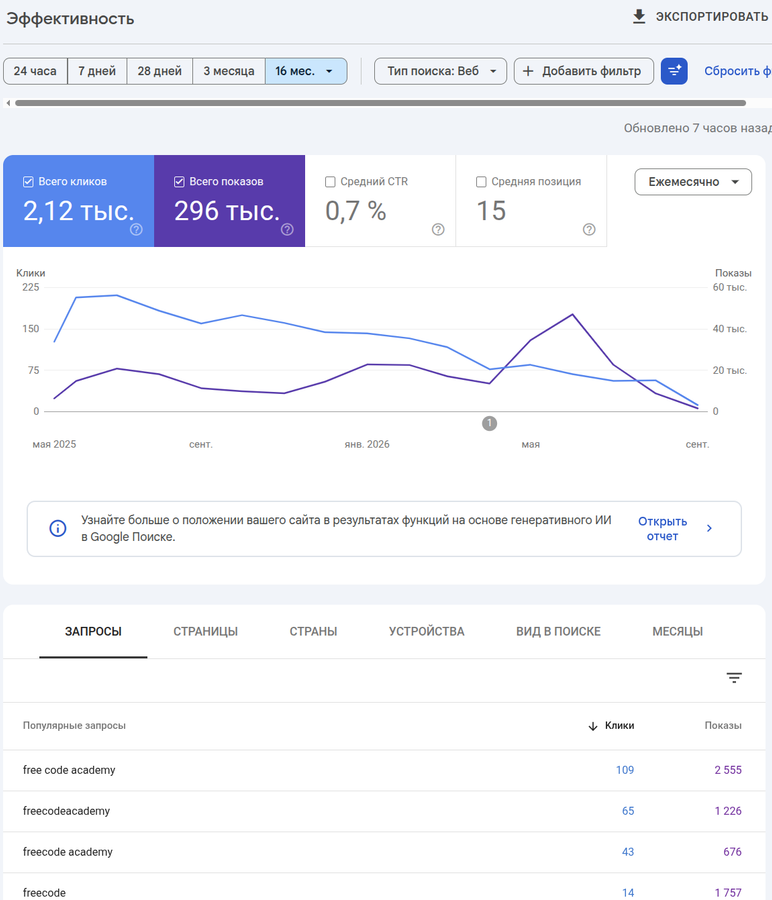
Количество непроиндексированных страниц продалжает падать

а проиндексированных растет

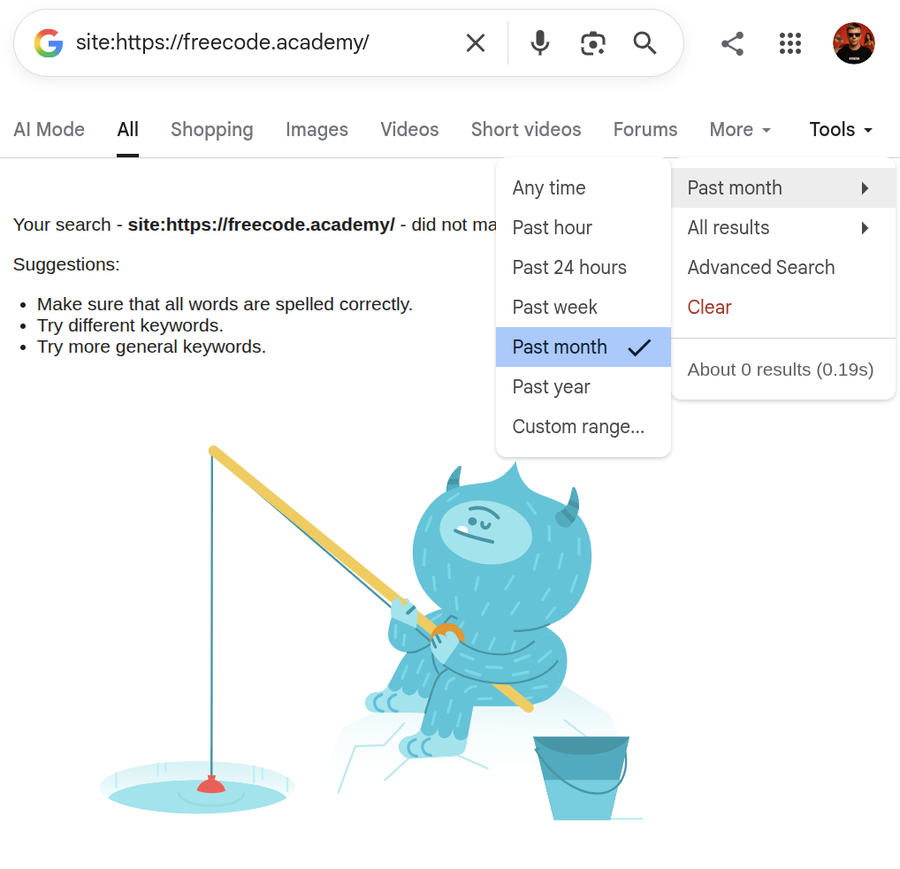
Но при этом, наружу гугл не выдал за месяц ни одной новой страницы

и это при том, что более 12 000 старых топиков и комментариев были переотформатированы, и еще как минимум несколько новых объемных статей написано.

Все больше и больше убеждаюсь, что гугл больше не делает ставку на старый поиск и индексацию интернета, еще и ресурсы все доступные переводит на AI mode. Зачем пылесосить интернет, когда можно просто генерировать ответы пользователям.

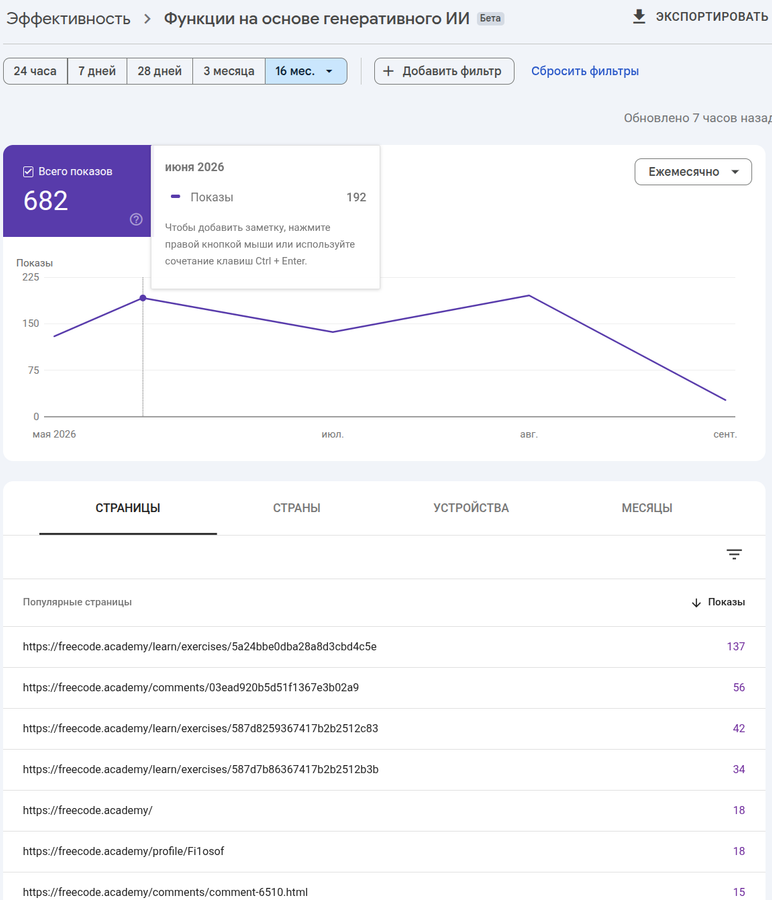
В то же время в генеративных ответах гугл использует сайт довольно активно

А вот количество кликов заметно падает, несмотря на растущее количество показов.

А чего им не падать, если теперь многие дальше выдачи AI Mode не проходят?

Я не жалуюсь, я просто подсвечиваю тренды.

Прокачать SEO/GEO

18 сент. 2026 г.

Функционал внедрён и опубликован.

В карточке сущности теперь доступны два независимых действия:

  • ? — открыть объяснение, что это такое / что означает сущность;
  • 🔊 — услышать, как она звучит / произносится.

Базовая карточка сохраняет текущую механику изучения письменной формы. Например:

🐶 → СОБАКА → СО-БА-КА → С-О-Б-А-К-А

Кнопки ? и 🔊 закрывают разные пробелы в знаниях: ребёнок может знать объект, но не знать его название; знать слово на слух, но не понимать его значение; либо не знать ни объект, ни название.

При открытии ? показывается расширенная карточка с текстовым описанием сущности. Описание не озвучивается автоматически: рядом с ним есть отдельная кнопка 🔊. При озвучивании текст визуально сопровождается по ходу речи, чтобы ребёнок мог сопоставлять звучащую речь с написанным текстом. Отдельные слова в описании также могут использоваться как самостоятельные элементы для озвучивания.

Таким образом новая механика позволяет ребёнку самостоятельно получать недостающий уровень информации и одновременно создаёт переход от уже существующей структуры слово → слоги → буквы к восприятию связного письменного текста как звучащей речи.

Внедрить универсальную механику «Что это?» и озвучивания сущностей

18 сент. 2026 г.

Зафиксирован ещё один кейс использования текущей механики.

Ссылку на сайт передали ещё одному человеку. Его первоначальное предположение было, что ребёнку материал, скорее всего, будет неинтересен. Тем не менее сайт дали ребёнку попробовать.

Фактическое поведение оказалось другим: ребёнок самостоятельно заинтересовался, начал активно взаимодействовать с сайтом и прошёл весь доступный материал. Интерес сохранялся до момента, когда занятие пришлось прервать из-за необходимости идти в школу.

Отдельно важно, что ребёнок уже свободно читает. То есть интерес к текущей механике в этом случае возник не только как средство первичного освоения чтения, но и у ребёнка, для которого само чтение уже не является новым навыком.

Проработать маркетинг и позиционирование

18 сент. 2026 г.

В ходе проработки второго уровня стало понятно, что исходная модель задачи была слишком узкой.

Изначально мы исходили из двух основных уровней:

  1. первый уровень — буквы, слоги и слова, который уже реализован через текущую механику;
  2. второй уровень — знаки препинания и построение предложений.

В процессе исследования выяснилось, что письменность значительно сложнее и включает гораздо больше уровней и взаимосвязанных областей. Для систематизации этой базы на «Учиться легко» был создан основной концепт «Теория письменности» и 12 связанных с ним концептов: грамматология и история письма, графемика, орфография, фонетика и фонология, морфемика, морфология, лексикология, синтаксис, пунктуация, семантика, лингвистика текста и дискурс, стилистика и типографика.

Основной концепт: https://учиться-легко.рф/teoriya/pismennost

Этот объём показывает, что теоретическая база проекта значительно шире, чем предполагалось изначально, и её дальнейшая проработка сама по себе является большой отдельной задачей.

Одновременно стала яснее ключевая проблематика второго уровня обучения.

На первом уровне ребёнок уже знает почти всё содержание, с которым работает система. Он видит знакомый объект на картинке, знает его смысл и звучание. Незнакомой для него является в основном письменная форма: слово, затем его слоги и буквы. Поэтому ребёнок может достаточно быстро установить связь между уже известным смыслом и новой записью.

На втором уровне ситуация принципиально сложнее. Знаки препинания и другие специальные знаки часто обозначают не знакомые ребёнку предметы или слова, а более абстрактные функции, отношения и структуры. В этом случае ребёнку может быть одновременно неизвестен и сам знак, и то, что именно он обозначает или делает.

Это резко увеличивает количество новых абстракций, которые необходимо освоить одновременно.

Поэтому проблема второго уровня заключается не просто в том, чтобы познакомить ребёнка с новыми знаками. Необходимо понять, как сделать их функции и смысл доступными для самостоятельного освоения без обязательного постоянного участия родителя или учителя.

На данном этапе зафиксирована именно эта проблема. Способ её решения ещё требует отдельного исследования.

Проработать второй уровень освоения письменности: чтение предложений и пунктуация

18 сент. 2026 г.

Результат

Задача по внедрению блога выполнена.

Фактический прогресс и затраты

На реализацию ушло как минимум на 5 часов больше, чем ожидалось.

Основная причина — ограничения lovable.dev: туда нельзя просто передать совершенно любой существующий проект без адаптации. Чтобы использовать Lovable для доработки визуальной части и затем переиспользовать результат в основном проекте, пришлось вручную перенести туда значительную часть собственных компонентов.

Это потянуло за собой дополнительную техническую работу:

  • перенос компонентов из текущего проекта в среду Lovable;
  • установка недостающих зависимостей;
  • адаптация окружения;
  • исправление большого количества ошибок типизации;
  • приведение перенесённых компонентов к состоянию, в котором их можно нормально дорабатывать и затем возвращать в основной проект.

Вывод

Эта дополнительная работа была дорогой по времени, но создаёт полезную инфраструктуру на будущее.

Теперь визуальные компоненты будет проще дорабатывать через lovable.dev, а затем переиспользовать в основном проекте. То есть значительная часть лишних затрат пришлась на разовую подготовку среды и компонентов, которая должна снизить стоимость последующих визуальных доработок.

Внедрить блог

17 сент. 2026 г.

Что уже сделано

Блог фактически запущен на уровне данных как представление существующих концептов через type, без введения отдельной технической сущности.

Подтверждён рабочий подход:

  • блоговые публикации создаются как обычные концепты;
  • для статей используется type: "blog:article";
  • контент статьи не содержит главный заголовок, так как он выводится отдельно из name;
  • статьи могут ссылаться друг на друга и на связанные концепты в Conceptica;
  • блог остаётся отдельным объясняющим/маркетинговым слоем и не должен быть обязательной точкой входа в продукт.

Первые опубликованные статьи

Перелинковка

Статьи связаны между собой по смыслу и ссылаются на релевантные концепты Conceptica, в том числе:

Таким образом, уже есть первый связанный кластер блогового контента вокруг чтения, письменности и общей логики обучения в «Учиться - Легко!».

Внедрить блог

17 сент. 2026 г.

Главное: наш маркетинг нельзя строить вокруг текущей механики чтения как вокруг продукта целиком.

Из всего обсуждения я вынесла несколько вещей.

Во-первых, наш настоящий продукт — не “карточки для чтения”. Это первый частный модуль внутри более общей идеи: мы проектируем обучение как систему и убираем из неё лишние этапы, опираясь на уже имеющиеся знания человека.

Во-вторых, маркетинг должен продавать не «методику ради методики», а результат от правильной декомпозиции обучения: человек быстрее входит в предмет, меньше тратит сил на лишнее, получает нужную помощь в нужный момент, осваивает новый уровень и открывает следующий.

В-третьих, у нас появляется сильная отличительная ценность: мы умеем видеть не только локальную тему, но и место навыка внутри всей области. Это важно, потому что обычное обучение часто оптимизирует отдельный этап и не отвечает на вопрос: какую долю пути к реальной цели он вообще закрывает.

В-четвёртых, бренд можно строить вокруг идеи инженерии обучения. Не «мы знаем лучше всех, как учить детей читать», а:

мы разбираем навык до сути, отделяем необходимое от привычного и строим короткий рабочий путь к результату.

В-пятых, это даёт широкий маркетинговый горизонт. Чтение, математика, программирование, физика и т.д. — не разрозненные продукты, а разные области, к которым применяется одна и та же инженерная рамка.

Если совсем коротко, то позиционирование я теперь вижу так:

«Учиться - Легко!» — это не очередной курс. Это платформа, где обучение проектируют от конечного навыка назад, убирая лишнее и используя уже имеющиеся знания человека.

А для текущего детского продукта — более приземлённо:

Ребёнок не учится “по программе”. Он осваивает следующий реально нужный уровень чтения, опираясь на то, что уже умеет.

И ещё важный маркетинговый вывод: нам не надо обещать “всё образование” на главной. Достаточно, чтобы за текущим продуктом уже читалась общая философия бренда. Тогда каждый новый модуль будет не расширением в сторону, а естественным продолжением одной и той же идеи.

Проработать маркетинг и позиционирование

Написать мне