Журнал разработки Николая Ланца

17 сент. 2026 г.

Зафиксирован отдельный концепт «Структура отдельного предмета обучения»: признаки предмета обучения, критерии освоения, зависимости, перенос, обратная связь и минимальное ядро проектирования цель → исходное состояние → необходимые зависимости → практика с обратной связью → проверка переноса. Концепт нужен как общий каркас для позиционирования «Учиться - Легко!» шире текущей механики чтения.

Проработать маркетинг и позиционирование

17 сент. 2026 г.

Сводка первых положительных сигналов по коммерческому MVP

На текущем этапе уже появились несколько устойчивых признаков того, что базовая механика продукта считывается правильно и вызывает нужное поведение.

Низкий порог входа

Продукт понятен практически без инструктажа. Пользователь может открыть страницу, увидеть карточки и сразу начать взаимодействовать с ними. Не требуется проходить onboarding, читать правила или понимать внутреннюю методику до первого полезного действия.

Это соответствует исходной идее продукта: вход должен быть максимально дешёвым, а любой доступный элемент интерфейса — осмысленным сам по себе.

Быстрое понимание механики

Первые внешние реакции показали, что смысл взаимодействия считывается за очень короткое время. Пользователь успевает открыть продукт, начать нажимать на элементы и понять, что здесь происходит, без дополнительных пояснений.

Важно, что после этого внимание переключается уже не на вопрос «что это такое?», а на само взаимодействие и второстепенные детали интерфейса. Это хороший признак того, что основная механика прозрачна.

Вовлечение возникает из самой механики

Есть ранний признак того, что взаимодействие само по себе удерживает внимание. Пользователь не просто понимает продукт, а продолжает исследовать его дальше.

Это особенно важно, потому что продукт не опирается на отдельный игровой слой, сложную систему наград или обязательный сценарий. Вовлечение возникает из возможности исследовать знакомые слова и получать мгновенную звуковую обратную связь.

Ребёнок не использует интерфейс как бессмысленную кнопку

Один из потенциальных рисков состоял в том, что ребёнок будет просто многократно нажимать на слова, слоги и буквы ради звука.

Первое наблюдение этого не подтвердило. Ребёнок сначала пытался прочитать самостоятельно и использовал озвучку как средство проверки собственной гипотезы, а не как самоцель.

То есть фактическая деятельность выглядит так:

попытка распознать → проверка через озвучку → сопоставление → переход дальше.

Это хорошо совпадает с задуманной ролью клика: не заменить чтение, а дать мгновенную обратную связь в момент сомнения.

Ребёнок быстро понимает интерфейс

Шестилетний ребёнок быстро разобрался, как пользоваться карточками, без сложного объяснения системы уровней. Это подтверждает, что одновременное присутствие слова, слогов и букв не обязательно создаёт перегрузку.

Ребёнок может сам выбирать, какой уровень использовать в конкретный момент.

Высокая естественная вовлечённость у ребёнка

После начала взаимодействия ребёнок не завершил сессию после нескольких карточек, а продолжал до тех пор, пока не прошёл весь доступный набор слов.

Это ранний положительный признак того, что сама форма исследования вызывает желание продолжать, даже без дополнительного сценария прохождения.

Продукт не требует жёсткого маршрута

Сильной стороной текущей реализации является отсутствие обязательной последовательности действий.

Можно начать со слова, слога, отдельной буквы или следующей карточки. Ошибка в порядке действий не приводит пользователя в тупик, потому что каждый элемент остаётся рабочей точкой входа.

Это отличает продукт от сценарных систем, где ценность раскрывается только при правильном прохождении заранее заданной последовательности.

Страница одновременно является продуктом

Коммерческая страница не отделена от пользовательского опыта. Пользователь не обязан сначала читать продающий текст, понимать преимущества и только затем переходить к обучению.

Основная механика доступна сразу, поэтому страница сама демонстрирует продукт через действие.

Для текущей модели распространения это особенно ценно: человек, пришедший по рекомендации, может практически мгновенно проверить продукт самостоятельно.

Простота не выглядит как недостаток

Текущий MVP использует одну основную механику, но она не воспринимается как незавершённая только из-за отсутствия большого числа режимов.

Наоборот, простота делает назначение продукта очевидным и снижает когнитивную нагрузку. Пользователю не нужно выбирать режим обучения, урок, уровень или сценарий до начала взаимодействия.

Отличительная продуктовая модель уже видна

Текущий продукт воспринимается не как последовательный курс, а как среда исследования.

В ней одновременно доступны:

  • знакомый образ;
  • слово целиком;
  • слоги;
  • отдельные буквы;
  • звучание каждого уровня.

Ребёнок получает доступ к целому слову сразу и при необходимости может исследовать его внутреннюю структуру.

Это хорошо согласуется с основной теорией проекта: использовать уже знакомое ребёнку слово, его смысл и звучание как опору для формирования визуальной связи с письменной формой.

Итоговое состояние на текущем этапе

У коммерческого MVP уже наблюдаются следующие положительные свойства:

  • понятность без предварительного обучения;
  • минимальный порог входа;
  • быстрый переход от открытия страницы к полезному действию;
  • самостоятельное освоение интерфейса ребёнком;
  • использование озвучки как проверки, а не как замены чтения;
  • естественная вовлечённость без дополнительного игрового слоя;
  • отсутствие зависимости от жёсткого сценария;
  • возможность начать взаимодействие из любого доступного уровня;
  • понятная связь между теорией проекта и реальной механикой;
  • продуктовая демонстрация прямо на основной странице;
  • отличимость от классического формата «курс → уроки → последовательное прохождение».

На текущем этапе это уже даёт основание считать, что базовая механика коммерческого MVP считывается пользователями так, как была задумана.

Проработать маркетинг и позиционирование

16 сент. 2026 г.

Прогресс: сначала исполнимая проверка, потом реализация

Перед внесением изменений сначала был написан отдельный терминальный TypeScript-скрипт, который делает HTTP-запрос к странице, парсит HTML через cheerio и проверяет обязательные Open Graph-теги. Это дало объективный baseline до начала правок и готовый критерий приёмки для ИИ-агента.

Проверочный скрипт

import * as cheerio from "cheerio";

const REQUIRED_TAGS = [
  "og:title",
  "og:description",
  "og:image",
  "og:url",
  "og:type",
] as const;

function isAbsoluteHttpUrl(value: string): boolean {
  try {
    const url = new URL(value);
    return url.protocol === "http:" || url.protocol === "https:";
  } catch {
    return false;
  }
}

async function main() {
  const targetUrl = process.argv[2];

  if (!targetUrl) {
    console.error("Usage: npx tsx check-open-graph.ts <url>");
    process.exit(2);
  }

  const response = await fetch(targetUrl, {
    redirect: "follow",
    headers: {
      "User-Agent": "OpenGraphChecker/1.0",
    },
  });

  if (!response.ok) {
    console.error(`HTTP ${response.status} ${response.statusText}`);
    process.exit(1);
  }

  const html = await response.text();
  const $ = cheerio.load(html);

  let hasErrors = false;

  console.log(`HTTP: ${response.status}\n`);

  const values = Object.fromEntries(
    REQUIRED_TAGS.map((property) => {
      const value =
        $(`meta[property="${property}"]`).first().attr("content")?.trim() ?? "";

      if (!value) {
        console.log(`✗ ${property}: missing`);
        hasErrors = true;
      } else {
        console.log(`✓ ${property}: ${value}`);
      }

      return [property, value];
    }),
  );

  const image = values["og:image"];
  const ogUrl = values["og:url"];

  if (image && !isAbsoluteHttpUrl(image)) {
    console.log(`✗ og:image is not absolute: ${image}`);
    hasErrors = true;
  }

  if (ogUrl && !isAbsoluteHttpUrl(ogUrl)) {
    console.log(`✗ og:url is not absolute: ${ogUrl}`);
    hasErrors = true;
  }

  console.log(
    hasErrors
      ? "\nRESULT: invalid or incomplete"
      : "\nRESULT: OK",
  );

  process.exit(hasErrors ? 1 : 0);
}

main().catch((error) => {
  console.error(error);
  process.exit(1);
});

Состояние до реализации

Первый запуск дал ожидаемо отрицательный результат:

HTTP: 200

✗ og:title: missing
✗ og:description: missing
✗ og:image: missing
✗ og:url: missing
✗ og:type: missing

RESULT: invalid or incomplete

После этого задача была передана ИИ-агенту уже не в абстрактной формулировке «добавить Open Graph», а вместе с конкретным скриптом проверки и воспроизводимым способом проверить результат.

Отчёт агента

Агент сообщил о следующих изменениях:

Готово. Изменения:

index.tsx — добавлены props image и ogType, выводятся og:title, og:description, og:image, og:url, og:type
index.tsx — вычисляется imageUrl и передаётся в SeoHeaders с ogType="product"
Можешь проверить скриптом:

npx tsx scripts/check-page-image/index.ts "http://localhost:3000/catalog/product.html"

Повторная проверка

После изменений тот же проверочный подход дал:

HTTP: 200

✓ og:title: Мелкогабаритная площадка Корабль
✓ og:description: Размер 3.48 х 1.78 х 2.32 м.
✓ og:image: http://localhost:3000/images/resized/middle/images/img.jpg
✓ og:url: http://localhost:3000/catalog/product.html
✓ og:type: product

RESULT: OK

Практический вывод

Подход оказался полезным: сначала создаётся маленькая исполнимая проверка, фиксирующая текущее состояние и критерий готовности, а затем эта же проверка передаётся исполнителю вместе с задачей. Это уменьшает неоднозначность постановки и делает результат проверяемым не по отчёту агента, а по фактическому поведению системы.

Следующий шаг — усиливать этот шаблон: если агенту даётся проверочный скрипт, в постановке сразу требовать не только внести изменения, но и самостоятельно запустить этот скрипт после реализации и приложить фактический результат. Тогда цикл становится замкнутым: reproduce → implement → verify, а человеку остаётся уже контрольная, а не первичная проверка.

Настроить Open Graph / meta-теги для корректных превью страниц в мессенджерах

16 сент. 2026 г.

Особенность Web Speech API на iPhone

При проверке озвучки на iPhone выяснилась занятная особенность: и Safari, и Chrome фактически используют один и тот же системный голосовой движок iOS.

Для одиночных заглавных букв он ведёт себя крайне неудачно для учебного сценария: вместо самой буквы/её обычного произношения проговаривает фразу вида «Заглавная буква Б».

Для карточек с буквами это ломает механику, поэтому перед отправкой текста в TTS пришлось нормализовать его в нижний регистр.

Практический вывод: визуальное представление и строка, отправляемая в speechSynthesis, не обязаны совпадать. На экране буква может оставаться заглавной, а в TTS передаваться её lowercase-вариант.

Добавить браузерную озвучку букв, слогов и отдельных слов

16 сент. 2026 г.

Прогресс: ограничения и странности браузерного SpeechSynthesis

Проверена встроенная браузерная озвучка на отдельных словах, слогах и буквах. Для целых слов API в ряде случаев работает приемлемо, но на коротких слогах и отдельных буквах проявляются заметные и непредсказуемые ошибки интерпретации текста.

Что звучит нормально

  • Собака — произносится нормально.
  • Ры — произносится нормально.
  • Свинья — произносится нормально.
  • Пель — неожиданно произносится нормально.

Наблюдаемые сбои

  • Со — звучит примерно как просто С.
  • Р — звучит скорее как Э.
  • Ре — тоже звучит примерно как Э.
  • Свинь — вместо слога начинает читать как названия букв: примерно Эс Вэ Ен Мягкий знак. При этом И и Н отдельно не проговариваются ожидаемо, а часть последовательности интерпретируется как Ен.
  • Ковь — тоже разваливается на чтение по буквам.
  • Солн — также читается по буквам/не как слог.
  • Ко — звучит как Ка.
  • Ар — звучит как А.
  • Де — звучит как Дэ.

Основной вывод

SpeechSynthesisUtterance хорошо подходит для обычных слов и фраз, но не гарантирует корректное произношение искусственно выделенных слогов и отдельных букв.

TTS-движок пытается интерпретировать короткую строку как естественный текст, название буквы, аббревиатуру или неизвестную лексему. Поэтому одинаковая последовательность символов может озвучиваться по-разному в зависимости от длины и контекста.

Особенно проблемны:

  • одиночные согласные;
  • короткие слоги из 2 букв;
  • слоги с ь;
  • обрезанные части слова, которые не являются самостоятельными лексемами;
  • сочетания, похожие на буквенные сокращения.

Практическое следствие

Нельзя считать браузерный TTS универсальным источником правильного произношения для учебной механики буква → слог → слово.

Для целых слов его можно использовать напрямую, но для букв и слогов потребуется один из вариантов:

  1. ручные исключения / словарь альтернативных строк для конкретного TTS;
  2. предварительно записанные аудиофайлы;
  3. отдельный TTS/SSML-движок с более управляемым произношением;
  4. гибрид: слова через браузерный TTS, проблемные буквы/слоги — через подготовленное аудио.

Важно

Эти наблюдения относятся к фактическому поведению текущего браузерного/системного голоса. На другой ОС, браузере или другом SpeechSynthesisVoice результат может отличаться, поэтому подобные исключения нельзя считать универсальными для всех устройств.

Добавить браузерную озвучку букв, слогов и отдельных слов

15 сент. 2026 г.

Промежуточный итог: текущий эксперимент провален

На текущем этапе ни один из реализованных/предложенных сенсоров не дал хоть сколько-нибудь полезной, визуально устойчивой или интерпретируемой информации для различения речевых звуков.

Это важно зафиксировать как отрицательный результат, а не пытаться «дожимать» эксперимент оптимистичными эвристиками.

Что пробовали

Обсуждались и/или предлагались сенсоры по временной области:

  • RMS / средняя энергия;
  • peak amplitude;
  • zero crossing rate;
  • mean |Δx|;
  • max |Δx|;
  • autocorrelation / periodicity;
  • pitch estimate.

Затем была попытка построить грубый sibilanceSensor для С/Ш через:

  • высокочастотную энергию;
  • spectral centroid;
  • разделение энергии ниже/выше условной границы;
  • spectral concentration.

После этого предложен грубый frequency-band sensor с 12 логарифмическими полосами примерно от 60 Hz до 14 kHz.

Практический результат: никакой из этих подходов пока не показал даже приблизительно полезной картины, которая позволяла бы уверенно сказать, что измерения отражают различия между известными произнесёнными звуками.


Основные причины провала

1. ИИ слишком рано начал «проектировать решение» вместо измерительного эксперимента

Главная ошибка — преждевременный переход от вопроса «что мы реально видим в данных?» к вопросу «какой сенсор должен детектить С/Ш?».

В результате появились эвристики вроде условной границы 5.5 kHz, sibilance-presence, набора заранее выбранных frequency bands и ожидаемых графиков до того, как была получена хоть одна подтверждающая серия реальных измерений.

Это повторяет уже наблюдавшуюся проблему: код выглядит правдоподобно, но основание под ним не доказано экспериментом.

2. Признаки сами по себе измеримы, но их диагностическая ценность не доказана

RMS, ZCR, |Δx|, autocorrelation и спектральные метрики действительно вычисляются корректно как свойства waveform. Но из этого не следует, что они полезны для различения фонем/механизмов речи в конкретной записи.

Например два разных звука могут иметь очень похожие RMS/ZCR, а один и тот же звук — сильно менять эти значения в зависимости от громкости, расстояния до микрофона и контекста.

3. Нормализация может уничтожать именно ту информацию, которую мы пытаемся увидеть

Попытка в каждом кадре нормализовать band energies так, чтобы сумма была около 1, делает удобной визуализацию спектрального распределения, но одновременно удаляет абсолютную информацию об интенсивности.

Для сравнения сибилянтов и несибилянтов абсолютная шумовая энергия сама может быть важным признаком.

Нельзя заранее решать, какие компоненты сигнала являются «мешающим масштабом», пока мы не проверили их экспериментально.

4. Слишком грубые временные окна

Фиксированное окно 20–40 ms удобно технически, но разные речевые механизмы живут на разных масштабах:

  • burst может занимать считанные миллисекунды;
  • pitch требует нескольких периодов;
  • формантные структуры требуют другого компромисса;
  • устойчивый фрикативный шум может длиться сотни миллисекунд.

Один масштаб окна неизбежно скрывает часть событий.

5. Слишком грубые частотные полосы

12 полос типа 2.5–4 kHz, 4–6.3 kHz, 6.3–10 kHz могут быть настолько широкими, что реальные локальные спектральные различия внутри них просто исчезают.

При этом переход сразу к десяткам полос без доказанной пользы тоже создаст только больше данных, а не больше понимания.

6. Нет эталонной экспериментальной процедуры

Пока отсутствует строгий набор сравнительных записей:

  • одинаковый микрофон;
  • одинаковое расстояние;
  • одинаковая громкость;
  • несколько повторов одного звука;
  • несколько разных звуков;
  • сохранённые исходные PCM;
  • одинаковая обработка;
  • возможность наложить/сравнить метрики между повторами.

Без этого невозможно отличить устойчивый признак фонемы от случайной вариации записи.

7. Пока анализируется «одна запись», а не статистика повторов

Один график почти ничего не доказывает.

Нужно минимум несколько повторов каждого класса и сравнение распределений признаков:

  • внутриклассовая вариативность;
  • межклассовое расстояние;
  • устойчивость во времени;
  • чувствительность к громкости и микрофону.

Если разброс одного и того же звука больше, чем разница между двумя звуками, сенсор бесполезен для нашей задачи.

8. Слишком ранняя привязка к буквам

С, Ш, Ф — полезные тестовые классы, но сенсор не должен начинаться с предположения о букве.

Правильнее сначала находить объективные различия между наборами записей, а потом уже смотреть, чему они соответствуют артикуляционно и фонетически.

9. Возможные проблемы с самим исходным audioData

До дальнейших выводов необходимо отдельно проверить:

  • что именно содержит audioData;
  • действительно ли это PCM с микрофона;
  • тип данных (Uint8, Float32, другое);
  • корректный center/DC offset;
  • реальный sampleRate;
  • нет ли до анализа браузерной/микрофонной обработки: AGC, noise suppression, echo cancellation;
  • не является ли audioData уже результатом AnalyserNode с ограниченной/изменённой семантикой.

Если входной сигнал уже автоматически нормализуется или фильтруется браузером, это может полностью менять наблюдаемые признаки.

10. Визуализация тоже может скрывать различия

Если каждый sensor сам выбирает normalized 0..1, визуально любые маленькие различия могут выглядеть значительными, а большие абсолютные различия — одинаково.

Для исследовательского инструмента первичными должны быть сырые значения с единицами измерения, а визуальная нормализация должна быть отдельным, прозрачным слоем.


Что считаем правильным следующим шагом

Не писать очередной «умный сенсор».

Сначала построить минимальную экспериментальную инфраструктуру:

  1. сохранять несколько коротких сырых записей с известной меткой;
  2. гарантированно знать формат PCM и sampleRate;
  3. уметь рисовать сам waveform без преобразований;
  4. уметь строить обычную подробную спектрограмму/STFT без попытки классификации;
  5. сравнивать несколько повторов одного звука рядом;
  6. только после визуального обнаружения устойчивого различия выделять его в отдельный sensor-helper;
  7. оценивать sensor по статистике повторов, а не по одному удачному графику.

Главный вывод текущего этапа:

пока нет оснований утверждать, что предложенные сенсоры дают полезную информацию для распознавания звуков. Эксперимент нужно вернуть на более низкий уровень: сначала честно наблюдать waveform и спектр реальных записей, затем извлекать только те метрики, полезность которых подтверждена повторяемыми данными.

Исследовать измеримые признаки речевого сигнала до построения нового синтезатора

15 сент. 2026 г.

Краткий прогресс: текущую реализацию требуется переписать с нуля

Фактическая проверка показала, что текущий компонент нельзя считать пригодной основой для дальнейших экспериментов со звуком.

Основные проблемы:

  • Аудиоархитектура принципиально не подходит для качественного синтеза. Параметры порциями обновляются через Web Audio nodes во время воспроизведения, тогда как для контролируемого экспериментального синтеза логичнее заранее вычислять PCM/массив sample-значений по всей временной логике и уже готовый буфер отдавать AudioContext на воспроизведение.
  • Текущий DSP сам по себе устроен неудачно: sawtooth проходит через три последовательно включённых узких bandpass-formant фильтра, что почти уничтожает периодическую часть; шум при этом идёт отдельным прямым трактом.
  • UI timeline и audio timeline фактически имеют разные часы. Loop, seek, pause/play и реальное аудиовремя не являются одной state machine.
  • Управление звуком через requestAnimationFrame (~60 Hz) непригодно для коротких акустических событий, burst и быстрых переходов; дополнительное сглаживание ещё сильнее размывает события.
  • Lifecycle аудиоисточников содержит race conditions и несогласованные состояния: повторный Play работает нестабильно, Stop способен приводить к неожиданному возобновлению звука, старые callbacks/source refs могут переживать смену состояния.
  • В UI/UX слишком много независимых refs/states/hooks, отвечающих за части одного playback-состояния. Вместо этого нужен единый useReducer/finite state machine с явными состояниями stopped/playing/paused и детерминированными переходами.
  • Отчёт о реализации оказался значительно оптимистичнее фактического поведения: интерфейс визуально выглядит как готовая лаборатория, но базовые пользовательские сценарии Play/Stop/Replay и сами звуковые результаты ненадёжны.

Вывод: точечное исправление текущей реализации нецелесообразно. Компонент нужно переписать с нуля, сохранив только общую идею визуальной лаборатории: timeline, дорожки параметров, keyframes, loop и ручной поиск звучаний. Новая версия должна строиться вокруг единой машины состояния и предварительного вычисления аудиобуфера из сценария.

Создать визуальную лабораторию временных сценариев VoiceSynthesizer

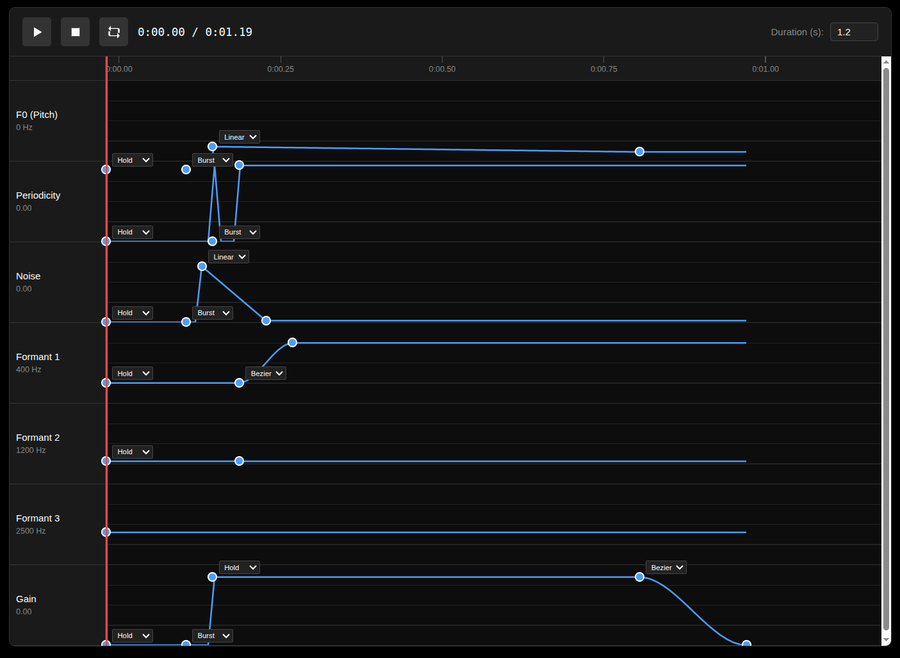
15 сент. 2026 г.

Подробный прогресс по визуальной лаборатории временных сценариев

Что уже реализовано

Создан отдельный новый экспериментальный синтезатор и визуальный редактор, намеренно не связанный с прежним VoiceSynthesizer и его накопившейся сложной DSP-моделью.

Это важное архитектурное решение было сделано сознательно: цель текущего этапа — не сохранять совместимость со старыми сценариями и не воспроизводить прошлые эксперименты, а получить максимально чистый лабораторный стенд для ручного исследования звука.

Текущая структура включает:

  • многодорожечный редактор временных параметров;
  • keyframe-точки на общей временной шкале;
  • drag-and-drop по времени и по значению;
  • Play / Pause / Stop;
  • режим Loop;
  • независимую общую длительность сценария;
  • seek по timeline;
  • отображение текущих значений параметров;
  • типы переходов hold, linear, bezier, sine, burst, noise;
  • отдельный новый аудиосинтез на Web Audio API;
  • минимальную акустическую модель на базе sawtooth + noise + formant filters + gain.

В UI сейчас представлены основные экспериментальные дорожки:

  • F0 / Pitch;
  • Periodicity;
  • Noise;
  • Formant 1;
  • Formant 2;
  • Formant 3;
  • Gain.

Интерфейс визуально получился удачным как лабораторный инструмент: временная ось читается, события видны, параметры можно быстро менять, а общая длительность не привязана к последней точке. Это позволяет строить длинные удерживаемые звуки и последовательности состояний.

Важное уточнение постановки

Новый редактор НЕ должен сейчас быть интерфейсом к старому DSP.

Он задуман как независимый чистый эксперимент:

простые источники + простые фильтры + временные траектории -> слышимый результат.

Основной исследовательский вопрос:

Можно ли вообще вручную, методом контролируемого перебора и прослушивания, найти хоть какие-то узнаваемые речеподобные звуки?

То есть текущая задача — не воспроизводимость старых VoiceScenario, а поиск самой минимальной работающей акустической модели.

Почему выбран отдельный новый синтезатор

Предыдущая ветка синтеза накопила много взаимозависимых экспериментов и параметров. Сейчас сложно понять, где именно ошибка, и изменение одного механизма легко может сломать другой.

Поэтому чистый стенд нужен как контролируемая среда, где каждый новый механизм добавляется осознанно и его эффект можно услышать отдельно.

Принцип дальнейшей работы:

минимальный движок -> ручной поиск -> наблюдение -> обнаружение недостающего механизма -> добавить только его -> повторить эксперимент.

Что показала первая практическая проверка

По словам разработавшего агента набор возможностей выглядит завершённым, но фактическая проверка результата показала, что отчёт был слишком оптимистичным.

На текущем этапе:

  • большинство подготовленных звуков/пресетов практически не слышны или не дают ожидаемого результата;
  • отчёт агента сам по себе нельзя считать доказательством работоспособности;
  • из простых узнаваемых эффектов пока фактически слышен в основном шипящий звук, близкий к С;
  • полноценные А, М, Р, Т и другие звуки ещё не получены вручную и не подтверждены слухом.

Это не считается провалом эксперимента. Напротив, стенд теперь позволяет выяснять, какие именно механизмы минимально необходимы для появления конкретных классов звуков.

Текущая практическая ценность лаборатории

Практическая ценность редактора пока не доказана окончательно.

Сейчас проверяется более базовая вещь:

  1. Есть ли слышимая причинная связь между конкретным параметром и результатом.
  2. Можно ли двигая одну или несколько точек вручную получать предсказуемо меняющееся звучание.
  3. Можно ли найти устойчивые акустические классы:
    • гласноподобный;
    • шумовой/фрикативный;
    • взрывной;
    • носовой;
    • периодический/дрожащий;
    • другие речеподобные классы.
  4. Можно ли сохранить найденную конфигурацию как воспроизводимый рецепт.

Если эти пункты подтверждаются, лаборатория уже полезна как исследовательский инструмент, даже если качество звука пока далеко от человеческой речи.

Важный концептуальный вывод

Не нужно заранее строить сложную физиологическую модель речи.

Правильнее сначала искать минимальные акустические механизмы вручную.

Например:

  • если Р невозможно получить без периодического модулятора, это станет экспериментальным основанием добавить такой механизм;
  • если Т требует последовательности silence -> burst -> noise tail, это тоже должно вытекать из ручного эксперимента;
  • если определённый тип гласного требует устойчивого F0 + F1/F2/F3, это должно быть найдено и подтверждено слухом.

То есть новые возможности добавляются не по предположению, а по наблюдаемому дефициту текущей модели.

Текущие ограничения и вопросы

  1. Нужно проверить каждый существующий control отдельно и в минимальных комбинациях.
  2. Нужно понять, какие из текущих transition types реально полезны, а какие пока декоративны.
  3. burst, sine, повторяющиеся колебания и шумовые модуляции концептуально могут оказаться не просто интерполяциями, а отдельным классом временных модуляторов. Возможно, позже стоит разделить:
    • envelope / keyframes;
    • modulators поверх базовой траектории.
  4. Нужно проверить, насколько корректно организованы физические диапазоны параметров и их нулевые состояния.
  5. Нужно добавить удобное сохранение удачных звучаний и сценариев, когда появятся действительно интересные результаты.
  6. Спектрограмма и другие способы анализа результата могут понадобиться позже, но сейчас приоритет — слуховой ручной поиск и причинная понятность интерфейса.

Критерий ближайшего успеха

Не «синтезатор уже умеет говорить» и не «пресеты совпадают с буквами».

Ближайший критерий успеха намного проще:

Пользователь может включить Loop, двигать keyframe-точку или параметр, слышать несколько вариантов подряд и устойчиво находить хотя бы некоторые узнаваемые речеподобные звучания, понимая, какое изменение к ним привело.

После нахождения интересных звучаний сценарий и логи будут использоваться для последующего анализа и для принятия решений о том, какие новые механизмы действительно стоит добавлять.

Создать визуальную лабораторию временных сценариев VoiceSynthesizer

15 сент. 2026 г.

Промежуточные выводы по временной причинности и наблюдаемости параметров

Проведены одиночные эксперименты по VoiceControlState -> DSP -> acoustic features для всех основных управляющих параметров.

Что показали эксперименты

При одиночном sweep, когда изменяется только один control при фиксированных остальных, многие параметры дают сильную корреляцию с наблюдаемыми акустическими признаками.

Наиболее выраженные результаты:

  • sourceLevel сильно связан с peak, rms, величиной спектрального пика;
  • periodicity также сильно отражается в peak/rms, но эти признаки совпадают с амплитудными controls;
  • f0Hz хорошо проявляется через pitch-related признаки, ZCR и распределение высокочастотной энергии;
  • resonance1Freq хорошо проявляется через положение первого спектрального пика;
  • resonance2Freq проявляется через rolloff/formant-related признаки;
  • resonance*Gain хорошо наблюдаются через амплитудные признаки;
  • outputLevel практически идеально отражается в peak/rms.

При этом noiseLevel, glottal-параметры, bandwidth-параметры и resonance3Freq текущим набором признаков наблюдаются значительно хуже.

Важная коррекция интерпретации

Высокая корреляция в одиночном sweep НЕ означает прямую восстанавливаемость параметра.

Нужно различать:

  1. Sensitivity — меняется ли наблюдаемый признак, когда мы изменяем control.
  2. Identifiability — можно ли по наблюдаемому звуку понять, что изменился именно этот control, а не другой.

Например:

  • sourceLevel, outputLevel и resonanceGain все сильно меняют rms/peak;
  • periodicity в текущем эксперименте тоже сильно влияет на те же амплитудные признаки.

Следовательно, эти controls чувствительны и наблюдаемы, но пока не доказано, что они различимы между собой в реальном сценарии, где несколько параметров изменяются одновременно.

Текущее разбиение controls по характеру наблюдаемости

1. Частотные координаты — наиболее перспективны для прямого восстановления:

  • f0Hz;
  • resonance1Freq;
  • resonance2Freq;
  • потенциально resonance3Freq после улучшения спектрального анализа.

Они меняют не только общую энергию, но и структуру спектра.

2. Амплитудные/масштабирующие controls — наблюдаемы, но смешиваются:

  • sourceLevel;
  • outputLevel;
  • resonance1Gain;
  • resonance2Gain;
  • resonance3Gain;
  • частично periodicity.

Для них требуется совместное восстановление или дополнительные признаки, потому что похожий эффект может достигаться разными комбинациями параметров.

3. Формообразующие controls — текущий лог видит плохо:

  • glottalOpenPhase;
  • glottalReturnPhase;
  • resonance*Bandwidth;
  • noiseLevel;
  • частично resonance3Freq.

Для них, вероятно, нужны признаки формы периода, spectral envelope, harmonic/noise structure, LPC или иные более специализированные измерения.

Временные выводы

Во всех одиночных экспериментах реакция обнаруживалась практически сразу (~0.2 ms), а окно 20 ms оказалось достаточным для текущего набора признаков. Однако одинаковый лаг для всех параметров, вероятно, отражает прежде всего разрешение методики измерения и временную привязку окон, а не реальную физическую константу DSP.

Отдельно обнаружена длительная память резонаторов (~250 ms в текущем эксперименте). Эту величину нельзя пока считать универсальной: время затухания должно зависеть от frequency/bandwidth/Q и требует отдельного sweep по параметрам резонатора.

Что стало ясно про саму задачу decoder

Сценарий и акустический лог находятся на разных уровнях представления:

VoiceControlState -> внутреннее DSP-состояние -> waveform -> spectrum/features.

Управляющие параметры могут почти не меняться во времени, но порождать сложный высокочастотный waveform. Поэтому control-график не должен быть похож на график акустических признаков.

Для восстановления параметров нужно исследовать не соответствие одного control одному feature, а отображение:

vector(features over a time window) -> vector(controls).

Следующий принципиальный эксперимент должен проверять одновременные изменения нескольких controls. Именно он покажет реальную идентифицируемость, а не только чувствительность.

Практический вывод

Одиночные sweeps уже ответили на вопрос: «реагирует ли звук на конкретный control и какими признаками это видно?».

Следующий вопрос: «можем ли мы отличить изменение одного control от другого, когда они действуют одновременно?».

Также исследования показывают, что для дальнейшей работы нужен удобный интерактивный временной редактор: не для редактирования уже найденных JSON-сценариев, а как лаборатория ручного поиска звучаний и причинных связей между временными траекториями параметров и результатом.

Исследовать временную причинность VoiceControlState → DSP → акустические признаки

14 сент. 2026 г.

Прогресс по визуализации и обратному декодированию

Перепроверена семантика VoiceScenario по фактической реализации synthesizeScenario.

Что подтверждено

  • animate.to после окончания duration НЕ сбрасывается. После завершения automation state[param] = to, сама automation удаляется, но новое значение остаётся активным до следующей команды.
  • set также меняет состояние постоянно, пока параметр не будет изменён снова.
  • Новая animate начинается от фактического текущего значения параметра на момент команды.
  • Для массива сценариев initial используется только у первого сценария, последующие продолжают текущее состояние без reset.

Найденная проблема визуализатора

Старый ScenarioVisualizer отображал только активные участки animate, из-за чего исходный сценарий визуально выглядел "рваным". Это не соответствовало реальному состоянию синтезатора.

Визуализатор перепроектирован на отображение полного VoiceControlState(t): значения идут непрерывно от начала до конца сценария, включая удержание последнего to после окончания duration, set, прерывание старых automation и продолжение состояния между составными сценариями.

Архитектурный вывод

Логика исполнения сценария (prepareScenario, evaluateBezier, updateAutomations, executeCommand) не должна дублироваться между синтезатором и визуализатором. Создана отдельная задача на вынос общего runtime-модуля, чтобы DSP и визуализатор использовали одну state machine.

Вывод по текущему декодеру

Даже после исправления визуализации видно, что текущий лог и сценарий находятся на разных уровнях представления. Сценарий содержит управляющие параметры, а лог содержит наблюдаемые акустические признаки. Прямое соответствие вида RMS -> sourceLevel, dominantFrequency -> f0Hz и т.п. в общем случае некорректно.

Также подтверждено, что исходный сценарий имеет существенно больше управляющих параметров, чем текущий лог акустических метрик, поэтому обратимость Scenario -> Sound -> Log -> Scenario в текущей архитектуре физически недоопределена.

Исследовать обратный дешифратор: звук → VoiceScenario

14 сент. 2026 г.

Новые выводы по устройству синтезатора и обратимости

Проведён разбор полного пути VoiceScenario -> PCM.

1. Синтез полностью находится в нашем коде

Уточнено, что никакого внешнего скрытого звукового движка, который формирует PCM, нет. Конечный массив звуковой дорожки целиком вычисляется внутри synthesizeScenario:

VoiceScenario -> VoiceControlState(t) -> excitation -> resonators -> value -> Float32Array.

На каждом sample код самостоятельно вычисляет итоговое значение и записывает его в output[sampleIndex]. Браузерный AudioBufferSourceNode затем лишь воспроизводит уже готовый PCM.

Это означает, что весь DSP можно инструментировать и исследовать на каждом шаге.

2. Управляющие параметры и измеряемые акустические метрики — разные уровни

После исправления представления сценария стало видно, что даже почти постоянные управляющие параметры дают высокочастотные изменения в измеряемом аудио. Это ожидаемо.

Причины:

  • постоянный f0Hz задаёт скорость изменения voicePhase, а не постоянное значение waveform;
  • постоянный noiseLevel управляет амплитудой случайного источника, который меняется каждый sample;
  • резонаторы имеют внутреннее stateful-состояние (low, band) и продолжают динамически изменяться даже при постоянных параметрах;
  • RMS, spectralFlatness и dominantFrequency зависят сразу от нескольких управляющих параметров и внутреннего DSP-состояния.

Поэтому control curve != measured acoustic curve.

3. Найден дополнительный скрытый для сценария слой: внутреннее DSP-состояние

Между VoiceControlState и PCM существуют внутренние состояния:

  • voicePhase;
  • resonator1/2/3.low;
  • resonator1/2/3.band;
  • состояние детерминированного PRNG;
  • активные automation.

Именно этот слой объясняет, почему почти горизонтальные управляющие линии могут приводить к сложному высокочастотному waveform и неровным акустическим метрикам.

4. Следующее направление исследования

Нужно перейти от вопроса "какая метрика лога соответствует параметру" к задаче идентификации системы:

как изменение каждого параметра VoiceControlState влияет на waveform и на измеримые акустические признаки?

Предлагаемый эксперимент: parameter sweep по каждому управляющему параметру при фиксированных остальных и сбор waveform + спектральных/временных характеристик. Это позволит построить карту control -> acoustic features и понять, какие параметры реально наблюдаемы из аудио, какие зависят от комбинаций параметров, а какие текущим логгером вообще не видны.

Также обсуждена базовая теория PCM: постоянный unsigned 8-bit PCM уровень (например 255,255,255,...) не даёт устойчивого тона, потому что нет периодического изменения; слышимы в основном переходы. Это подчёркивает, что отдельное значение PCM — мгновенная амплитуда, а частота/тембр/громкость являются свойствами структуры последовательности во времени.

Исследовать параметрический синтез русских звуков и переходов между ними

14 сент. 2026 г.

Web Speech API / SpeechSynthesis как отдельный класс решения

В рамках поиска существующих реализаций проверен встроенный браузерный SpeechSynthesis.

Минимальный пример:

const utterance = new SpeechSynthesisUtterance('Привет, это синтез речи!');
utterance.lang = 'ru-RU';
const voices = speechSynthesis.getVoices();
utterance.voice = voices.find(v => v.lang === 'ru-RU');
speechSynthesis.speak(utterance);

Этот код показывает важный факт: современный браузер уже умеет воспроизводить вполне нормальную человеческую речь по тексту без нашей собственной DSP-реализации.

Но архитектурно это совсем другой класс системы и для нашей основной задачи он не подходит.

Что реально делает API

SpeechSynthesisUtterance принимает текст и настройки вроде языка/голоса, после чего передаёт их встроенному speech engine браузера/операционной системы.

Условная схема:

text
→ SpeechSynthesisUtterance
→ language / voice selection
→ hidden TTS engine
→ audio

Для пользователя доступен результат, но не внутренняя программа формирования звука.

Критичное ограничение 1. Нет прямого управления самим звуком

API принимает текст, а не артикуляционную или акустическую траекторию.

Например:

мама

обычно произносится нормально.

Но попытка написать:

ммммммааамама

не означает для движка:

удерживать /м/
→ плавно перейти в /а/
→ продолжить слог

Движок интерпретирует строку как текст и может начать читать её примерно как последовательность названий букв или слогов:

эм-эм-эм-эм... а... ма-ма...

Аналогично:

шшшшшшшш

может превращаться в что-то вроде:

ша-ша-ша-ша...

То есть через этот API нельзя надёжно задать:

  • длительность конкретного согласного;
  • удержание фонемы;
  • плавный переход между звуками;
  • форму артикуляционного перехода;
  • отдельную временную траекторию шума, voicing, формант и других параметров.

Поэтому API практически не пригоден для экспериментов вида:

М ─────────→ А

где именно сам переход является объектом исследования.

Критичное ограничение 2. Пение и произвольная временная структура

Поскольку входом является текст, а не звуковой сценарий, нельзя свободно задавать:

  • растягивание отдельных звуков;
  • произвольные длительности слогов;
  • мелодическую траекторию каждого звука;
  • вокальные переходы;
  • нестандартную ритмику;
  • нормальное «пение» через прямое управление фонемами.

Изменение общей rate или pitch не решает эту проблему: оно меняет поведение всего utterance, а не даёт управление внутренними звуковыми событиями.

Критичное ограничение 3. Языковая привязка

SpeechSynthesisUtterance опирается на lang и конкретный voice.

Это означает, что движок ожидает текст в рамках некоторой языковой системы.

Проблемными становятся:

  • смешение нескольких языков внутри одной фразы;
  • произвольные межъязыковые звуки;
  • искусственные слова;
  • нестандартные последовательности букв;
  • звуки, которые вообще не являются словами языка.

Даже если движок пытается что-то произнести, он делает это через собственные правила интерпретации текста, а не как универсальный генератор произвольного звука.

Критичное ограничение 4. Ограничение языковой моделью произношения

Корректнее говорить не только о «словаре» в буквальном смысле, а о более широком ограничении:

движок умеет произносить то, что способен интерпретировать в рамках своей языковой модели произношения.

То есть неизвестную строку он может попытаться прочитать, но это всё равно будет интерпретация как текста, а не прямое воспроизведение заданного акустического объекта.

Для нашей задачи это принципиально важно.

Нам нужен механизм уровня:

sound scenario
→ exact parameter trajectories
→ sound

а здесь используется:

text
→ hidden linguistic interpretation
→ hidden TTS model
→ sound

Критичное ограничение 5. Чёрный ящик

Даже если движок произносит слово очень качественно, наружу не выдаётся структурное описание того, как именно был построен звук.

Нет доступного представления вида:

initial state
+ timeline
+ source parameters
+ noise parameters
+ resonances
+ transitions

Поэтому SpeechSynthesis не помогает решить центральную задачу исследования:

получить компактное управляемое описание звука и уметь переходить между звуком и этим описанием.

Он демонстрирует только способность системы воспроизводить хорошую речь из текста.

Почему это всё равно полезно зафиксировать

Несмотря на архитектурную непригодность для нашей задачи, SpeechSynthesis полезно рассматривать как отдельный готовый вариант для других проектов.

Если задача звучит просто как:

текст → нормальная речь

то браузерный API может полностью закрыть её без собственного синтезатора.

Он особенно полезен там, где:

  • не требуется управлять отдельными фонемами;
  • не нужны нестандартные звуки;
  • не нужно пение;
  • не требуется дешифровка или доступ к внутреннему представлению;
  • достаточно обычного TTS на поддерживаемом языке.

Итог для нашего проекта

SpeechSynthesis показывает, что качественная речь в браузере как конечный результат доступна уже сейчас.

Но он не подходит нам архитектурно, потому что:

  1. вход — текст, а не звуковой сценарий;
  2. нет точного управления внутренней временной структурой звука;
  3. нет нормального управления длительностью отдельных фонем;
  4. плохо подходит для пения и произвольных вокальных траекторий;
  5. зависит от языка и конкретного voice engine;
  6. не является универсальным генератором произвольных звуков;
  7. не раскрывает внутреннее представление;
  8. не решает обратную задачу sound → scenario.

Поэтому для нашей исследовательской задачи это не конкурент VoiceScenario, а отдельный готовый TTS-инструмент для гораздо более узкого класса задач.

Исследовать качественный программный синтез человеческого голоса в браузере

14 сент. 2026 г.

Уточнение вывода поиска существующих реализаций

Поиск внешних проектов был нужен прежде всего для ответа на один вопрос:

насколько пространство реальной человеческой речи лежит внутри пространства звуков, которое способен воспроизвести компактный процедурный генератор.

Прямого подтверждения этому пока не найдено.

Что при этом известно точно

AudioContext способен качественно воспроизвести любой заранее записанный цифровой звук, если передать ему полный массив samples. Значит, проблема не в браузере как среде воспроизведения.

Проблема — в представлении.

Полный waveform универсален, но дорог: даже сильно сжатая секунда речи остаётся последовательностью из тысяч значений. Наша модель заменяет эту последовательность компактным сценарием из осмысленных параметров и команд во времени.

Поэтому исследуемая граница выглядит так:

полный waveform ← больше данных / выше универсальность ... структурный VoiceScenario → меньше данных / выше управляемость

Нужно понять, где на этой оси появляется качество, достаточное для естественной речи.

Почему найденные проекты не дали ответа

Pink Trombone и похожие физические модели показывают, что можно процедурно генерировать часть voice-like пространства, но:

  • они не универсальны;
  • в основном демонстрируют гласноподобные состояния и ограниченную артикуляцию;
  • звучание остаётся компьютерным;
  • нет полноценной демонстрации слогов и качественной связной речи;
  • нет обратного декодера запись → компактный сценарий.

Формантные демо ещё уже: они показывают отдельные статические или почти статические звуки, но не отвечают на вопрос о покрытии реальной речи.

Klatt-подобные системы не являются ориентиром для нашей архитектуры, потому что уже опираются на фонемные/языковые пресеты и не решают универсальную дешифровку произвольного звука.

Neural TTS/codec systems демонстрируют высокое качество, но скрывают внутреннее представление и не дают прозрачного управляемого сценария, который можно исследовать и редактировать.

Новый вывод

Отсутствие найденного примера не означает, что компактный сценарный генератор не способен приблизиться к человеческой речи. Оно означает только, что у нас пока нет внешнего доказательства нужного уровня качества.

Поэтому следующий практический путь — не продолжать бесконечный поиск аналогов, а измерять пределы собственной модели:

  1. улучшать прямой генератор;
  2. строить визуальный редактор сценариев для ускорения ручной настройки;
  3. создать обратный дешифратор и сначала проверять его на собственных синтетических данных с известным ground truth;
  4. затем переносить его на человеческие записи;
  5. постепенно увеличивать выразительность представления и измерять, какой прирост качества даёт каждый дополнительный механизм.

Главный объект исследования теперь — компромисс между компактностью структурного описания и perceptual quality.

Исследовать качественный программный синтез человеческого голоса в браузере

14 сент. 2026 г.

Новый прогресс: структурное представление звука и цикл человек ↔ ИИ

Зафиксированы несколько обнадёживающих признаков текущего прототипа.

1. Мы уже работаем не с waveform, а с компактной программой

Текущий синтезатор оперирует отдельными переменными начального состояния и отдельными сценариями на общей timeline. Это принципиально отличается от прямого хранения нескольких тысяч/десятков тысяч отсчётов.

Несмотря на грубость модели, из сравнительно малого числа параметров уже получаются звуки, которые человек иногда распознаёт как буквы/фонемные фрагменты или слоги. Это ещё не доказывает достаточность модели для естественной речи, но показывает, что параметрическое пространство не является полностью хаотичным.

2. Человек фактически выполняет роль perceptual validator

ИИ не имеет надёжного эталона того, насколько натурально звучит синтез. Поэтому текущий рабочий цикл выглядит так:

ожидаемый звук → сценарий → синтез → человек слушает → оценивает качество → ИИ предлагает изменения параметров → новый синтез.

Человек здесь даёт финальную perceptual feedback, а ИИ помогает анализировать структурные различия и двигаться по пространству параметров.

3. Использование реальной записи как локального ориентира

При поиске звука Ха была использована запись слова/фразы КуХаРе, где нужный участок реально присутствует. ИИ получил:

  • лог синтетического варианта;
  • лог реальной записи;
  • информацию о том, где в записи находится целевой фрагмент.

Далее он сравнивает структурные признаки и предлагает, какие параметры сценария можно изменить, чтобы приблизиться к нужному участку.

Это не даёт мгновенного результата, но выглядит как рабочий человеко-ИИ цикл приближения к целевому звуку.

4. Возможно, текущие логи слишком сильно сжаты

Есть подозрение, что качество аналитических логов недостаточно для точного сравнения. Если человек слышит различия, которых ИИ не может вывести из лога, bottleneck может находиться не только в генераторе, но и в разрешении анализа.

Нужно отдельно проверять, как меняется качество предложений ИИ при уменьшении сжатия логов и увеличении числа временных/спектральных признаков.

5. Случайно найденные реальные звуки — тоже знание

При поиске Ха один из вариантов был воспринят как Ва.

Это полезно по двум причинам:

  1. найденный звук сам по себе может быть нужен позже;
  2. переход от предыдущего «шипения» к воспринимаемому Ва показывает направление в параметрическом пространстве.

Такие случайные находки нужно сохранять вместе с изменениями параметров, потому что они помогают картировать пространство возможных звуков.

6. Пространство пока остаётся в области speech-like sounds

Несмотря на потенциальную универсальность AudioContext, при изменениях параметров текущего voice-oriented генератора мы пока в основном сталкиваемся со звуками, которые воспринимаются как голосовые/фонетические или близкие к ним, а не как случайные реальные звуки вроде лая, птичьего пения или стука копыт.

Это не доказывает универсальность и не доказывает полноту покрытия человеческой речи. Более осторожный вывод:

текущая архитектура генератора уже содержит сильный inductive bias в сторону voice-like sound space.

Это может быть полезным свойством, потому что поиск происходит не по всему возможному аудиопространству, а по более узкой области.

7. Уточнённая практическая цель

Теперь основной вопрос не только «какие параметры нужны для синтеза речи», а:

насколько компактно можно описать нужную область человеческой речи, не возвращаясь обратно к тысячам samples.

Крайние точки уже понятны:

  • waveform / μ-law — высокое качество и универсальность, но тысячи значений в секунду;
  • VoiceScenario — компактность и управляемость, но пока неизвестные пределы качества.

Дальнейшая работа должна исследовать промежуток между ними и зависимость:

качество ↑ ↔ сложность/размер представления ↑.

Возможный путь — постепенно добавлять только те механизмы, которые дают заметный perceptual gain, сохраняя структурность модели.

Исследовать параметрический синтез русских звуков и переходов между ними

14 сент. 2026 г.

Прогресс исследования

Проверили гипотезу о том, что для нашей задачи должен существовать практически применимый пример вида:

реальная запись звука/слога → автоматический анализ → компактная параметрическая траектория универсального генератора → обратный синтез узнаваемого звука

Почему такой пример казался вполне существующим

  1. Процедурный синтез сам по себе существует. Web Audio даёт осцилляторы, шум, фильтры и AudioWorklet; Pink Trombone показывает browser-native physical vocal tract; формантные демо позволяют получать отдельные гласноподобные звуки из малого числа параметров.

  2. Обычное waveform-представление очень велико. Около 1 секунды записи с микрофона может занимать порядка 200 KB в Float32Array. Даже после агрессивного μ-law @ 8 kHz остаётся около 11 KB и более 10 000 значений на секунду, хотя речь всё ещё воспринимается нормально. Это создаёт сильную интуицию, что воспринимаемая структура звука должна иметь существенно более компактное представление.

  3. В литературе есть много методов анализа речи. LPC, source-filter analysis, formant tracking, spectral-envelope estimation, vocoders, analysis-by-synthesis и др. По названиям и описаниям они выглядят близко к нужному механизму.

  4. LLM первоначально оценивали задачу слишком оптимистично. Концептуальная схема выглядит простой: generator + parameters + target sound + optimizer. Это создало ложное впечатление, что практический inverse mapping должен быть давно решён и доступен в открытых проектах.

Что удалось найти

Формантные/Web Audio демо

Есть множество примеров, где sawtooth/impulse source проходит через несколько band-pass фильтров и получается звук, напоминающий гласную.

Это доказывает только прямую генерацию из заранее известных параметров. Нужной нам обратной дешифровки такие примеры не дают.

Pink Trombone / Modular Pink Trombone

Это наиболее интересный из найденных генераторов, потому что:

  • звук создаётся процедурно;
  • ядро не обязано оперировать буквами;
  • состояние голосового тракта можно менять непрерывно;
  • реализация работает в браузере;
  • можно получать промежуточные звуки вне фиксированного словаря.

Но для нашей задачи не хватает главного:

  • нет найденного механизма recording → tract trajectory;
  • нет автоматического восстановления траектории параметров из реального МА или любого другого звука;
  • качество самого синтеза остаётся заметно синтетическим и не демонстрирует естественную речь даже при ручном управлении.

То есть Pink Trombone даёт генератор, но не дешифратор.

Klatt и Klatt-подобные реализации

Не являются архитектурным ориентиром для нашей задачи.

Причины:

  • многие реализации уже строят интерфейс вокруг фонем, ARPABET, пресетов и языковых правил;
  • язык и буквы становятся частью архитектуры ядра;
  • параметры часто handcrafted;
  • качество близко к старым синтезаторам;
  • нет универсального inverse mapping из произвольного звука в параметры;
  • нет демонстрации автоматического восстановления качественной реальной речи.

Для нас это слишком узкий слой: мы ищем универсальную дешифровку звука, а не таблицу фонем.

LPC / source-filter analysis

Позволяют оценивать отдельные характеристики: спектральную огибающую, резонансы, источник возбуждения и т.п.

Но не найден end-to-end кейс, где эти характеристики автоматически превращаются в компактную управляющую программу достаточно универсального генератора, после чего воспроизводится звук, близкий к исходному.

То есть это отдельные части решения, а не готовая система.

Analysis-by-synthesis

Нашлись работы, где параметры синтезатора подбираются по естественной речи оптимизацией.

Это полезно не как готовое решение, а как подтверждение инженерной сложности: обратное отображение нелинейно, неоднозначно и требует поиска в большом пространстве параметров.

Готового универсального browser-friendly решения нужного качества при этом не найдено.

Neural TTS / codec models

Высокое качество есть, но это другой класс решения:

  • внутреннее представление скрыто внутри обученной модели;
  • нет явного универсального управляемого VoiceState;
  • невозможно использовать систему как прозрачный физический/процедурный генератор;
  • это не отвечает исследовательской цели дешифровки звука в компактную понятную программу управления.

Чего не удалось найти

Не найден ни один убедительный открытый технический пример, который одновременно:

  1. Берёт реальную запись конкретного звука или короткого слога.
  2. Не требует заранее знать букву/фонему/язык.
  3. Автоматически восстанавливает компактную временную траекторию параметров.
  4. Использует универсальный процедурный генератор, а не neural TTS/codec decoder.
  5. Обратно синтезирует звук с качеством, достаточным хотя бы для нормальной узнаваемой речи и заметно лучшим, чем демонстрационные физические синтезаторы.
  6. Позволяет увидеть и изучить реализацию дешифровки.
  7. Реалистично переносится в браузерный стек.

Это сейчас главный отрицательный результат исследования.

Почему задача оказалась сложной инженерно

Обратная задача неоднозначна

Похожий выходной waveform может быть получен разными внутренними состояниями генератора. Из записи нельзя просто однозначно восстановить один «правильный» набор параметров.

Нужна метрика восприятия, а не просто waveform error

Два waveform могут иметь большую sample-by-sample разницу, но звучать почти одинаково. И наоборот, небольшая ошибка в критической временной или спектральной области может сильно менять восприятие.

Значит, обычный MSE не является достаточной целевой функцией.

Искать нужно не вектор, а траекторию

Звук — динамический процесс. Меняются источник возбуждения, резонансы, шум, атака, закрытия и раскрытия, носовой канал и другие параметры.

Поэтому реальная переменная поиска — временная программа параметров, а не одна статическая точка.

Генератор сам может не уметь воспроизвести нужный звук

Если выбранная модель недостаточно выразительна, никакой оптимизатор не восстановит исходный звук. Чем выразительнее генератор, тем больше пространство параметров и сложнее обратный поиск.

Голос сложнее нескольких формант

Для качественной речи могут быть существенны glottal source, spectral tilt, aspiration, turbulence, antiresonances, nasal coupling, jitter/shimmer, динамика vocal tract, source-filter interaction и другие механизмы.

Добавление каждого механизма улучшает выразительность, но одновременно усложняет дешифровку.

Ручная настройка не масштабируется

Подобрать параметры одного А вручную можно. Универсально восстанавливать произвольный звук таким методом невозможно.

Это похоже на ручной подбор точного цвета через CMYK без преобразования из целевого цвета в параметры: можно добиться отдельных примеров, но это не решает общую задачу.

Уточнённая постановка ключевой проблемы

Главная задача теперь формулируется не как «сделать синтезатор русских букв» и не как «подобрать хорошие пресеты».

Она универсальнее:

Научиться автоматически находить компактную временную программу параметров достаточно универсального генератора для заданного реального звука.

Буквы, фонемы и языки должны быть только возможными категориями поверх найденного звукового пространства, а не частью ядра.

Мета-вывод по работе с LLM

Кейс показал отдельный риск: LLM легко принимают понятную архитектурную декомпозицию за признак низкой инженерной сложности.

Несколько моделей первоначально описывали задачу как практически простую, потому что все компоненты по отдельности знакомы: Web Audio, filters, interpolation, optimization.

Но наличие понятных компонентов не доказывает существование работающей системы из них.

Только попытка найти конкретный воспроизводимый end-to-end кейс показала, что критический inverse mapping среди найденных решений фактически отсутствует.

Для дальнейшей работы техническую реализуемость нужно проверять минимальными proof-of-feasibility экспериментами, а не уверенностью LLM.
Исследовать качественный программный синтез человеческого голоса в браузере

13 сент. 2026 г.

Исследован базовый физический предел для качественного воспроизведения речи и ориентиры для русского языка.

Ключевые выводы:

  • Для воспроизведения человеческого голоса достаточно одного аудиоканала (mono): в одной точке пространства давление воздуха описывается одной скалярной временной функцией. Stereo нужно для пространственных признаков, а не для тембра/фонемной разборчивости самого голоса.
  • ITU wideband speech: примерно 50–7000 Гц. По Найквисту для сохранения этой полосы нужно >14 кГц sample rate; практический стандарт — 16 кГц. Это даёт raw PCM 16-bit mono = 16,000*16 = 256 кбит/с.
  • ITU super-wideband: 50–14,000 Гц; практический sample rate >=32 кГц, raw PCM 16-bit mono = 512 кбит/с. 48 кГц/16-bit mono = 768 кбит/с и уже покрывает fullband человеческой слышимости гораздо шире, чем обычно необходимо для речи.
  • Для сжатой речи Opus RFC 6716 указывает sweet spots: 8–12 кбит/с narrowband speech, 16–20 кбит/с wideband speech, 28–40 кбит/с fullband speech.
  • G.722 определяет high-quality wideband speech 50–7000 Гц при 64 кбит/с (старый SB-ADPCM codec); современный Opus достигает сопоставимой/лучшей субъективной эффективности при заметно меньшем битрейте.
  • Русский OpenSTT (~20 тыс. часов) использует mono, 16 кГц, int16 как основной практический формат; их прежний MP3-профиль был 16 кГц mono 32 кбит/с. Это полезный русский эмпирический baseline, хотя не фундаментальный минимум.

Важно различать bitrate хранения/передачи и сложность синтезатора: один выходной аудиоканал может быть получен из многих внутренних источников/фильтров (glottal source, aspiration, frication, resonances, nasal branch и т.д.). Число внутренних DSP-компонентов не равно числу выходных аудиоканалов.

Исследовать качественный программный синтез человеческого голоса в браузере

13 сент. 2026 г.

Прогресс исследования

Зафиксирован и экспериментально проверен основной архитектурный подход: человеческий звук описывается как непрерывный сценарий изменения универсального состояния DSP во времени, а не как специальный renderer буквы/фонемы.

Реализовано

  • VoiceScenario с initial и общей timeline.
  • Команды set и animate, включая cubic bezier.
  • Непрерывное состояние с параметрами возбуждения, периодичности, шума, F0, формы источника, трёх универсальных резонансных каналов и итогового уровня.
  • Новая команда по одному параметру начинает движение от его текущего значения и заменяет прежнюю будущую automation.
  • Синтезатор принимает как один VoiceScenario, так и VoiceScenario[].
  • Массив сценариев разворачивается в одну временную шкалу без сброса фазы источника и DSP-состояния между элементами.
  • Это позволило собирать Привет как [PRI_SCENARIO, VET_SCENARIO], а не создавать отдельный сценарий слова.
  • Шумовой источник переведён на seeded PRNG для повторяемого PCM.
  • Синтетический звук проходит через тот же VoiceLogger, что и живые записи.

Экспериментальный цикл

Используется схема:

живая запись → лог → анализ → сценарий → синтез → тот же логгер → сравнение → корректировка

Текущий logger измеряет RMS, peak, ZCR, spectral centroid, spectral flatness, dominant frequency и несколько энергетических диапазонов. Он пока грубый: анализ на 128 samples даёт частотный шаг около 375 Hz, поэтому его нужно в дальнейшем улучшать.

Результаты по отдельным звукам

А

Протяжное А уже получилось относительно естественным. Это подтвердило, что timeline + периодический источник + универсальные резонансы в принципе подходят для части устойчивых голосовых состояний.

С

После нескольких итераций выяснилось, что субъективное «шипение» нельзя сводить к избытку высоких частот. Живая сильная С имеет одновременно высокий ZCR, высокий spectral centroid и интенсивную высокочастотную турбулентность. Усиление только общей амплитуды не решает задачу качества источника.

Ш

Ш рассматривается как близкое к С непрерывное шумовое состояние, но с более низким и широким распределением спектральной энергии.

Т

Т подтвердило наличие кратковременных событий, которые нельзя тянуть как устойчивое состояние. Для живой Т характерен очень короткий высокочастотный выброс и быстрое затухание; в нескольких записях основной максимум часто оказывался около 15–16 kHz. Это удалось выразить той же timeline-моделью без специального типа T.

Составные сценарии

Созданы сценарии При и Вет, затем проверена их композиция через массив сценариев. Они уже узнаваемы, но качество звучания остаётся явно компьютерным.

После сравнения с живым Привет выявлено:

  • первоначальные сценарии были сильно растянуты по времени;
  • ручные глубокие колебания sourceLevel для Р звучат механически;
  • финальный Т в одном из вариантов доходил до peak = 1, то есть попадал в hard clamp;
  • сценарии были сокращены до более разговорных длительностей и финальный Т ослаблен.

Текущие ограничения DSP

Основной риск сейчас находится не в сценарной архитектуре, а в качестве самого звукового двигателя. Возможные недостающие универсальные механизмы:

  • более реалистичный glottal source;
  • spectral tilt;
  • aspiration / breathiness;
  • broadband/direct noise path;
  • более физичная модель турбулентности;
  • antiresonances;
  • nasal tract;
  • source-filter interaction;
  • более богатая модель голосового тракта;
  • возможно jitter/shimmer и другие малые вариации;
  • контроль клиппинга вместо скрывающего причины hard clamp.

Архитектурные выводы

  • буквы, фонемы и слоги должны оставаться метаданными, а не онтологией DSP;
  • устойчивые, переходные и взрывные явления пока удаётся выражать одной timeline-моделью;
  • композиция сценариев выглядит правильным направлением;
  • генеративный TTS не подходит как предмет исследования, поскольку задача требует явного программирования новых звуков, включая ранее не встречавшиеся;
  • Pink Trombone и подобные физические модели полезны как ориентиры, но их качество показывает, что одной непрерывной модели тракта недостаточно.

Следующий шаг

Создана отдельная связанная исследовательская задача cmtzxmokp085eqw0qtb7vg7c2 про качественный программный синтез человеческого голоса в браузере. В ней нужно найти browser-native/browser-capable проекты и DSP-подходы, которые без генеративного TTS качественно воспроизводят хотя бы несколько человеческих звуков или слогов, и понять, какие универсальные механизмы стоит перенести в текущий движок.

Исследовать параметрический синтез русских звуков и переходов между ними

11 сент. 2026 г.

Полный AI-проход по ресурсному корпусу и экономика обработки

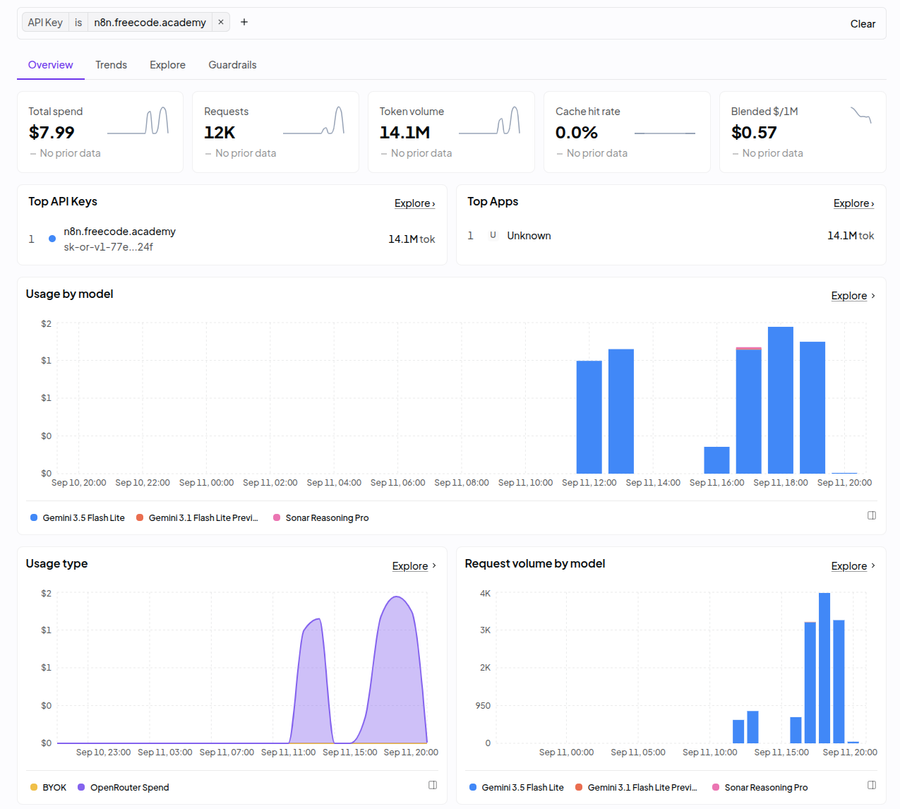
После первого прохода по топикам обработка была расширена на весь ресурсный корпус: топики, комментарии, блоги и прочие сущности, унаследованные от общей модели Resource (исторически — от MODX site_content).

По данным OpenRouter итоговый пакет составил примерно 12 000 AI-запросов, 14,1 млн токенов и около $7.99 расходов. Почти вся массовая обработка выполнялась на Gemini 3.5 Flash Lite.

Это практически совпадает с масштабом текущего архива: только Topic + Comment дают 11 890 сущностей (1 349 топиков и 10 541 комментарий), а с блогами и прочими типами общий объём естественно выходит примерно к 12 тысячам ресурсов.

Практический вывод оказался важнее самой миграции Markdown: полный управляемый AI-проход по многолетнему публичному архиву стоит единицы долларов. Изначально ожидался порядок 20,фактическаястоимостьполучиласьоколо20, фактическая стоимость получилась около 8.

Это меняет экономику контента. Теперь можно не ограничиваться одноразовой миграцией, а делать специализированные повторные проходы по всему корпусу: нормализацию, классификацию, выделение сущностей и утверждений, построение связей, поиск изменений позиций, тематические ретроспективы, provenance и подготовку новых публикаций. Стоимость полного машинного прочтения корпуса становится сопоставима с обычной технической операцией, а не с редакционной работой.

На уровне модели распространения это даёт ещё один вывод: человек может передать AI ядро мысли, AI — догуглить и собрать контекст, затем опубликовать управляемый набор материалов на одном или нескольких сайтах. Дальше эти материалы становятся доступными другим AI-агентам и могут входить в их ответы через GEO/AI-search. То есть дешёвая массовая генерация здесь используется не ради спама, а как управляемая публикационная инфраструктура для распространения проверяемых идей и экспертизы.

Отформатировать контент

Написать мне