Журнал разработки Николая Ланца

30 сент. 2026 г.

Прогресс на 30.09.2026

Подготовительная часть аналитики и контроля качества начата.

В baseline старого сайта сохранены браузерные сценарии, HTTP-проверки, robots/sitemap, четыре отчёта Lighthouse, снимок ресурсов контейнеров и контрольные суммы материалов. Зафиксированы текущие проблемы, которые важно отслеживать как регрессии.

На legacy обнаружены два подключения старого Google Analytics — потенциальный источник повторных событий. Часть интерфейса также зависит от наличия Яндекс.Метрики.

Новая реализация уже покрыта техническими проверками: npm run types, npm run lint, npm run build, интеграционное чтение MySQL, 17 тестов SSR/доступности/маршрутизации, браузерный переход по legacy URI без ошибок гидратации.

Остаётся: инвентаризировать и перенести реальные цели/события аналитики, исключить дублирование счётчиков, определить события лидогенерации, проверить UTM/referrer, протестировать доставку форм и лидов, а после запуска контролировать реальные конверсии, 404/5xx и поисковую доступность.

Настроить аналитику и контроль качества запуска

30 сент. 2026 г.

Прогресс на 30.09.2026

Собрана фактическая база для последующей пересборки маркетинговой архитектуры, но сама новая коммерческая структура ещё не реализована.

Зафиксированы восемь типов страниц текущего сайта: главная, печать, доставка, услуга, магазин, контакты, заявка на печать и опросник. Сохранены 37 desktop/mobile-скриншотов, HTML/метаданные, изображения и пользовательские сценарии.

Выявлены UX-проблемы текущего сайта: мобильное переполнение главной и контактов, ошибки JS на вложенных страницах, фатальная PHP-ошибка магазина при HTTP 200, сломанные ресурсы и зависимость части интерфейса от Метрики.

Новая HAIH-основа уже получила собственные Layout/Header/Footer и заготовку главной, удалены нерелевантные маршруты исходного HAIH-шаблона и установлен русский язык документа.

Остаётся основная маркетинговая работа: определить и развести ключевые B2C/B2B-сценарии, пересобрать офферы и CTA, доказательства/кейсы/цены/FAQ, мобильный путь до заявки и полноценные коммерческие страницы. Текущая MainPageCustom пока остаётся заготовкой.

Пересобрать маркетинговую архитектуру и конверсию

30 сент. 2026 г.

Прогресс на 30.09.2026

SEO-подготовка выполнена в значительной части.

  • Собран реестр всех 4 809 документов, а не только URL из sitemap.
  • Для документов зафиксированы URI, ID, шаблон, класс, состояние публикации, ограничения доступа, SEO-данные, источник контента и решение по переносу.
  • 4 553 документа назначены к сохранению URL/данных и новому представлению.
  • 166 неопубликованных документов не должны публиковаться автоматически.
  • 66 опубликованных modWebLink должны сохраняться как перенаправления.
  • Разобраны 728 исторических URI: 39 требуют сохранения как исторические 301, 6 ведут на непубличные цели, отдельно выделены 403 и старый платёжный маршрут.
  • Обнаружены 5 саморедиректов и конфликт URI между черновиком и опубликованным документом.
  • Выполнено 835 контрольных GET-запросов; отдельно отмечены 35 HTTP 200 с фатальной PHP-ошибкой внутри ответа.
  • Сопоставлены 497 URL sitemap и выявлены проблемные/особые адреса.

В новом HAIH уже есть SSR fallback, title, description, canonical и Open Graph, а для ошибок — noindex. Canonical строится на https://balldecor.ru из сохранённого URI.

Остаётся: реализовать redirect map, modWebLink и исторические редиректы; подключить TV metaTitle/metaDescription; завершить правила indexability/ACL; перенести sitemap/robots/structured data; выполнить полный crawl новой версии и пострелизную SEO-проверку.

Сохранить и улучшить SEO при миграции

30 сент. 2026 г.

Прогресс на 30.09.2026

Подготовительный этап миграции существенно продвинут.

Завершены локальные технические задачи старого проекта: старый MODX-сайт поднят локально, зафиксировано исходное состояние, проведён аудит legacy и подготовлен полный реестр URL. Новый HAIH-runtime уже подключён к существующей MySQL: реализованы Knex/mysql2, модели MODX, GraphQL, Apollo Client, SSR fallback для старых URI и базовые SEO-метаданные.

Фактический объём legacy подтверждён аудитом: 4 809 документов MODX, 4 643 опубликованных и неудалённых, 32 шаблона, 89 TV, 13 677 сохранённых TV-значений, 5 308 строк docGallery, 2 829 товаров и 728 исторических URI.

Новая версия уже умеет находить документ по старому URI, загружать его через GraphQL на сервере, отдавать SSR с названием документа и базовыми title/description/canonical/Open Graph, передавать Apollo cache браузеру и возвращать 404 для отсутствующих/непубличных документов.

Проверены types/lint/build, интеграционное чтение реальной MySQL, SSR/маршрутизация/кеш и браузерные переходы. Полноценный контент, шаблоны, формы, редиректы, каталог, калькулятор, маркетинговые страницы и production-прокси пока не перенесены.

Четыре закрытые технические подзадачи legacy-репозитория являются подготовкой, а не процентом готовности нового сайта. Основная миграция остаётся в работе.

Перенести balldecor.ru на HAIH

30 сент. 2026 г.

Подтверждена универсальная схема размещения и маршрутизации дочерних проектов

Получен важный промежуточный результат по минимальному управлению проектами: экспериментально подтверждена схема, в которой платформа управляет проектом снаружи, а сам проект сохраняет полную самостоятельность внутри.

Дочерний проект успешно запускается в изолированном Docker-окружении без публикации собственного порта на хосте и становится доступен через единый общий Traefik платформы. Пилотный haih-site корректно открывается по выделенному ему hostname через общий вход платформы.

Что это даёт

Платформе не требуется знать внутренний стек каждого проекта. Внутри проекта могут находиться Node.js, PHP, базы данных, кеши, собственный reverse proxy и любые другие сервисы, которые описывает его Compose. Проект самостоятельно определяет свою внутреннюю архитектуру и остаётся переносимым: его окружение можно запускать независимо, а Narasim добавляет внешний слой управления и публикации.

Получается два уровня ответственности:

Internet / пользователь / агент
            ↓
общий Traefik платформы
            ↓
      выбранный проект
            ↓
внутренний proxy / Compose проекта
            ↓
    внутренние сервисы

Общий Traefik решает только задачу выбора проекта по домену. Всё, что происходит внутри проекта, остаётся его собственной ответственностью. Благодаря этому для добавления нового технологического стека не требуется писать в платформе специальную логику установки и маршрутизации каждого его сервиса.

Проверена корректная изоляция маршрутов

Отдельно устранён важный ложноположительный сценарий: запрос к отсутствующему дочернему проекту больше не маскируется основным приложением платформы. Основное приложение ограничено своим hostname, поэтому неизвестный или недоступный дочерний маршрут корректно приводит к 404 вместо открытия чужого сайта.

Это важно не только для UX, но и для будущей автоматической проверки запуска: сам факт получения HTTP-ответа от общего proxy ещё не означает, что запрошенный проект действительно работает.

Ценность для agent-driven платформы

Практически подтверждается нужная граница универсального project runtime. Агент может получить задачу, подготовить проект в подходящем ему стеке, запустить его как самостоятельную систему и предоставить пользователю рабочий адрес. Платформа при этом может ограничиться общими операциями жизненного цикла проекта вместо знания деталей каждой технологии.

Это создаёт основу для размещения множества независимых проектов за единым входом без выделения отдельного host-порта каждому проекту и без необходимости перестраивать общий proxy под внутреннее устройство приложения.

Что считаем доказанным сейчас

На текущем этапе подтверждена именно схема размещения и HTTP-маршрутизации:

  • дочерний проект способен работать как самостоятельный Compose-стек;
  • внешний контейнер проекта не требует опубликованного host-порта;
  • общий Traefik способен маршрутизировать запрос на нужный проект по hostname;
  • внутри проекта может существовать собственный proxy, отвечающий за его сервисы;
  • основной сайт платформы не перехватывает отсутствующие дочерние маршруты;
  • добавление такого проекта не требует знания его внутреннего технологического стека со стороны платформы.

Пока не считаем решёнными управляемое ожидание готовности приложения, полный lifecycle через API, диагностику стадий запуска, сохранение/восстановление данных, права доступа и полноценную изоляцию недоверенного кода. Привилегированный DinD удобен как техническая граница эксперимента, но сам по себе не является достаточной security-моделью для запуска произвольного недоверенного проекта.

Главный результат этапа: найдена и практически проверена архитектурная граница, позволяющая Narasim управлять независимыми проектами как целыми системами, не превращая платформу в универсальный installer для всех возможных стеков.

Добавить минимальный функционал по управлению проектами

29 сент. 2026 г.

Итог миграции pivkarta.ru: production и SEO/performance evidence

Задача завершена: новый pivkarta.ru выведен в production. Дальнейшие доработки будут оформляться отдельными задачами.

Масштаб brownfield-миграции

Новый сайт построен поверх развивавшегося HAIH runtime, но для реального legacy-проекта движок был существенно доработан до полноценной production-схемы: единый Express runtime, React Router SSR, GraphQL/Apollo/Pothos, Knex к существующей MySQL, Vite middleware в development, production static serving, Varnish, обработка legacy thumbnails через Sharp, ETag/GET/HEAD и корректное завершение серверных ресурсов.

Восстановлена основная публичная структура старого продукта: пиво, заведения, публикации, участники, комментарии, города, карта и контакты, включая исторические URL и связи между сущностями. Инвентаризация legacy-данных зафиксировала 1 636 записей пива, 3 797 заведений, 600 статей, 64 города, 3 296 комментариев и 26 548 публичных профилей.

Для совместимости был построен реестр из 73 760 адресов. Полный HTTP-обход зафиксирован как passed: 73760 без ошибок на проверенном состоянии. Дополнительно проверялись 11 579 ссылок контента и 19 660 URL ресурсов. Последующие изменения ветки покрывались целевыми тестами, поэтому старый полный crawl не следует считать проверкой каждого последнего коммита.

Измеримый production-результат

Основная работа текущей итерации с 28 сентября заняла по таймерам 18:01:02.

Lighthouse до/после:

МетрикаLegacyNew
Performance4993
Accessibility75100
Best Practices7496
SEO83100

Application runtime по docker stats:

  • legacy front: 588.4 MiB;
  • legacy api: 231.3 MiB;
  • legacy prisma: 953.2 MiB;
  • legacy application layer суммарно: ~1773 MiB (~1.73 GiB);
  • новый app: 178.2 MiB.

Таким образом, application RAM уменьшилась примерно в 10 раз (~90%), при одновременном росте Lighthouse Performance с 49 до 93 и достижении 100 по Accessibility и SEO. Особенно показательно, что один только Prisma 1 старого стека потреблял ~953 MiB — более чем в пять раз больше всего нового application runtime.

Главный инженерный вывод

Миграция подтвердила brownfield-гипотезу HAIH: для замены legacy-приложения необязательно воспроизводить его историческую архитектуру. Практический путь оказался таким:

legacy system → восстановление реальных requirements/capabilities → проверка данных и URL-контрактов → отбрасывание ненужного наследия → минимальная новая архитектура → verification → production evidence.

Первоначальная гипотеза о сохранении legacy-модели как основной архитектурной границы была скорректирована после исследования реальной БД и 250 таблиц. В результате сохранены ценные публичные данные, связи и web-контракт, но не воспроизведена накопленная инфраструктурная сложность старой системы.

Это отличает результат от обычного редизайна: получен production replacement реального многолетнего сайта с измеримой совместимостью, существенно меньшей стоимостью runtime и заметно лучшими web-метриками.

Граница этой задачи

В рамках этой задачи считаем миграцию выполненной. Отложенные write-сценарии (авторизация, создание/редактирование сущностей), дальнейший индивидуальный редизайн внутренних страниц, дополнительные production-проверки и прочие улучшения должны выполняться отдельными задачами, а не расширять текущую.

Перенести сайт на новый движок

29 сент. 2026 г.

Структура legacy-БД: гипотеза «просто подключиться» пересматривается

После локального запуска посмотрели фактическую структуру существующей MySQL. Масштаб legacy оказался существенно больше, чем видно только по Docker-стеку: 250 таблиц, около 198 тыс. строк и ~82 MiB данных.

Из 250 таблиц примерно 150 имеют старый MODX-префикс fSdf12_. Это большой системный слой самого MODX и установленных за годы Extras: ACL/policies, contexts, manager/dashboard, media sources, package transport, lexicon, sessions, users/groups, billing/shop-модули, society, SDK/importer, search, monitoring, GeoIP и другие подсистемы. Значительная часть этих таблиц пустая или содержит буквально единицы записей, но при анализе legacy они всё равно выглядят как потенциально значимая часть системы.

Отдельно присутствует ещё один исторический слой модели: десятки Prisma-style relation-таблиц _...; многие из них сейчас пустые. Видны и следы последовательных миграций/дублирования сущностей: например старые и новые варианты Place, Beer, User, Photo, комментариев и связующих таблиц, backup-таблицы пользователей, views и разные storage engines (MyISAM + InnoDB). Это уже не одна предметная схема, а несколько поколений архитектуры, живущих в одной базе.

При этом реальное предметное ядро pivkarta.ru намного меньше. По данным видно несколько тысяч заведений (Place ~3.8k), около 1.6k сортов/позиций Beer, ~13k связей PlaceBeer, фотографии, пользователи и связи заведений с пивом/метро/пользователями; плюс контентные сущности вроде комментариев, тем, новостей/блогов и т.п. Какие именно из них нужны современной версии продукта, ещё предстоит определить по фактическим требованиям — количество записей само по себе не доказывает, что feature надо переносить.

Это наглядно подтверждает тезис из статьи «MODX платит огромную постоянную архитектурную цену за функциональность, которой большинство проектов почти не пользуется»: даже пустая таблица не означает нулевую архитектурную стоимость. Если subsystem существует, при работе с legacy приходится выяснять его модель, связи, runtime semantics и понимать, можно ли его безопасно отбросить. В этой базе эффект хорошо виден буквально физически: большая часть schema описывает возможности движка и исторические эксперименты, а не сегодняшнюю предметную модель pivkarta.ru.

Изменение направления эксперимента

В предыдущем worklog первым вариантом был минимально инвазивный путь: оставить существующую MySQL как persistence boundary и подключить новый API через Knex. После просмотра схемы этот вариант уже не выглядит очевидно оптимальным.

Теперь более перспективная гипотеза — создать новую чистую БД с минимальной предметной моделью и мигрировать в неё только доказанно необходимые данные. Старую БД использовать как источник данных и археологии требований, но не делать её постоянным фундаментом новой архитектуры.

Это добавляет работы сейчас: агенту придётся разобраться, какие из 250 таблиц действительно участвуют в продукте, какие являются техническими таблицами MODX/Prisma/Extras, какие представляют старые версии тех же данных, а какие features вообще больше не нужны. Но именно это и является хорошим brownfield-тестом HAIH: не переносить накопленную сложность только потому, что она уже существует; восстановить реальные требования и собрать под них минимальную новую модель.

Следующий логичный шаг — построить карту legacy tables → реальные capabilities → нужны/не нужны → новая модель → migration/verification, а затем выбрать первый вертикальный сценарий и перенести его вместе с данными end-to-end.

Связанный эксперимент: haih.site и задача /tasks/cmujk0ehv0m20qw0rs14y30bw. Текущая задача: /tasks/cmqqxckd3003zp50up0dmzbld.

Перенести сайт на новый движок

28 сент. 2026 г.

Legacy baseline запущен локально

Удалось локально поднять старый pivkarta.ru — Docker сильно помог сохранить воспроизводимость даже спустя годы. Одновременно стало хорошо видно, насколько большой исторический слой накопился в текущей архитектуре.

Некоторые характерные компоненты baseline:

  • build image: mhart/alpine-node:10 — Node.js 10;
  • Docker Compose 3.7;
  • prismagraphql/prisma:1.15.3 (Prisma 1) отдельным сервисом между приложением и БД;
  • MySQL 5.7;
  • отдельные контейнеры front и api из общего старого prisma-cms;
  • отдельный frontend pivkarta.ru-2;
  • phpMyAdmin;
  • собственный Caddy proxy;
  • MailHog;
  • отдельный rtcmultyconnection;
  • Coturn со STUN/TURN-инфраструктурой.

То есть это уже не просто задача обновить несколько npm-пакетов: перед нами хороший реальный brownfield со слоями решений разных лет и большим количеством инфраструктуры, часть которой может оказаться необходимой, а часть — историческим багажом.

Для эксперимента HAIH это особенно полезно. Не будем механически переносить этот zoo на современные версии. Старый проект становится источником требований и baseline поведения, а не спецификацией новой архитектуры. Для каждого слоя нужно выяснять: какую реальную capability он обеспечивает сейчас, нужна ли она pivkarta.ru сегодня, и какое минимальное проверяемое решение удовлетворяет этому requirement.

Первый намеченный новый vertical slice остаётся простым: сохранить существующую MySQL как legacy persistence boundary и пройти React → Apollo/codegen → GraphQL/Pothos → Knex → existing MySQL. Это позволит начать вытеснять старую систему работающими вертикалями, не начиная с рискованной миграции данных и не перенося Prisma 1 только потому, что он присутствует в legacy.

Связанный HAIH-эксперимент: haih.site и задача «Разработать и запустить сайт». Текущая задача pivkarta.ru: /tasks/cmqqxckd3003zp50up0dmzbld.

Перенести сайт на новый движок

28 сент. 2026 г.

Новый эксперимент HAIH: brownfield на pivkarta.ru

Задача была поставлена давно как модернизация старого haih-agent, но с тех пор появился новый подход HAIH, который мы сейчас проверяем на практике в haih.site. Текущая работа над концепцией ведётся в задаче «Разработать и запустить сайт», а pivkarta.ru выглядит хорошим следующим подопытным для нового движка/подхода.

Если haih.site — greenfield-эксперимент «как быстро собрать достаточную архитектуру из реальных требований», то pivkarta.ru может стать brownfield-экспериментом: как быстро AI-агент способен разобрать существующий продукт, сохранить его реальные требования и постепенно заменить устаревшую архитектуру, не перетаскивая её исторический багаж в новую систему.

Важно не начинать с тотального rewrite и заранее выбранного «правильного стека». Существующую MySQL можно оставить как рабочий persistence boundary и для первого vertical slice подключиться к ней через Knex, поверх сделать новый typed API на Pothos/GraphQL, а на клиенте — codegen/Apollo + React. То есть переносить прежде всего требования и поведение, а не старую архитектуру.

Первый практический эксперимент: выбрать один реальный пользовательский сценарий и провести его end-to-end через новую систему (React → Apollo → GraphQL/Pothos → Knex → existing MySQL), зафиксировав время реализации, проблемы, способы проверки и ресурсы. Уже имеющийся baseline старой системы (~2 ГБ RAM по текущим замерам) позволит сравнивать результат не только по функциональности, но и по стоимости runtime.

Это должно стать вторым типом evidence для HAIH после haih.site: не только «как быстро AI собирает новое», но и как быстро он способен переосмыслить и вытеснить legacy по работающим вертикалям.

Перенести сайт на новый движок

28 сент. 2026 г.

Прогресс: от application engine к базе инженерных решений для AI

В ходе дальнейшего проектирования уточнена общая парадигма HAIH и проверено, как она уже проявляется в текущем haih.site, в частности на странице /solutions.

1. Переиспользовать не обязательно application engine

Основная гипотеза стала радикальнее: в эпоху coding agents значительная часть ценности большого application framework/engine может переноситься из готового универсального кода в повторно используемое инженерное знание.

Новая схема:

requirements
+ best practices
+ showcases
+ evidence
+ mature primitives
        ↓
   coding agent
        ↓
project-specific implementation

То есть reuse остаётся, но его объектом всё чаще становится не универсальная реализация бизнес- и application-слоя, а проверенный способ решения задачи.

2. Граница проходит не между «готовым» и «самописным»

Нет цели переписывать PostgreSQL, OpenSSL, Sharp и другие зрелые специализированные primitives. Но интеграционные framework'и следует оценивать по фактически используемым capabilities.

Пример с Next.js: задача не в создании собственного аналога Next.js, а в определении того, какие его возможности реально требуются проекту — routing, layouts, build, SSR/SSG, image processing и т. п. Если конкретный набор требований дешевле и прозрачнее реализуется через React + Vite + специализированные primitives + небольшой project-specific glue, большой framework перестаёт быть обязательным.

Ключевой эффект coding agents: стоимость написания и сопровождения небольшого специализированного glue-кода резко снизилась. Поэтому старое правило «не писать своё, потому что придётся поддерживать» больше нельзя применять без сравнения с ценой чужой abstraction model, upgrade path и compatibility constraints.

3. React — пример dependency с высоким architectural leverage

Отдельно уточнено, что минимализм не означает механическое исключение framework/library dependencies.

React хорошо соответствует новой модели: при сравнительно компактной концептуальной поверхности он снимает большой объём сложной универсальной работы по декларативному UI, состоянию, композиции и rendering, не навязывая архитектуру persistence/API/deployment всего приложения.

Полезный критерий:

Сколько полезной сложности dependency забирает у проекта и сколько чужой сложности заставляет проект принять?

Таким образом, HAIH не должен оптимизировать dependency count. Нужно оптимизировать architectural leverage и суммарный friction.

4. /solutions уже является зачатком knowledge layer

Текущая страница haih.site/solutions фактически реализует часть этой модели. Она разделяет application, development/build, production runtime и optional deployment services и описывает технологии через выполняемые ими capabilities и зависимости.

Особенно полезна модель статусов решений: In use, Optional, Configured, Connected; verification in progress, Implementation open, Future branches. Это позволяет coding agent видеть не только решение, но и статус достоверности знания о нём.

Страница также оставляет будущие capabilities открытыми — standalone API, persistence, typed API/data contracts, identity/authorization, payments, formal solution composition — не назначая заранее обязательную технологию каждому требованию.

5. Следующий шаг — инвертировать каталог решений

Сейчас /solutions преимущественно отвечает на вопрос: «Что используется в haih.site и какую работу выполняет?»

Следующий уровень должен позволить идти от требования к композиции решений:

Requirement
    ↓
Capabilities needed
    ↓
Trade-offs
    ↓
Solution composition
    ↓
Implementation
    ↓
Verification
    ↓
Evidence

Пример: responsive images → on-demand transformation → Sharp → expensive deterministic computation → cache → Varnish/CDN/другая подходящая реализация.

Важно, что showcase не обязан предписывать конкретный стек. Агент должен уметь взять инженерный опыт и адаптировать его: например, не ставить Varnish, если требуемое кеширование уже обеспечивает существующий CDN.

6. Возможное развитие: machine-readable solution graph

Перспективное направление — машиночитаемое описание solutions: какие capabilities решение предоставляет, какие prerequisites требует, какие verification checks подтверждают корректность и с какими решениями оно композиционно совместимо.

Тогда HAIH сможет быть не runtime framework, присутствующим в каждом production-проекте, а engineering knowledge system, из которой coding agent синтезирует архитектуру конкретного проекта под requirements.

Текущая формулировка направления

Не «новый модульный движок», а система повторного использования инженерного опыта:

Libraries provide primitives. Cases provide engineering experience. Agents synthesize the application. Evidence verifies it.

haih.site/solutions уже можно рассматривать как первый практический слой этой системы; showcases должны добавить законченные вертикальные переходы от requirement к проверенному результату.

Разработать и запустить сайт

27 сент. 2026 г.

Прогресс: проверка архитектуры haih.site на реальном проекте

Изучили текущую реализацию haih.site и уточнили критерий минимальности архитектуры. Важный вывод: минимализм нельзя измерять количеством технологий или зависимостей. Нужно минимизировать суммарный friction разработки, эксплуатации и дальнейших изменений, включая feedback loop человека и AI.

Development stack

React/Vite сами по себе не являются избыточностью даже для сайта, который в production в основном отдаёт статический контент.

Vite оправдан реальным требованием к разработке: быстрый edit → HMR → browser feedback loop без ручных reload/cache-reset действий пользователя.

React может быть оправдан компонентной моделью и локальностью изменений растущего UI. Для AI это также даёт предсказуемую, хорошо известную структуру кода.

Уточнённый принцип:

Не минимизировать число зависимостей. Минимизировать friction. Каждая добавленная технология должна уменьшать суммарную сложность сильнее, чем увеличивает её.

Production serving: baseline

После build запущен npm run start и проведён synthetic benchmark:

ab -c 1000 -n 100000 http://localhost:3000/

Результат:

  • 100 000 запросов;
  • concurrency 1000;
  • 0 failed requests;
  • 11 515.51 req/s;
  • p50 27 ms;
  • p95 37 ms;
  • p99 67 ms;
  • max 8658 ms.

Типичная latency низкая, но присутствовали единичные большие outliers.

Docker + Traefik + Varnish

Затем тот же workload запущен через production-like цепочку:

client → Traefik → Varnish → app

Benchmark:

ab -c 1000 -n 100000 http://localhost:8088/

Результат:

  • 100 000 запросов;
  • concurrency 1000;
  • 0 failed requests;
  • 15 871.02 req/s;
  • p50 62 ms;
  • p95 74 ms;
  • p99 88 ms;
  • max 129 ms.

По сравнению с прямым app-server throughput вырос примерно на 38%, а распределение latency стало существенно более стабильным: исчез многосекундный tail.

Поведение origin

docker stats показал, что во время 100k запросов app практически не участвовал в обработке повторных запросов.

До теста app имел примерно:

NET I/O 9.56kB / 126B
MEM 25.73 MiB

После:

NET I/O 10.9kB / 3.68kB
MEM 26.16 MiB

При этом Traefik обработал порядка 370MB / 394MB, Varnish — 41MB / 328MB.

Это подтверждает полезную архитектурную границу: cacheable delivery-нагрузка заканчивается на Varnish и почти не доходит до application layer.

Почему Varnish нужен проекту

Критически важное требование: сайт использует динамический resize/processing изображений через Node + Sharp.

Без cache повторный запрос одного варианта изображения потенциально повторяет дорогой цикл:

request
→ Node
→ Sharp
→ decode
→ resize
→ encode
→ response

С Varnish вычисление выполняется на cache miss, после чего одинаковый вариант может обслуживаться из cache без повторной работы Sharp:

request
→ Varnish
   ├─ HIT → response
   └─ MISS → Node → Sharp → result → cache → response

Поэтому Varnish оправдан не просто увеличением RPS статического HTML, а изоляцией application layer и кешированием результатов дорогих повторяемых вычислений.

Архитектурный вывод

Текущий стек следует оценивать не как список технологий:

React + Vite + Node + Sharp + Varnish + Traefik + Docker

а как набор решений конкретных требований:

  • Vite → быстрый development feedback loop;
  • React → композиция и локальность изменений UI;
  • Node + Sharp → on-demand подготовка изображений нужного размера/формата;
  • Varnish → не повторять дорогую обработку и не пропускать cacheable нагрузку до origin;
  • Traefik → routing/deployment boundary;
  • Docker → воспроизводимый runtime/deployment.

Хороший критерий для каждого архитектурного компонента:

Какую измеримую стоимость этот компонент уменьшает и превышает ли выигрыш стоимость самого компонента?

Это уточнение нужно использовать при разработке showcase и best practices HAIH: не навязывать минимальное количество технологий, а показывать минимально достаточную суммарную стоимость решения с evidence.

Следующая полезная проверка

Для чистого сравнения cache layer имеет смысл позже получить третий datapoint:

A. app
B. Traefik → app
C. Traefik → Varnish → app

с одинаковым workload и отдельной метрикой количества запросов, реально дошедших до origin.

Маркетинговую статью по этим выводам в рамках данного worklog не публикуем — оформить отдельно позже.

Разработать и запустить сайт

27 сент. 2026 г.

2026-09-27 — Проксирование трафика в DinD через Traefik

Проверена и доведена до рабочего состояния маршрутизация к дочернему проекту, запущенному через Docker Compose внутри DinD.

Результат

Рабочая цепочка: внешний Traefik → DinD:2015 → socat → внутренний Traefik:80 → app:3000. Проект nextjs-test успешно доступен по http://nextjs-test.localhost:2015/.

В Dockerfile дочернего проекта добавлены socat и bash, а внешний Traefik настроен на порт 2015 DinD-контейнера. socat после запуска Compose пробрасывает этот порт на внутренний Traefik.

Управление Docker-сетями

Первоначально подключение DinD к docker_default было добавлено непосредственно в buildAndRunProject, но принято решение не оставлять этот хардкод. Сеть должна управляться явно через API.

Добавлены:

  • тип DockerContainerNetwork (name, networkID, ipAddress, gateway, macAddress);
  • ленивое поле DockerContainer.networks;
  • helper mapContainerNetworks;
  • query containerNetworks;
  • mutation connectContainerToNetwork;
  • mutation disconnectContainerFromNetwork.

Теперь контейнер можно программно подключать к сети внешнего Traefik и отключать от неё без Docker CLI.

Выявленный нюанс

Если контейнер подключить к сети уже после появления маршрута, внешний Traefik может продолжить использовать старый endpoint. В проведённом тесте понадобился restart Traefik. Это следует учесть при дальнейшем lifecycle запуска и маршрутизации проектов.

Исправить сетевую маршрутизацию дочерних проектов через Traefik

25 сент. 2026 г.

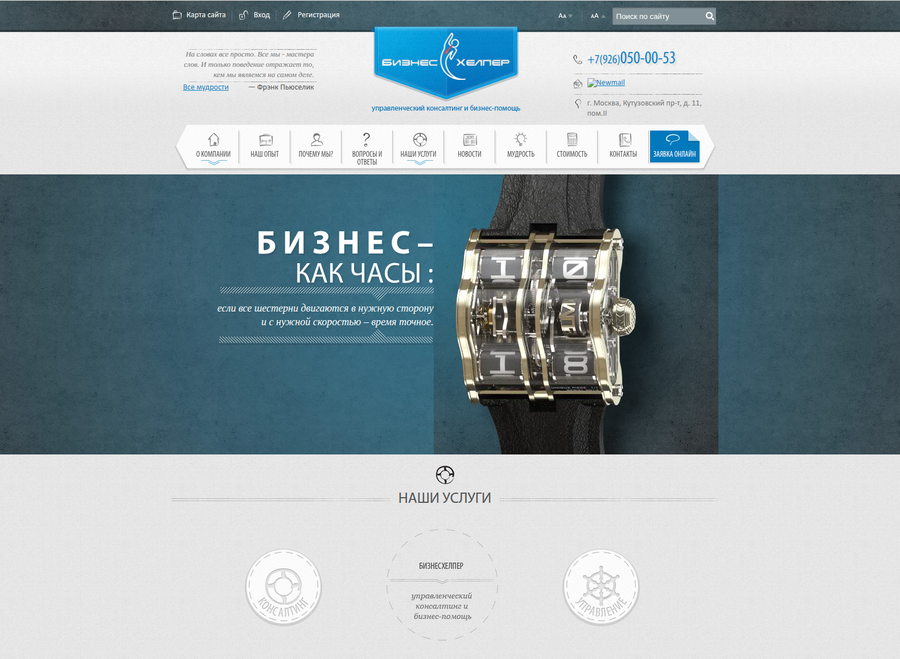
Сайт уже переписан на новых технологиях. Вот так он выглядел раньше:

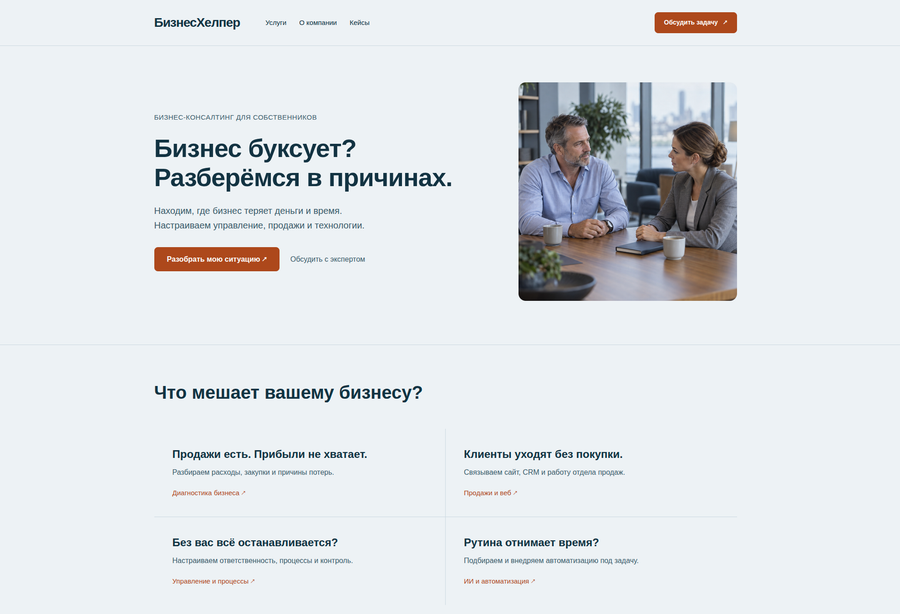
Так он выглядит теперь.

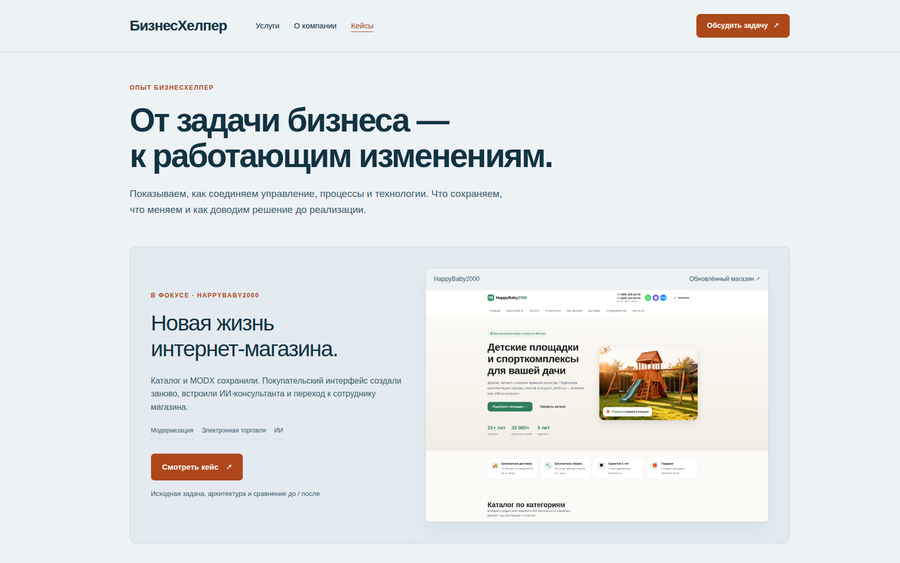
Полностью переработать макет и верстку bizneshelper.ru

25 сент. 2026 г.

Внешний аудит подтверждает текущий приоритет SEO/GEO: коммерческие страницы должны стать центром структуры и навигации, а информационный legacy-контент — связываться с конкретными бизнес-задачами, услугами, кейсами и обращением. Массово удалять wisdom/теги/новости ради «чистоты» не следует до оценки трафика и внешних ссылок. Основные KPI нового сайта предлагается связывать с квалифицированными обращениями, встречами и договорами; глубину просмотра использовать как вспомогательную метрику. Основной SEO-контент должен оставаться доступным на странице без открытия ИИ-чата.

Прокачать SEO/GEO

25 сент. 2026 г.

Аудит существующего ИИ-виджета показал слишком общий вход «Спросите что угодно». Рекомендуется превратить агента в инструмент первичного разбора бизнес-задачи: дать понятный вопрос о препятствии развитию, быстрые сценарии (продажи, ручное управление, сайт, применение ИИ, комплексный разбор), а на выходе формировать структурированное описание ситуации, предварительные гипотезы с оговорками, релевантный кейс/направление и возможность передать резюме специалисту. Не требовать телефон до первой пользы; перед передачей контактов/переписки получать понятное согласие; сохранять обычную форму и прямой контакт с человеком. Контекст входа должен зависеть от страницы.

Упростить форму обратной связи и заменить анкету на ИИ-агента

25 сент. 2026 г.

Получен аудит главной и ключевых входов. Главная проблема первого экрана: часы/метафора бизнеса не объясняют конкретное предложение и следующий шаг; при ширине 390 px предложение фактически не видно. Рекомендуемый смысл: помощь собственникам в поиске причин потерь в продажах, процессах и управлении с внедрением решений от изменений работы команды до веб-систем и ИИ-агентов. Главный CTA — разбор бизнес-задачи, альтернативный — обсуждение с экспертом. Предлагаемая последовательность главной: предложение → типовые проблемы → 2–3 кейса → подход диагностика/план/внедрение/измерение → 4 направления → веб/ИИ-инструменты → руководитель/команда → форматы сотрудничества → финальный CTA.

Обновить главную страницу и ключевые точки входа

25 сент. 2026 г.

Аудит выявил несогласованные публичные контактные данные: в разных местах сайта одновременно указаны разные адреса и телефоны. Нужно определить актуальный набор реквизитов и привести контакты, шаблоны и доверительные блоки к единому варианту. Для блока эксперта предлагается показывать полное имя, фото, специализацию, образование/MBA и личную роль в проектах; квалификацию подкреплять практическими кейсами.

Актуализировать публичные сведения и доверительные элементы

25 сент. 2026 г.

По аудиту sitemap сейчас не отражает коммерческие приоритеты: в просмотренных картах 726 адресов, 631 (~87%) относятся к /wisdom/, при этом основные коммерческие разделы /services, /experiences, /contacts, /price, /employees, /about_us в просмотренных XML-картах отсутствуют. Также обнаружены слабые/несоответствующие Title, отсутствие H1 на /services и нескольких услугах, отсутствие Description на стоимости, контактах и сотрудниках. В SEO-слое нужно добавить канонические коммерческие URL в sitemap, подготовить уникальные Title/Description/H1 по типам страниц, обновить internal links/canonical и сохранить ценные legacy URL.

Сформировать SEO-слой нового сайта и обеспечить поисковый переезд

25 сент. 2026 г.

Получен внешний аудит текущего сайта. Подтверждены пять старых URL из текста главной, которые возвращают 404: /pages/management, /pages/marketing, /pages/anticrisis, /pages/wholesale, /pages/business-processes. Предполагаемые соответствия: управленческий консалтинг, управление маркетингом, антикризисное управление, управление продажами, управление бизнес-процессами. Перед редиректами нужно сверить смысл старых материалов. Для безопасного переноса нужен реестр старый URL → новый/сохранение → статус → трафик → внешние ссылки → решение; не сводить старые URL массово на главную, исключить цепочки/циклы, значимые редиректы сохранять долгосрочно.

Подготовить SEO-карту значимых URL и редиректы

24 сент. 2026 г.

Полностью переписан портал «Городские бани» на haih-agent

В рамках задачи сайт был не просто перенесён на другой движок, а по сути полностью переписан с нуля на архитектуре haih-agent / haih CMS.

Репозиторий движка: https://github.com/haih-net/agent/

Старая версия портала: https://old.gorodskie-bani.ru/

Новая версия: https://gorodskie-bani.ru/

Главная цель переработки — отказаться от тяжёлой и фрагментированной архитектуры старого Next.js-проекта и перевести портал на значительно более простую, унифицированную и AI-first модель, где контент, структура страниц и дальнейшее развитие сайта максимально удобны для работы через ИИ.

Что было сделано

Фактически выполнены четыре крупных блока работ:

  • полностью собрана новая публичная версия сайта на haih-agent;
  • переработана архитектура хранения контента;
  • вся историческая база перенесена из MySQL в PostgreSQL;
  • сайт переведён на модель, в которой значительная часть управления и развития может выполняться ИИ-агентом через API и унифицированные контентные сущности.

Поэтому корректнее рассматривать этот этап не как обычный «редизайн» или «смену CMS», а как полную архитектурную переработку продукта.

Миграция MySQL → PostgreSQL

Старая версия сайта хранила данные в MySQL и использовала большое количество отдельных сущностей и таблиц под разные типы контента.

Для перехода на новую систему были написаны отдельные импортёры, которые:

  • читали данные из старой MySQL-базы;
  • преобразовывали старые структуры в новую унифицированную модель;
  • переносили данные в PostgreSQL;
  • сохраняли связи, исторический контент и существующие URL там, где это было необходимо;
  • адаптировали старый контент под новую систему файлов, изображений и страниц.

Миграция исторической базы была одной из самых существенных частей работы, потому что новый сайт должен был не просто стартовать с чистого листа, а сохранить накопленный за годы контент.

Вместо множества сущностей — один Concept

Одно из ключевых архитектурных изменений — отказ от большого количества специализированных сущностей.

В старом проекте отдельно существовали, например:

  • города;
  • бани и сауны;
  • отзывы;
  • комментарии;
  • статьи;
  • другие типы контента.

Для каждого такого типа обычно требовались собственные модели, запросы, шаблоны, логика отображения, API и административные сценарии.

В новой архитектуре большая часть контента приведена к одной универсальной сущности — Concept.

Concept содержит всего несколько базовых полей:

  • Название;
  • SEO-описание;
  • Интро для списков;
  • Контент;
  • Картинка;
  • Список файлов для галереи;
  • Координаты для карты.

При этом смысл сущности определяется не отдельной жёсткой таблицей в базе, а контекстом, связями, маршрутом и содержимым.

Один и тот же базовый механизм может использоваться для города, заведения, статьи или другого типа материала.

Почему унификация сильно упрощает кодовую базу

Такой подход заметно сокращает объём прикладного кода.

Раньше каждый новый тип контента потенциально требовал:

  • новой модели данных;
  • отдельных CRUD-операций;
  • отдельных API-контрактов;
  • отдельной административной формы;
  • отдельных шаблонов или React-компонентов;
  • дополнительной логики выборки и отображения.

После перехода на Concept большая часть этой инфраструктуры становится общей.

Это уменьшает:

  • количество специализированных моделей;
  • число повторяющихся запросов;
  • объём шаблонной логики;
  • количество мест, где нужно поддерживать одинаковое поведение;
  • стоимость последующего развития сайта.

Чем меньше специальных сущностей, тем меньше связанного кода необходимо держать в памяти приложения и выполнять при рендеринге страниц.

В результате архитектура становится проще как для сервера, так и для разработчика.

Меньше нагрузки на шаблонизацию

Унификация контента влияет не только на структуру базы, но и на рендеринг.

Вместо большого количества отдельных шаблонов для разных типов страниц используется общий набор компонентов и правил отображения.

Страницы могут собираться из Markdown и специальных компонентов: карточек, обложек, галерей, карт, колонок, ссылок, блоков взаимодействия с ИИ и других элементов.

Это позволяет одной системе рендеринга обслуживать большое количество разных страниц без необходимости создавать отдельную React-страницу или набор специальных шаблонов под каждую сущность.

Иными словами, сложность переносится из множества разрозненных программных моделей в унифицированный контент + переиспользуемые компоненты.

Главное изменение — сайт стал AI-first

Самое важное в этой переработке — не новый дизайн и даже не сама смена стека.

Новая архитектура изначально построена так, чтобы сайт можно было полноценно развивать и обслуживать через ИИ.

AI-агенту значительно проще работать с системой, где вместо десятков разных контрактов существует одна понятная модель Concept и несколько стандартных операций.

Для агента больше не требуется отдельно понимать:

  • как устроена таблица города;
  • чем API статьи отличается от API бани;
  • где лежат поля отзыва;
  • каким отдельным методом обновляется конкретный тип материала;
  • какая административная форма отвечает за тот или иной объект.

Большая часть контента обрабатывается одинаково.

Это означает, что агент может использовать одни и те же операции для:

  • создания материалов;
  • обновления текстов;
  • изменения SEO-описаний;
  • добавления изображений;
  • редактирования интро;
  • работы с координатами;
  • подготовки галерей;
  • перестройки страниц;
  • массового обновления контента;
  • поиска и анализа информации внутри сайта.

Полное управление контентом через ИИ

В новой системе классическая административная панель перестаёт быть центральным способом управления сайтом.

Контент доступен через API, а ИИ-агент может выполнять изменения по задаче человека.

Фактически рабочий процесс теперь выглядит так:

человек формулирует задачу → ИИ анализирует сайт и данные → выполняет изменения через API → человек проверяет результат.

Это принципиально отличается от традиционной CMS, где человек вынужден вручную проходить по административным формам и редактировать каждую сущность отдельно.

В результате ИИ становится не дополнительным «чатиком» поверх сайта, а полноценным интерфейсом управления и развития проекта.

ИИ-помощник для конечных пользователей

Та же унификация контента полезна и для агента, который общается с посетителями портала.

Поскольку города, заведения, публикации и другие материалы представлены в согласованном формате, агенту проще:

  • искать нужную информацию;
  • понимать связи между объектами;
  • находить заведения в конкретном городе;
  • использовать координаты и географические данные;
  • работать с описаниями и публикациями;
  • формировать ответы на основе существующего контента.

То есть новая архитектура одновременно улучшает две стороны работы с ИИ:

  1. ИИ как инструмент разработчика и владельца сайта — создаёт и редактирует контент, меняет структуру страниц и помогает развивать проект.
  2. ИИ как интерфейс для посетителя — ориентируется в каталоге и отвечает на вопросы пользователей.

Обновление интерфейса и публичной части

Параллельно с архитектурной миграцией полностью обновлена публичная часть портала.

В новой версии реализованы:

  • обновлённая главная страница;
  • новая навигация и типографика;
  • каталог заведений;
  • индивидуальные страницы бань и саун;
  • фотогалереи;
  • пагинация;
  • справочник городов;
  • алфавитная навигация и поиск;
  • городские страницы с подборками заведений;
  • карта с маркерами и группировкой объектов;
  • публикации по историческим адресам;
  • интерфейс обращения к ИИ-помощнику.

Таким образом, новая архитектура не ограничилась внутренним рефакторингом — на ней полностью собрана рабочая публичная версия портала с реальными историческими данными.

SEO и сохранение исторического контента

При миграции важно было не потерять поисковую ценность существующего сайта.

Поэтому при переносе учитывались:

  • исторические URL;
  • старые публикации;
  • страницы заведений;
  • страницы городов;
  • внутренняя перелинковка;
  • SEO-описания;
  • существующий контент.

Сохранение старых маршрутов там, где это возможно, уменьшает риск массового выпадения проиндексированных страниц после смены движка.

При этом сам переход на haih-agent не означает автоматического роста поисковых позиций. SEO-эффект новой архитектуры заключается прежде всего в том, что сайт становится проще поддерживать, быстрее изменять, легче масштабировать по контенту и удобнее системно улучшать с помощью ИИ.

Теперь массовое обновление метаданных, текстов, структуры страниц и контента может выполняться значительно быстрее, чем в прежней архитектуре.

Почему это важно для дальнейшего развития

Главный результат миграции — не только уменьшение технического долга.

Портал теперь находится в архитектуре, которая позволяет гораздо быстрее выполнять будущие задачи.

Новый рабочий цикл выглядит так:

развернуть движок → настроить тему и компоненты → собрать страницы → загрузить или создать контент → дальше развивать сайт через ИИ и API.

При необходимости сложные предметные процессы по-прежнему могут иметь отдельные программные модели, но стандартный контент больше не требует создания отдельной инфраструктуры под каждый новый тип страницы.

Это особенно важно для крупных контентных проектов, где стоимость поддержки часто определяется не сложностью одной страницы, а количеством различных сущностей, форм и шаблонов.

Срок выполнения

Полная переработка портала, включая новый интерфейс, перенос исторических данных и миграцию на новую архитектуру, была выполнена примерно за три дня.

При этом значительная часть времени ушла именно на совместимость со старым сайтом и импорт существующей базы.

Новый проект без необходимости переносить legacy-структуру на уже подготовленном движке мог бы быть собран существенно быстрее.

Итог

В рамках задачи сайт «Городские бани» был фактически создан заново на haih-agent.

Старая фрагментированная архитектура с большим количеством специализированных сущностей заменена на унифицированную модель Concept, историческая база перенесена из MySQL в PostgreSQL с помощью специально написанных импортёров, а публичная часть портала полностью пересобрана на новом движке.

Главное достижение этой работы — переход к AI-driven архитектуре сайта.

Теперь ИИ может не только отвечать посетителям, но и полноценно участвовать в развитии самого проекта: работать с контентом, изменять страницы, обновлять SEO-данные, управлять файлами, структурой материалов и выполнять массовые операции через API.

В результате сайт стал проще по архитектуре, дешевле в дальнейшем развитии и значительно лучше приспособлен к разработке, наполнению и сопровождению с помощью искусственного интеллекта.

haih CMS / haih-agent в этом проекте используется не просто как новый движок, а как основа для сайта, где ИИ является полноценным участником всего жизненного цикла — от разработки до управления контентом и общения с конечным пользователем.
Перенести сайт на haih-agent

Написать мне