Ворклоги
Итог работы
Задача по чтению существующих MODX frontend-сессий на стороне haih-agent практически решена и может считаться выполненной.
Что проверено
На стороне нового frontend удалось напрямую читать данные MODX-сессии без bootstrap MODX и без обращения к legacy endpoint modSociety. Это подтверждает саму архитектурную возможность использовать MODX как текущее хранилище сессий, а разбор и дальнейшую работу с данными выполнять уже внутри haih-agent.
Отдельно выяснилось, что основная техническая проблема оказалась не в чтении записи сессии из базы, а в десериализации её PHP session payload в Node.js.
Проблема с php-serialize
php-serialize не решает задачу напрямую, потому что MODX/PHP-сессия в используемом формате — это не просто один результат serialize($_SESSION). Поэтому библиотека не подходит как готовый session decoder для текущего кейса.
Использование php-session-unserialize
Для разбора сессии был взят пакет php-session-unserialize. Он корректно читает сам формат PHP session, но обнаружилась особенность реализации библиотеки: PHP associative arrays внутри readArray() всегда создаются как JavaScript Array.
По сути библиотека делает следующее:
const resultArray = []
resultArray[key] = value
Если PHP-массив содержит строковый ключ, например mgr, в JavaScript получается массив с именованным свойством (arr.mgr = ...). В console.log такие данные видны, но JSON.stringify и GraphQL сериализуют только индексированные элементы массива, поэтому именованные свойства теряются.
Практический пример: значение MODX-сессии вида
modx.user.0.resourceGroups => { mgr: [] }
после исходного парсинга выглядело в логах корректно, но через GraphQL превращалось в:
"modx.user.0.resourceGroups": []
Реализованный workaround
После unserialize() добавлена рекурсивная нормализация результата:
function convertArraysToObjects(obj: unknown): unknown {
  if (Array.isArray(obj)) {
    const keys = Object.keys(obj)
    const hasStringKeys = keys.some((k) => isNaN(Number(k)))
    if (hasStringKeys) {
      const result: Record<string, unknown> = {}
      for (const key of keys) {
        result[key] = convertArraysToObjects(
          (obj as unknown as Record<string, unknown>)[key],
        )
      }
      return result
    }
    return obj.map(convertArraysToObjects)
  }
  if (obj && typeof obj === 'object') {
    const result: Record<string, unknown> = {}
    for (const [key, value] of Object.entries(obj)) {
      result[key] = convertArraysToObjects(value)
    }
    return result
  }
  return obj
}
После этого PHP associative arrays с именованными ключами преобразуются в обычные JS objects и корректно проходят через JSON/GraphQL.
Результат
После нормализации данные MODX-сессии читаются корректно, включая вложенные структуры. В частности, успешно получаются такие ветки:
{
  "modx.user.0.resourceGroups": {
    "mgr": []
  },
  "modx.user.0.attributes": {
    "web": {
      "modAccessContext": {
        "web": [
          {
            "principal": 0,
            "authority": "0",
            "policy": {
              "load": true,
              "formit": true,
              "formit_encryptions": false
            }
          }
        ]
      }
    }
  }
}
Также в сессии видны данные для других пользователей/контекстов, например modx.user.1.attributes и ACL-структуры с большим набором manager permissions. То есть session payload теперь доступен целиком и без потерь при GraphQL-сериализации.
Ограничения текущего решения
Теоретически текущий converter может неоднозначно преобразовать PHP-массив со смешанными числовыми и строковыми ключами: при наличии хотя бы одного строкового ключа весь JS Array превращается в Object. Для обычных структур MODX-сессий это сейчас не критично; реальные данные, необходимые в проекте, после нормализации приходят корректно.
Поэтому на данном этапе нет необходимости писать собственный PHP session parser или форкать библиотеку. Если позже встретится реальный MODX session payload, который текущая схема разбирает неверно, это можно вынести в отдельную техническую задачу.
Граница выполненной задачи
Цель этой задачи была именно в принципиальной возможности читать и корректно десериализовать существующую MODX frontend-сессию на стороне haih-agent. Эта цель достигнута.
Логика определения конкретного текущего пользователя по содержимому сессии, выбор нужного frontend context, получение дополнительных данных пользователя и дальнейшее построение auth/currentUser API — это следующий прикладной слой и при необходимости должен оформляться отдельно.
Помог вот такой фикс, убирающий переносы между тегами:
$html = preg_replace('/>\s+</', '><', $html);
Еще для отладки вот это добавил, чтобы можно было смотреть сформированный HTML, до того, как он попадет вы pdf-рендерер, чтобы видеть что там вообще на выход должно попасть.
if($this->getProperty('debug_html')){
    header('Content-Type: text/html; charset=utf-8');
    echo $html;
    exit;
}
Кстати, важное уточнение: несмотря на то, что modxSite реализует АПИ, запросы используют не json данные на вход, а классический multipart/form-data
Теперь уже в нашем новом GraphQL-апи надо протестировать проксирование и обработку запросов.
Я добавил черновик резолвера и уже сейчас могу проверить идут попадают ли запросы в обработчик MODX и прилетает ли нам ответ.
Вот я вижу корректный ответ в формате JSON о том, что у меня нет доступа при попытке создать заявку.
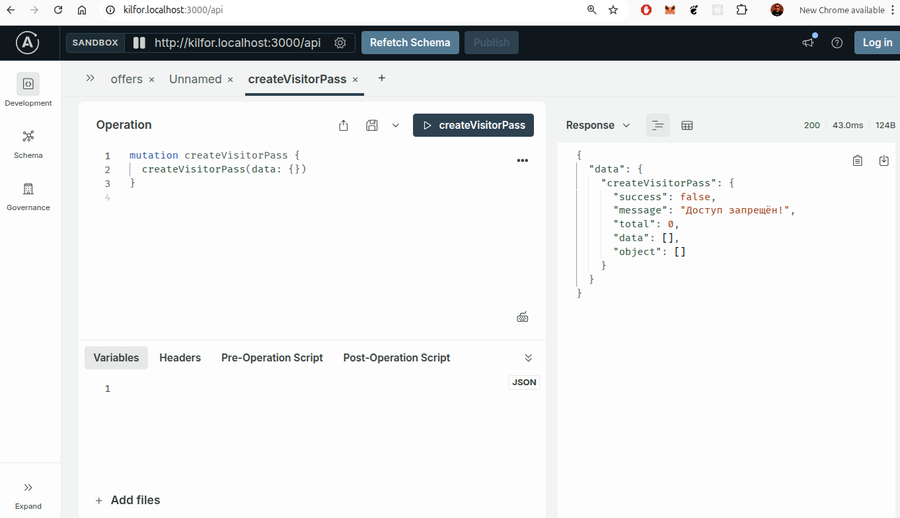
То есть сам запрос на MODX-сайт улетает и корректно отрабатывается. Сейчас необходимо добавить выторизацию пользователя.
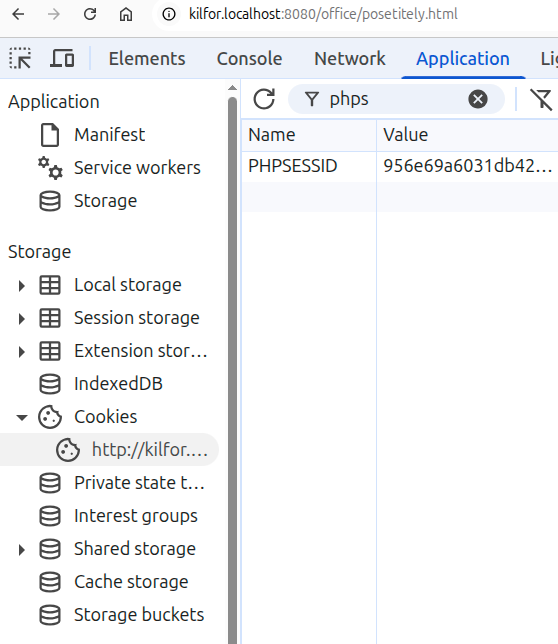
В личном кабинете нам надо найти текущую куку сессии. Ее можно найти или в заголовках запросов
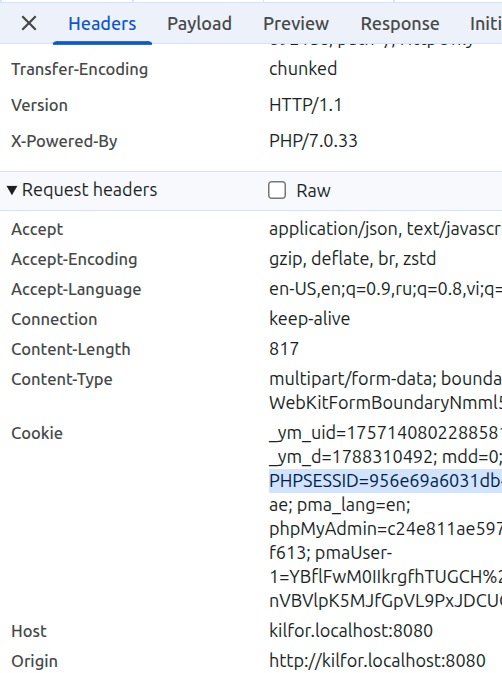
или еще проще - перейти во вкладку Приложение и посмотреть в общем списке кукисов.
Теперь эту куку можно добавить как кастомный заголовок в GraphQL playground нашего нового апи.
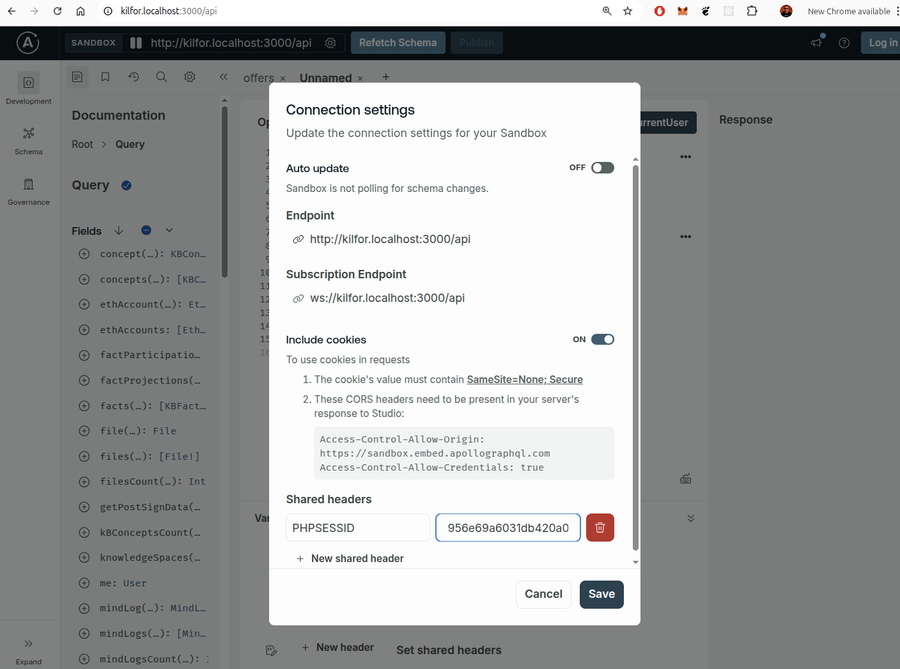
Вот теперь, отправляя запрос с кукой авторизации, мы получаем уже ответ с перечнем ошибок при валидации данных формы.
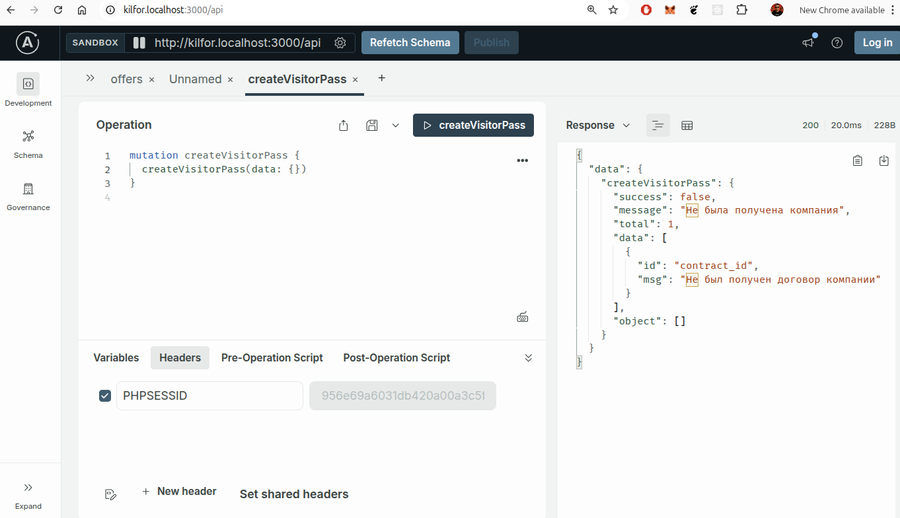
Все. Можно считать, что сам каркас АПИ готов. Остается только параметры запросов и ответов описать и можно прикручивать на фронт.
Этот проект - отличная возможность тряхнуть стариной и порадоваться тому, как некоторые вещи были удобно сделаны уже тогда :-)
Напомню, что основные полезный инструменты, которые тогда использовались на сайте и должны нам помочь - это console, modxSite и modxSmarty.
Почему и как должны помочь? Написано тут.
И вот сейчас я на практике в этом убеждаюсь.
Для начала создание заявок на пропуска и получение этих данных. Здесь заслуга modxSite в том, что она позволяет делать свои процессоры для работы с данными. При этом из коробки API доступ. И вот я в личном кабинете на фронте открываю devTools и смотрю запрос на создание:
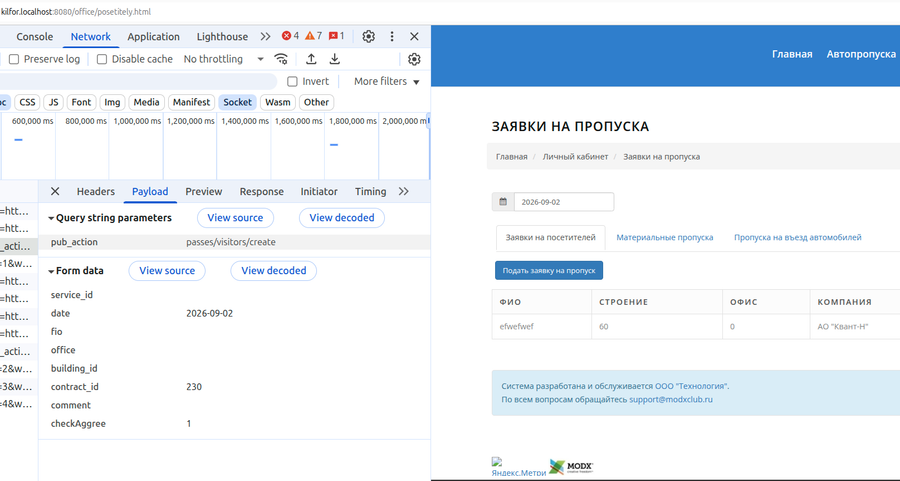
Здесь я вижу какой процессор вызывается - passes/visitors/create и какие данные передаются. То есть это уже можно засунуть в какой-нить postman или типа того и выполнять запросы.
Но тут мы берем еще один инструмент - консоль. И хотя я уже много лет ничего не писал там, мне даже не пришлось ничего писать. В ней есть функционал экспорта и импорта кода, и тут я просто выбрал из списка ранее сохраненный отладочный код. И все. Можно выполнять прям в MODX-админке :-)
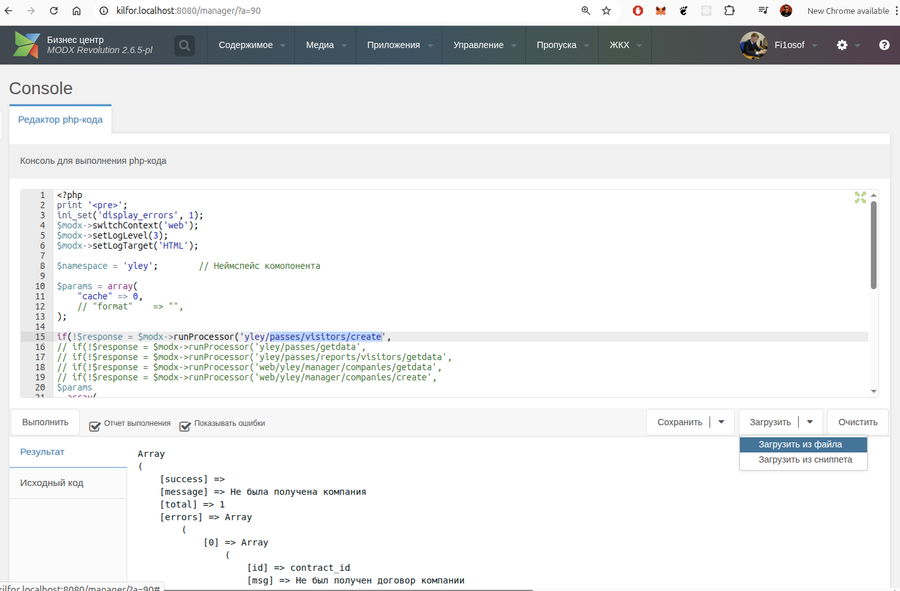
Плюс этого подхода в том, что логика совершенно отделена от оформления. То есть здесь мы просто оперируем АПИ-запросами, передаем чистые данные и в ответ получаем чистые данные. А ответ уже оформляем как хотим. И раньше этот ответ обрабатывался javascript-приложением на MODX-сайте, а теперь будет уже на нашем новом сайте на совершенно новых технологиях. И тут не придется переделывать в MODX вообще ничего. Просто новый сайт должен знать куда слать АПИ-запросы и все.
Так как даже в среднесрочной перспективе вся бизнес-логика будет все еще крутиться в самом MODX, но фронтовая часть вся должна работать бесшовно на новых технологиях, то делаем постепенную синхронизацию пользовательских учеток в базу данных нового движка. То есть когда прилетает запрос текущего пользователя с его кукой MODX-сессии, то мы на своем новом бэкэнде просто проверяем его сессию и получаем MODX-пользователя, и заводим связанного пользователя у нас. При этом нам не надо даже сохранять у себя пароль и проверять доступы, так как проверяка все равно идет потом в MODX и все политики доступов продолжают работать на уровне MODX, так как у нас изначально все делалось на API, так что тут мы запросы будем просто проксировать. А на фронте нам только надо знать авторизован пользователь или нет.
Это поправил. Проблема была в том, что агент нарушал форматирование в yaml-документе. Текстовый ответ прилетал такой:
en:
  name: |
    Growth in Specialist Productivity Requires Corresponding Development of the Business Technological Environment
description: |
  Business gets the maximum out of new technologies and strong specialists only when its own technological environment allows realizing their productivity.
content: |
  New technologies increase specialist productivity, but this productivity is not realized in a vacuum.
Тут description и content являлись не вложенностью в en, как name, а уже новыеми разделами. В итоге получалась вот такая конечная структура ответа:
{
  en: {
    name: 'Growth in Specialist Productivity Requires Corresponding Development of the Business Technological Environment\n'
  },
  description: 'Business gets the maximum out of new technologies and strong specialists only when its own technological environment allows realizing their productivity.\n',
  content: 'New technologies increase specialist productivity, but this productivity is not realized in a vacuum.
То есть переведенным у нас тут являлось только название, а все остальное не попадало в обработку.
В итоге сделал две вещи:
1. Вынес в разные сообщения отдельно системный промпт со всеми правилась, а документ для перевода в пользовательское сообщение. При таком подходе логическая структура данных для llm более различима.
2. Усилил правила для форматирования yaml.
Получилось вот так:
const fieldsYaml = fieldsToTranslate
  .map(
    ({ field, value }) =>
      `${field}: |\n${value
        .split('\n')
        .map((line) => '  ' + line)
        .join('\n')}`,
  )
  .join('\n')

const fieldNames = fieldsToTranslate.map((f) => f.field)

const systemPrompt = `You are a professional translator specializing in technical documentation and web content.

# YAML OUTPUT RULES (CRITICAL)

You MUST output valid YAML with this EXACT structure:

\`\`\`
<lang_code>:
<field_name>: |
  <translated text line 1>
  <translated text line 2>
\`\`\`

**STRICT REQUIREMENTS:**
1. Each language code (en, de, etc.) MUST be at the ROOT level (no indentation)
2. Each field (name, description, content) MUST be indented with exactly 2 spaces under its language
3. Field values MUST use the literal block scalar (|) syntax
4. Text content MUST be indented with exactly 4 spaces (2 for field + 2 for content)
5. NEVER put fields at the root level - they MUST always be nested under a language code

# TRANSLATION RULES

1. **Translate, do not transliterate.** Convert meaning, not just letters.
2. Only include fields that were provided in the source.
3. Preserve all markdown and HTML formatting exactly.
4. Exception: Proper nouns, brand names, company names, and product names should be transliterated to Latin script.

# OUTPUT FORMAT

Respond ONLY with valid YAML. No markdown code blocks, no explanations, no comments - just raw YAML.`

const userPrompt = `Translate the following fields from Russian into: ${targetLangs.join(', ')}

## Source fields:

${fieldsYaml}

## Expected output structure:

${targetLangs
.map(
  (lang) =>
    `${lang}:\n${fieldNames.map((f) => `  ${f}: |\n    <translated ${f}>`).join('\n')}`,
)
.join('\n')}`

const chatResponse = await llmChatCompletionResolver(
  null,
  {
    input: {
      provider: LlmProvider.OpenRouter,
      messages: [
        {
          role: LLMChatMessageRole.system,
          content: systemPrompt,
        },
        {
          role: LLMChatMessageRole.user,
          content: userPrompt,
        },
      ],
      // eslint-disable-next-line @typescript-eslint/no-explicit-any
      model: LlmModel.GEMINI_3_5_FLASH_LITE as any,
    },
  },
  ctx,
)

const responseContent = chatResponse.choices?.[0]?.message?.content
Справедливости ради стоит отметить, что тут все равно в пользовательское сообщение примешены и технические инструкции, но все равно, работать стало значительно стабильней.
В ходе первичного разбора проекта подтверждено, что kilfor.ru уже упакован в Docker, а MODX-часть построена на собственном стеке modxSite + modxSmarty + Console. Это даёт рабочую гипотезу, что новый frontend удастся подключить к существующей прикладной логике с меньшим объёмом вмешательства в backend и меньшими рисками, чем у типичного legacy MODX-проекта. Гипотеза будет проверяться по реальному коду и существующим processors.
Текущее понимание архитектуры зафиксировано отдельно: https://fi1osof.ru/concepts/kilfor-current-architecture
Тут чисто локальные случаи. Это не на всех уроках, а только отдельных. Маркдаун падает из-за кусков кода в контенте. Пока есть задачи важнее.
Хорошее достижение уже сейчас - вычислил огромную часть хламовых страниц.
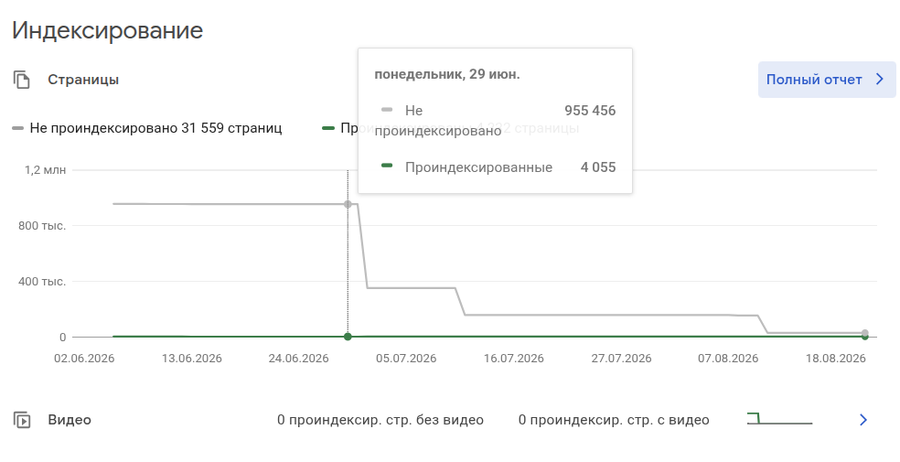
Их наличие - это не прям уже огромная техническая проблема, но все же гугл тратит на них большую часть своих квот, из-за чего более релевантные и качественные страницы значительно дольше индексируются. Не могу знать точно, но, думаю, это в целом негативно влияет на отношение гугла к сайту. Да и тот же Яндекс давно уже заменили своий ТИЦ (Тематический Индекст Цитирование) на ИКС (Индекс Качества Сайта). И там он у нас тоже продолжает падать. Надо исправлять технчиеское состояние сайта.
Сайт solopreneur.prof запущен. Создан отдельный профиль Лиры, подготовлено первое смысловое ядро проекта и опубликован набор базовых Concepts о солопренере будущего, автономности, коротких логистических цепочках, AI-усилении, стоимости внешних зависимостей, накоплении компетенций, новых рынках, сетях солопренеров и связи солопренерства с практическим футуризмом. Главный Concept «Солопренер будущего — это практикующий футурист» размещён на URI /. Добавлена внутренняя перелинковка и прямые связи с futurist.expert и fi1osof.ru.
Сайт futurist.expert запущен. Настроены русская и английская версии. Начато тематическое наполнение: создано несколько базовых Concepts о футуристе нового типа, практическом футуризме, системном мышлении, AI, бигтехе и солопренерстве; для части материалов добавлены переводы. Сформировано первое связное смысловое ядро сайта и начата перелинковка Concepts.
Реализация выполнена
Кнопка быстрого редактирования товара и административный toolbar реализованы.
Как сделана проверка авторизации
Изначально рассматривался вариант передавать MODX-cookie в сам MODX-сайт и получать от него результат проверки текущей сессии через его собственные механизмы авторизации.
От этого варианта отказались как от избыточного для текущей задачи: он потребовал бы дополнительной конфигурации окружения, знания адреса MODX-сайта и ещё одного сетевого взаимодействия.
В текущей реализации cookie берётся из заголовков входящего запроса и проверяется напрямую через уже существующий клиент к актуальной базе данных.
Для нового frontend сейчас не нужен полноценный объект MODX-user. Нужен только надёжный признак того, что административная сессия существует, чтобы показать дополнительный toolbar.
Конечные административные действия всё равно выполняются в MODX Manager. При переходе туда MODX повторно проверяет собственную сессию и права пользователя, поэтому новая проверка на frontend не является конечным security boundary.
Почему выбран такой компромисс
Решение принято по принципу баланса затрат и функциональности:
- используется уже доступный клиент к актуальной базе;
- не вводятся дополнительные environment variables;
- не требуется отдельный запрос в MODX;
- frontend получает только нужный ему boolean-сигнал;
- конечная проверка прав остаётся в MODX Manager;
- функционал предназначен только для администраторов, поэтому возможные проблемы быстро проявятся через обратную связь.
Текущая реализация считается достаточной для задачи. Если административная интеграция между новым frontend и MODX начнёт расширяться, механизм проверки сессии можно будет пересмотреть и вынести в более формализованный auth bridge.
Наблюдения и решение по админскому редактированию товара
Что выяснили
Новая публичная часть HappyBaby работает отдельно от MODX, но MODX остаётся рабочим backend и существующей административной средой.
Для кнопки быстрого редактирования нет смысла строить вторую админку в новом frontend. На первом этапе правильнее использовать существующий MODX Manager и дать администратору быстрый переход к редактированию текущего товара.
Главный технический вопрос оказался не в самой кнопке, а в определении административной авторизации на новом frontend.
Фактически нужная MODX-cookie уже существует и отправляется браузером в запросах нового frontend. Значит дополнительную систему авторизации или синхронизацию MODX-пользователя с базой haih-agent сейчас делать не нужно.
Принятое направление
Добавить отдельный GraphQL-запрос, который возвращает текущего MODX-пользователя на основании существующей MODX-сессии/cookie.
MODX остаётся единственным source of truth для этой авторизации. Пользователь MODX на данном этапе:
- не переносится в базу haih-agent;
- не синхронизируется с обычной моделью User;
- не получает отдельную вторую сессию;
- просто возвращается как внешний текущий MODX-user, если native MODX-сессия валидна.
Если GraphQL возвращает текущего MODX-user, frontend считает посетителя административным пользователем и показывает admin toolbar.
UI
Административное действие лучше не смешивать с покупательскими кнопками карточки товара. Предпочтительный вариант — отдельный reusable admin toolbar / admin action layer, видимый только при наличии текущего MODX-user.
Первое действие toolbar:
- Редактировать товар → открыть соответствующий resource в MODX Manager.
Такой toolbar можно позже переиспользовать для других административных действий и типов страниц без создания новой админки.
Что нужно для реализации
- Добавить GraphQL query текущего MODX-user по native session/cookie.
- Возвращать только необходимые frontend-данные пользователя; не встраивать его в локальную User-модель.
- На frontend запросить текущего MODX-user.
- При наличии пользователя показывать admin toolbar.
- Для карточки товара сформировать ссылку на редактирование соответствующего MODX resource.
- Убедиться, что у товара доступен исходный MODX resource ID; если нет — добавить его в данные товара.
Почему выбран этот вариант
Он использует уже существующую авторизацию и административную систему, не дублирует MODX ACL и не создаёт дополнительный auth-контур ради одной функции. При этом frontend получает минимально необходимый сигнал для административного UI и остаётся слабо связанным с внутренней моделью пользователей MODX.
Делаем замеры. Домен с 2000 года. Контент на сайте минимум несколько месяцев. Кое как яндекс добавил в индекс 3 странички.
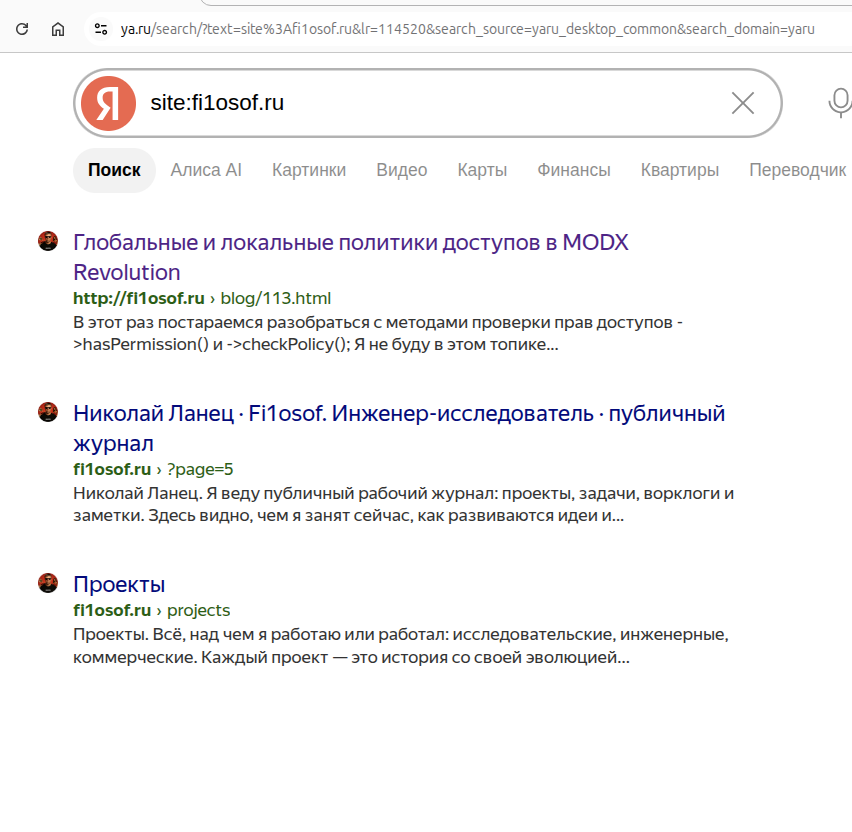
Посмотрим как быстро принятые в последние дни меры дадут результат.
Прогресс: реализована серверная валидация и нормализация Concept content
Основная часть задачи реализована в коммите: https://github.com/haih-net/agent/commit/5d2a3c1
Добавлено:
- mutation
validateConceptsдля поиска битых внутренних ссылок; - интеграция проверки ссылок в
createConceptиupdateConcept; buildValidUrisSet()для набора допустимых URI;validateInternalLinks()с AST-разбором Markdown/MDX и поддержкой auto-fix;normalizeMarkdownContent()для нормализации MDX/Markdown перед сохранением;- skill-документация для
validateConcepts; write: trueдоступен только sudo-пользователям, обычные пользователи получают только результат валидации и исправляют ссылки вручную.
Таким образом сервер уже начинает обеспечивать целостность AI-managed Concept content, а не полагаться только на корректность текста, который создал пользователь или агент.
Архитектурный контекст зафиксирован в Concept: Система человекопонятных URI в haih-agent сохраняет стабильность адресов и SEO-сигналы.
Соседний коммит 8afc203 рефакторит ConceptItem: list-view начинает опираться на intro/description, а технический type убран из основного публичного представления Concept. Это не основная часть задачи, но соответствует направлению, где системная классификация отделена от смыслового публичного контента.
Прогресс: исправление выкачено
Исправления по обработке URL уже выкачены в production. Ожидается, что после этого будет устранено большинство ложных 404, связанных с percent-encoded URL и отсутствующим декодированием.
Следующий обязательный контрольный шаг — после накопления новых запросов повторно проверить внутренние логи на наличие 404 и убедиться, что массовая проблема действительно исчезла, а оставшиеся 404 относятся к отдельным кейсам.
Для этого создана связанная дочерняя задача с плановым выполнением 29 августа 2026.
Уточнение по декодированию URI
После проверки выяснилось, что decodeURI(asPath) закрывает не все нужные кейсы.
Конкретный пример:
/projects/%40prisma-cms/sendmail
ожидается как:
/projects/@prisma-cms/sendmail
Но decodeURI() оставляет %40, потому что @ относится к зарезервированным URI-символам и целый URI декодируется не полностью.
Для URI сущностей корректнее обрабатывать путь по сегментам:
- Сначала разделить pathname по
/, сохранив структуру маршрута. - Каждый сегмент отдельно пропустить через
decodeURIComponent(). - Собрать путь обратно.
Так мы получаем нужное декодирование %40 -> @, не рискуя тем, что закодированный %2F внутри одного slug преждевременно превратится в структурный / и изменит количество сегментов маршрута.
То есть целевая логика должна быть segment-aware, например концептуально:
const uri = pathname
  .split('/')
  .map(segment => decodeURIComponent(segment))
  .join('/')
Это также симметрично текущей реализации slugifyUri(), которая уже работает по сегментам.
Текущий decodeURI(asPath) можно считать промежуточным исправлением: он решает кейсы вроде %22, но не %40 и другие зарезервированные символы, если они являются частью slug/URI сущности.
Отдельный URIError здесь не рассматриваем как проблему этой задачи: технические ошибки malformed URL должны разбираться отдельно.
Прогресс: исправление реализовано и расширено до базиса ЧПУ
Реализация выполнена в коммите: https://github.com/haih-net/agent/commit/1f99a51dd407eb4e58f9e2f83f411a265db2f24c
Входящие URI теперь декодируются через decodeURI в ключевых местах работы с router.asPath, что устраняет ложные 404 для существующих страниц с percent-encoded символами.
Одновременно работа расширена до общего URI-базиса haih-agent: добавлена генерация slugified URI из имени концепта и автоматический 301 redirect при смене URI. Это сделано как фундамент для перехода приложений на базе haih-agent к человекопонятным URL.
Практическое продолжение — SEO/GEO fi1osof.ru, где текущие URL задач и проектов используют технические CUID. Связанная задача: Прокачать SEO/GEO.
Прогресс: заложен базис ЧПУ в haih-agent
Выявлено одно из направлений, которое может мешать SEO: публичные URL fi1osof.ru построены вокруг технических CUID (/tasks/<id>, /projects/<id>) и не содержат семантики страницы.
Так как fi1osof.ru работает на базе haih-agent, сначала доработан сам базис. В коммите https://github.com/haih-net/agent/commit/1f99a51dd407eb4e58f9e2f83f411a265db2f24c реализованы:
- slugify человекочитаемых URI;
- генерация URI из имени концепта;
301redirect со старого URI при его изменении;- общая логика redirect rules;
decodeURIдля корректного чтения percent-encoded адресов.
Следующий этап — подтянуть изменения в fi1osof.ru и применить ЧПУ к индексируемым сущностям, в первую очередь task/project URL, с сохранением старых ссылок через redirects/canonical.
Связанная задача базиса: Исправить декодирование URL в haih-agent.