13 авг. 2026 г.
Запустил перевод еще на 8 языков. 742 страницы обработал за 9,5 часов.
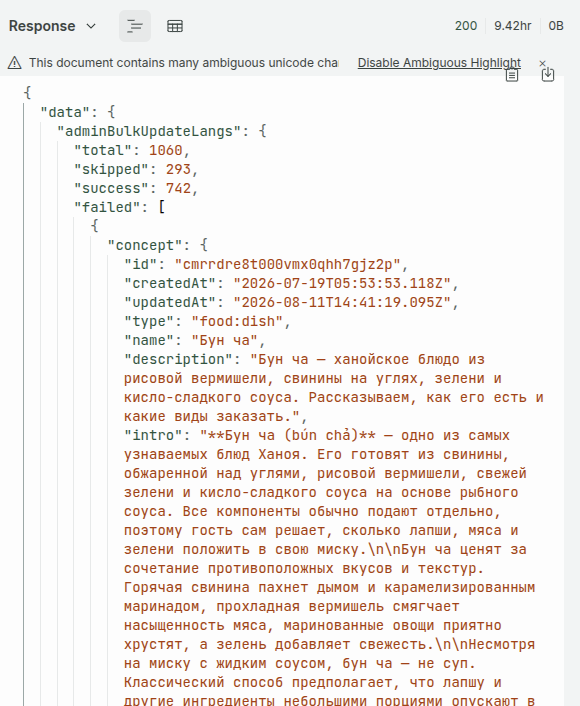
Стоило это 32 доллара.
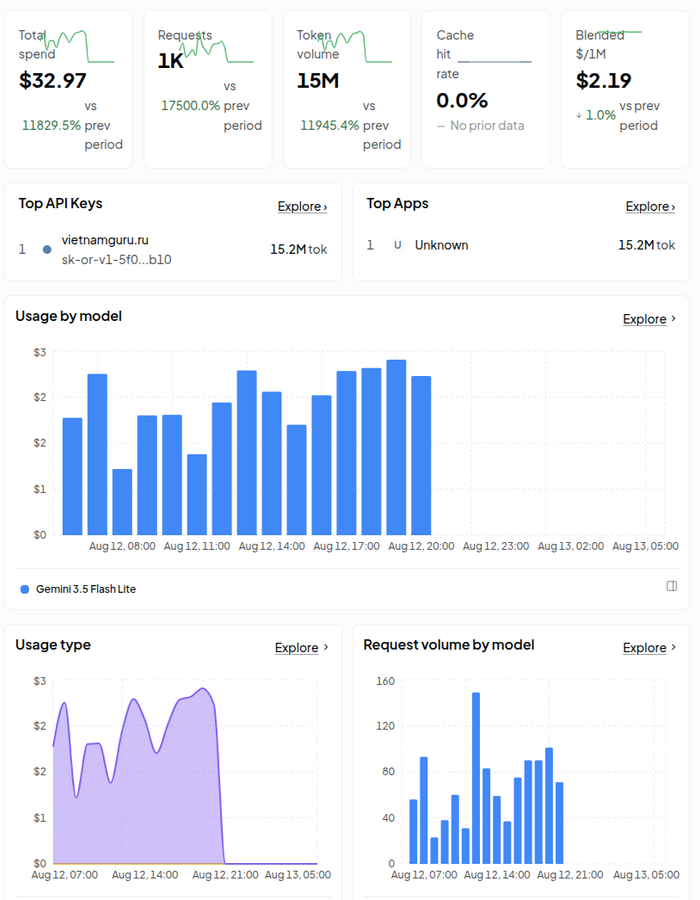
Запустил перевод еще на 8 языков. 742 страницы обработал за 9,5 часов.
Стоило это 32 доллара.
Добавил еще 8 языков. Обновление одной карточки (вот еще эти 8 языков) стоит 5 центов.
Запустил перевод всех страниц. В сам апдейт добавлен хелпер, который вычищает несуществующие ссылки (иногда ИИ придумывает) и делает он это через mdx-парсер. Эта механика попутно проверяет на корректность HTML-тегов в коде. Самая распространенная ошибка - неверный закрывающий тег (открывает один тег, а закрывает другой тег). Нарушение разметки приводит к ошибке и такие данные не записываются. Количество ошибок составило примерно 4% карточек.
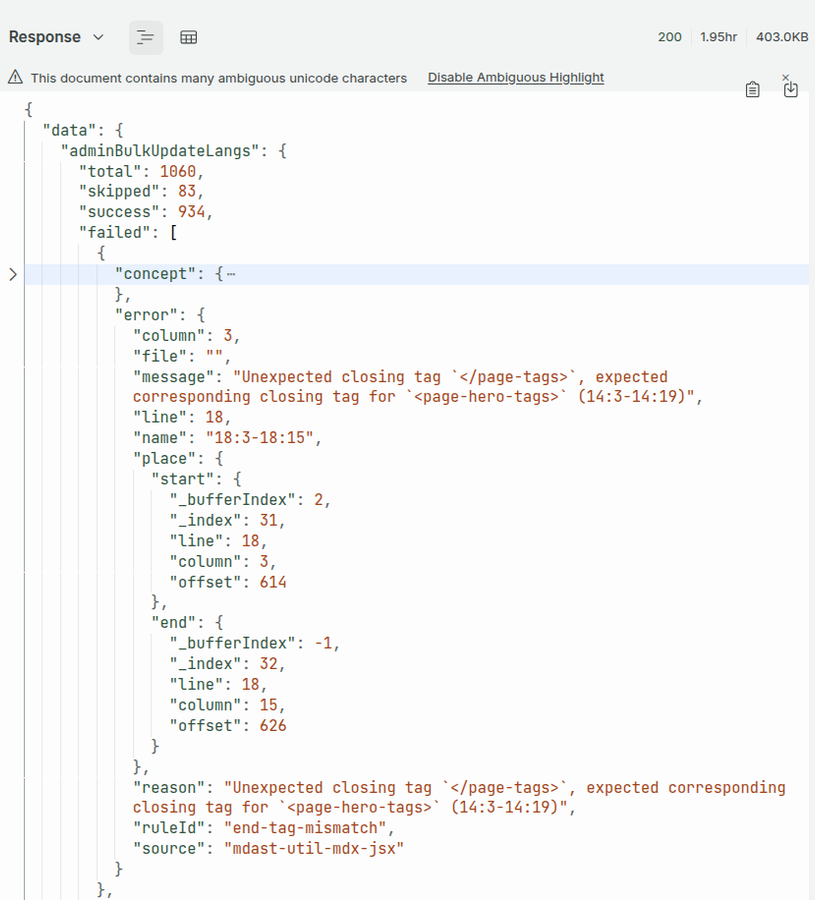
Но это ничего. Обрабатывались 1000 карточек 2 часа, а стоило все менее 9 долларов. Получается, примерно 1 рубль за карточку. Запущу прогон еще раз. Заполненные карточки пропускаются.
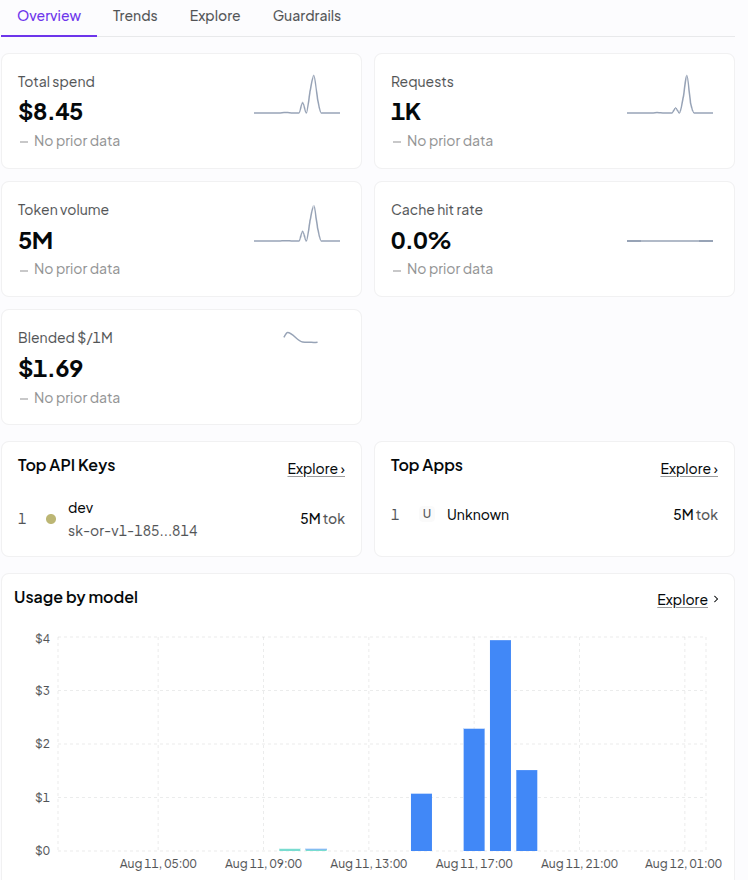
Добавил резолвер, который переводит карточку сразу на два языка - en, vi (за один запрос).
Переводит. Получилось примерно 10 рублей за перевод.
На вход принимает 4 поля: name, description, intro, content, при чем intro и content содержат в себе маркдаун в перемешку с HTML. content вообще само по себе довольно сложное поле, потому что содержит в том числе элементы шаблонизации.
Ответ LLM отдает в формате yaml, так как в таком случае меньше риск получить ошибку форматирования из-за какой-нибудь незакрытой кавычки. В итоге получается примерно такой ответ:
responseContent en:
  name: |
    Dalat
  description: |
    A mountain city at an altitude of 1,500 m in Vietnam's Central Highlands, known for its French colonial architecture, cool climate, and natural attractions. A popular tourist destination for travelers seeking a break from the coastal heat.
  intro: |
    Dalat is a city on the Langbiang Plateau at an altitude of 1,500 m in Lâm Đồng Province. It is known for its unique "eternal spring" microclimate with temperatures of 18–21 °C, French colonial-era architecture, and surrounding nature with waterfalls, lakes, and pine forests. Until July 2025, it served as the capital of Lâm Đồng Province.
  content: |
    <page-hero data-from="#1e3a5f" data-to="#0f172a" data-accent="#3b82f6">
      <page-hero-crumbs>
        [Home](/) / [Locations](/city) / Dalat
      </page-hero-crumbs>

vi:
  name: |
    Đà Lạt
  description: |
    Thành phố miền núi ở độ cao 1.500 m tại cao nguyên trung bộ Việt Nam, nổi tiếng với kiến trúc thuộc địa Pháp, khí hậu mát mẻ và các danh thắng thiên nhiên. Điểm đến du lịch phổ biến cho những du khách tìm kiếm sự nghỉ ngơi khỏi cái nóng ven biển.
  intro: |
    Đà Lạt là thành phố trên cao nguyên Langbiang ở độ cao 1.500 m thuộc tỉnh Lâm Đồng. Nổi tiếng với vi khí hậu "mùa xuân vĩnh cửu" độc đáo với nhiệt độ 18–21 °C, kiến trúc thời kỳ thuộc địa Pháp và thiên nhiên xung quanh với các thác nước, hồ nước và rừng thông. Cho đến tháng 7 năm 2025, nơi đây là tỉnh lỵ của tỉnh Lâm Đồng.
  content: |
    <page-hero data-from="#1e3a5f" data-to="#0f172a" data-accent="#3b82f6">
      <page-hero-crumbs>
        [Trang chủ](/) / [Địa điểm](/city) / Đà Lạt
      </page-hero-crumbs>
При настройке локального окружения для Next.js я столкнулся с довольно неприятным ограничением встроенного domain-based i18n routing.
Задача на первый взгляд простая: приложение использует разные домены для разных локалей, и локально хочется воспроизвести ту же схему. Например:
const nextConfig: NextConfig = {
  i18n: {
    locales: LOCALE_CODES,
    defaultLocale: 'en',
    localeDetection: false,
    domains: [
      {
        domain: 'vietnamguru-v3.localhost',
        defaultLocale: 'ru',
        locales: ['ru'],
        http: true,
      },
    ],
  },
}
Next.js официально поддерживает такую конфигурацию. Поле http: true существует в том числе для локального тестирования locale domains по HTTP вместо HTTPS.
Проблема начинается с порта.
i18n.domains нельзя нормально указать dev-портОбычный Next.js dev server работает на 3000:
http://vietnamguru-v3.localhost:3000
Логично было бы написать:
domains: [
  {
    domain: 'vietnamguru-v3.localhost:3000',
    defaultLocale: 'ru',
    locales: ['ru'],
    http: true,
  },
]
Но i18n.domains в Next.js рассчитан именно на домены, а не на произвольные origins.
Актуальный тип DomainLocale выглядит так:
export interface DomainLocale {
  defaultLocale: string
  domain: string
  http?: true
  locales?: readonly string[]
}
У него нет ни port, ни origin, ни какого-либо devPort.
Это само по себе было бы не так страшно, если бы Next использовал домен только для определения locale. Но domain routing влияет ещё и на генерацию ссылок.
<Link href="/place"> неожиданно становится абсолютной ссылкойВ приложении совершенно обычная ссылка:
<Link href="/place">
  Что посетить
</Link>
Без domain-based i18n от неё ожидаешь HTML примерно такого вида:
<a href="/place">Что посетить</a>
И браузер естественным образом открывает:
http://vietnamguru-v3.localhost:3000/place
То есть текущий origin, включая порт, сохраняется автоматически.
Но при включённом domain routing Next.js знает, что конкретная locale относится к конкретному домену. Поэтому он может сформировать для Link абсолютный locale-domain URL.
В результате получается:
<a href="http://vietnamguru-v3.localhost/place">
  Что посетить
</a>
И вот здесь :3000 уже потерян.
Это особенно неприятно потому, что в исходном JSX никакого абсолютного URL нет:
<Link href="/place">
Абсолютным его делает сам routing layer Next.js.
Получается парадоксальная ситуация:
Текущая страница:
http://vietnamguru-v3.localhost:3000/foo

JSX:
<Link href="/place">

Сгенерированный href:
http://vietnamguru-v3.localhost/place
Браузер совершенно справедливо воспринимает последний URL как HTTP на стандартном порту 80.
Вот это, пожалуй, главное ограничение.
В конфигурации domain i18n нет настройки в духе:
relativeLinks: true
или:
absoluteLocaleLinks: false
Нет возможности задать:
port: 3000
и нет отдельного dev-origin:
origin: 'http://vietnamguru-v3.localhost:3000'
То есть модель конфигурации фактически предполагает, что locale domain доступен на стандартном порту соответствующего протокола.
Для production это совершенно нормально:
https://example.com
https://example.fr
Для локальной разработки:
http://example.localhost:3000
— уже проблема.
http: true проблему не решаетНазвание поля сначала даёт надежду:
{
  domain: 'vietnamguru-v3.localhost',
  http: true,
}
Но оно отвечает только за выбор схемы:
https://
или:
http://
То есть Next получает достаточно информации, чтобы построить:
http://vietnamguru-v3.localhost/place
Но информации о том, что локальный сервер находится на 3000, в этой модели просто нет.
Архитектурно наиболее чистое решение — поставить перед Next локальный reverse proxy:
http://vietnamguru-v3.localhost
              |
              v
        localhost:3000
Например, через nginx, Caddy или другой локальный proxy.
Тогда Next продолжает генерировать:
http://vietnamguru-v3.localhost/place
и этот URL действительно работает.
Но для моего текущего dev environment это лишняя инфраструктура ради обхода ограничения framework.
Поэтому временное решение оказалось проще: запускать сам Next.js непосредственно на 80-м порту.
Сам запуск элементарный:
PORT=80 npm run dev
После этого:
http://vietnamguru-v3.localhost
действительно является адресом dev server, и абсолютные ссылки, генерируемые Next.js, начинают работать правильно.
Но появляется следующая проблема.
На Linux порты ниже 1024 традиционно являются privileged ports.
Поэтому обычный:
PORT=80 npm run dev
может закончиться ошибкой доступа при попытке Node.js забиндиться на порт 80.
Первая очевидная мысль:
sudo npm run dev
Но это плохой вариант сам по себе, а в моём случае ещё и практически нерабочий: Node/npm установлены не глобально в системное окружение.
Например, если Node управляется пользовательским version manager'ом, npm, который видит текущий shell, вовсе не обязательно существует в окружении sudo.
Получается классическая ситуация:
npm run dev
работает, а:
sudo npm run dev
— уже нет или запускает вообще другое Node-окружение.
И запускать весь dev server от root только ради возможности открыть один порт всё равно не хочется.
CAP_NET_BIND_SERVICE вместо запуска Node от rootВ Linux для этого существует capability CAP_NET_BIND_SERVICE.
Она позволяет конкретному executable открывать privileged network ports без запуска всего процесса от root.
Для текущего Node executable:
which node
можно выдать capability:
sudo setcap 'cap_net_bind_service=+ep' $(which node)
После этого Node можно продолжать запускать от обычного пользователя:
PORT=80 npm run dev
и процесс сможет слушать порт 80.
В результате локальная схема становится такой:
vietnamguru-v3.localhost
        |
        | :80
        v
   Next.js dev
а Next.js domain routing генерирует:
http://vietnamguru-v3.localhost/place
что теперь соответствует реальному адресу приложения.
Выдача CAP_NET_BIND_SERVICE самому node — не идеальное универсальное решение.
Capability назначается executable Node.js, а не конкретному Next.js-проекту. Следовательно, любой процесс, запущенный через этот конкретный Node binary от данного окружения, получает возможность bind'иться к privileged ports.
Кроме того, если Node установлен через version manager и версия Node переключается или переустанавливается, путь к executable может измениться. Capability тогда придётся назначать новому бинарнику заново.
Проверить текущие capabilities можно, например, так:
getcap $(which node)
Ожидаемый результат:
/path/to/node cap_net_bind_service=ep
При необходимости capability можно удалить:
sudo setcap -r $(which node)
Поэтому это именно удобный локальный workaround, а не настройка, которую стоит бездумно распространять на все development environments.
Проблема оказалась не в DNS, /etc/hosts, React или поведении браузера.
Она возникает из сочетания нескольких особенностей Next.js domain-based i18n:
i18n.domains описывает hostname, но не предоставляет отдельной настройки порта.http: true позволяет выбрать HTTP вместо HTTPS, но не задаёт dev-port.<Link href="/..."> в абсолютную ссылку на locale domain.3000 плохо сочетается с локальной эмуляцией domain-based locale routing.В моём случае временное решение получилось таким:
sudo setcap 'cap_net_bind_service=+ep' $(which node)
PORT=80 npm run dev
После этого локальный hostname можно использовать без явного порта:
http://vietnamguru-v3.localhost
и абсолютные locale-domain ссылки Next.js совпадают с фактическим origin.
Работает. Но довольно много инфраструктурных последствий для вещи, которая на уровне приложения выглядит всего лишь как:
<Link href="/place">
Актуальная документация Next.js по Pages Router подтверждает встроенную поддержку domain routing, структуру domains и назначение http: true именно для локального HTTP-тестирования.
Текущий тип DomainLocale в vercel/next.js содержит domain, defaultLocale, locales и http, но отдельной настройки порта в нём нет.
В документации по Link обычные внутренние переходы по-прежнему задаются относительными pathname (/, /about, /blog/...), то есть абсолютный locale-domain URL не требуется писать в JSX приложения.
На vietnamguru сделал так:
--- a/server/index.ts
+++ b/server/index.ts
@@ -49,11 +49,12 @@ async function startServer() {
   stopGraphql = stop

   if (withN8N) {
-    // Start n8n as child process (waits for API to be ready)
-    await initN8n()
-
-    // Run bootstrap (create owner, import credentials if needed)
-    await runBootstrap()
+    // Start n8n as child process in background (non-blocking)
+    initN8n()
+      .then(() => runBootstrap())
+      .catch((err) => {
+        console.error('[n8n] Failed to initialize:', err)
+      })
   }
Правда тут минус есть - если n8n развалится, сервер не перезапустится. Но с этим можно смириться, так как приоритетней быстрый запуск. А то за эти 10-15 сек простоя успевают набежать поисковики и потом пожаловаться на 502 ошибку.
Полдела сделано - добавил локали и роутинг
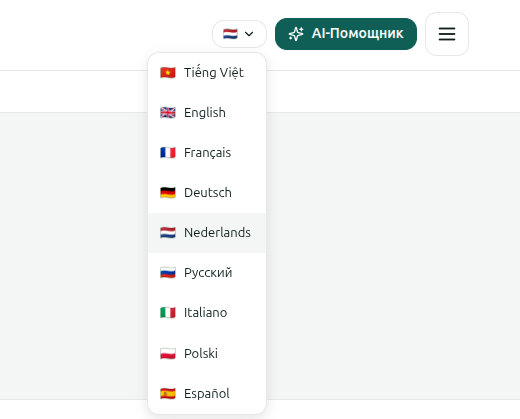
В моем случае реализаций нестандартная, потому что русский язык будет на текущем домене - https://vietnamguru.ru, а другие языке на новом международном домене - https://vietnamguru.travel
Сейчас надо добавить еще в базу хранение переводов, конечную логику и перевести все документы. Благо у меня по структуре почти все находится в самом контенте страницы и будет относительно не сложно все это сделать.
Получилось неплохо https://vietnamguru.ru/nam-homestays


А главное - стоимость наполнения почти нулевая, ис использованием ИИ. Первичный сбор информации в интернете - 5 рублей. Конечное форматирование страницы объекта - менее 1 рубля.
Конечная разметка, создаваемая ИИ-агентом, выглядит так:
<page-layout>
  <page-content>
    <page-section data-title="О месте">
      <page-prose>
        Nam My Van Homestay — это уютный семейный хостел в городе Тайнгуен, работающий с 2017 года под управлением семьи Чан Тхань Нама. Расположенный в 7 км от центра города, в оживленном студенческом районе промышленного университета Тайнгуена, хостел предлагает гостям подлинный опыт проживания среди местных жителей. Это место с высокими оценками за гостеприимство (9.2) и отличное соотношение цены и качества (9.1).
      </page-prose>
    </page-section>

    <page-section data-title="Атмосфера">
      <page-prose>
        Атмосфера дома максимально приближена к семейной: здесь можно ожидать теплого общения с хозяевами, которые всегда готовы помочь с планированием маршрутов, и звуков домашнего быта. Утро здесь начинается в спокойном районе, пронизанном студенческой энергией. В хостеле живут 7 собак, что придает месту дополнительный уют для любителей животных. Это идеальное пространство для тех, кто ищет искреннего, неформального общения с вьетнамской семьей, а не официальности сетевых отелей.
      </page-prose>
    </page-section>

    <page-section data-title="Кому подойдёт">
      <page-two-col>
        <page-card>
          <page-check-list data-label="Отлично для" data-variant="success">
            * Путешественников, ищущих аутентичный опыт
            * Гостей, ценящих общение с местными жителями
            * Бюджетных туристов
            * Поклонников спокойных жилых районов
          </page-check-list>
        </page-card>

        <page-card data-variant="warning">
          <page-check-list data-label="Может не подойти" data-variant="warning">
            * Аллергикам на животных (в доме живут 7 собак)
            * Любителям абсолютной тишины и приватности
            * Тем, кто ищет роскошь и отельный сервис
            * Путешественникам, предпочитающим центр города
          </page-check-list>
        </page-card>
      </page-two-col>
    </page-section>

    <page-section data-title="Номера">
      <page-room-grid>
        <page-room-card data-name="Стандартные номера" data-capacity="1-2 гостя">
          Различные конфигурации (односпальные или двуспальные кровати), кондиционер, вентилятор, письменный стол, балкон.
        </page-room-card>

        <page-room-card data-name="Однокомнатные апартаменты" data-capacity="2-3 гостя">
          Включают собственную кухню, кондиционер и балкон. Идеально для более длительного проживания.
        </page-room-card>
      </page-room-grid>
    </page-section>

    <page-section data-title="Удобства и еда">
      <page-two-col>
        <page-card>
          <page-check-list data-label="Удобства" data-variant="neutral">
            * Wi-Fi во всех номерах
            * Фитнес-зона во дворе
            * Прокат велосипедов
            * 24-часовой фронт-офис
            * Бесплатная парковка
          </page-check-list>
        </page-card>

        <page-card>
          <page-check-list data-label="Еда" data-variant="neutral">
            * Общая кухня с посудой и приборами
            * Завтрак (за доп. плату 35 000 – 50 000 VND)
          </page-check-list>
        </page-card>
      </page-two-col>
    </page-section>

    <page-section data-title="Контакты и ссылки">
      <page-prose>
        Вы можете связаться с хозяевами для уточнения деталей или забронировать проживание напрямую через удобные платформы.
      </page-prose>

      <page-links-grid>
        <page-link-card data-kind="phone" data-href="tel:+84941826262" data-hint="+84-941826262">Телефон</page-link-card>
        <page-link-card data-kind="booking" data-href="https://www.booking.com/hotel/vn/nam-my-van-homestay.vi.html">Booking.com</page-link-card>
        <page-link-card data-kind="agoda" data-href="https://www.agoda.com/nam-my-van-homestay_2/hotel/thai-nguyen-vn.html">Agoda</page-link-card>
      </page-links-grid>
    </page-section>

    <page-section data-title="Как добраться">
      <page-how-to-list>
        * От аэропорта Ной Бай: около 46 км (примерно 60 минут в пути).
        * Из центра города: 7 км, можно воспользоваться автобусом №1.
        * Услуга трансфера: возможен заказ трансфера из аэропорта (900 000 VND, макс. 3 человека).
        * Рекомендация: используйте Google Maps для навигации, так как место может быть сложно найти с первого раза.
      </page-how-to-list>
    </page-section>
  </page-content>

  <page-sidebar>
    <page-card data-title="Кратко">
      <page-info-row data-label="Формат">Семейный хоумстей</page-info-row>
      <page-info-row data-label="Цены">от 216 450 VND (\~10 USD)</page-info-row>
      <page-info-row data-label="Языки">Вьетнамский, Английский</page-info-row>
      <page-info-row data-label="Адрес">1121 Đ. 3/2, Tích Lương, Thái Nguyên 250000, Vietnam</page-info-row>
    </page-card>
  </page-sidebar>
</page-layout>
Трафик растет. А еше начинаем попадать в Алису и топ 10.


Переключил агента на использование https://polza.ai. Ничего переделывать не пришлось - просто указал их глюз и новый апи-ключ.
      "url": "https://polza.ai/api/v1",
      "apiKey": "pza_......................",
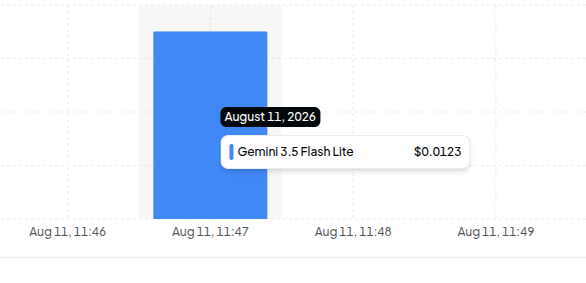
Запросы проходят очень быстро и стоят совсем недорого - у меня используется Gemini 3.5 Flash-Lite, даже с учетом того, что агент выполняет дополнительные тулзы, одно взаимодействие обходится где-то 20 копеек.

Вот такой раздел получился: https://vietnamguru.ru/activities

Сейчас картина выглядит так:


Вот такая штука получилась :-)


Добавил раздел: https://vietnamguru.ru/food
Надо теперь добавить создание объектов.
Для городов сделал, а для провинций пока нет, потому что у них координаты не заполнены.
Добавил очень прикольную ИИ-функцию :-) - редактирование контента с внутренними кросс-ссылками. Главная фишка - передача агенту всего набора внутренних ссылок и он автоматически в контенте заменяет простой текст на ссылки. Но тут ИИ как обычно не совсем корректно отрабатывает и местами придумывает несуществующие ссылки. Но это лечится - просто добавил построцессинг контента и он чистит контент от битых внутренних ссылок (благо контент весь в маркдауне и это делается сильно проще, чем с чистым HTML).
import { unified } from 'unified'
import remarkParse from 'remark-parse'
import remarkMdx from 'remark-mdx'
import remarkStringify from 'remark-stringify'
import { visit } from 'unist-util-visit'
import type { Link, Text } from 'mdast'
import type { Parent } from 'unist'

export interface ConceptLink {
  uri: string
}

export interface InvalidLink {
  url: string
  position?: {
    start: { line: number; column: number }
    end: { line: number; column: number }
  }
}

export interface ValidateInternalLinksResult {
  invalidLinks: InvalidLink[]
}

function isInternalLink(url: string): boolean {
  return url.startsWith('/')
}

export function buildValidUrisSet(concepts: ConceptLink[]): Set<string> {
  return new Set(concepts.map((c) => c.uri))
}

export async function removeInvalidLinks(
  content: string,
  validUris: Set<string>,
): Promise<string> {
  const tree = unified().use(remarkParse).use(remarkMdx).parse(content)

  visit(tree, 'link', (node: Link, index, parent: Parent | undefined) => {
    if (!parent || index === undefined) {
      return
    }

    const url = node.url

    if (isInternalLink(url) && !validUris.has(url)) {
      if (process.env.NODE_ENV === 'development') {
        console.error('Invalid url', url)
      }

      const textNode: Text = {
        type: 'text',
        value: node.children
          .filter((child): child is Text => child.type === 'text')
          .map((child) => child.value)
          .join(''),
      }

      parent.children.splice(index, 1, textNode)
    }
  })

  const result = unified()
    .use(remarkStringify, {
      bullet: '-',
      emphasis: '_',
      strong: '*',
    })
    .stringify(tree)

  return result
}
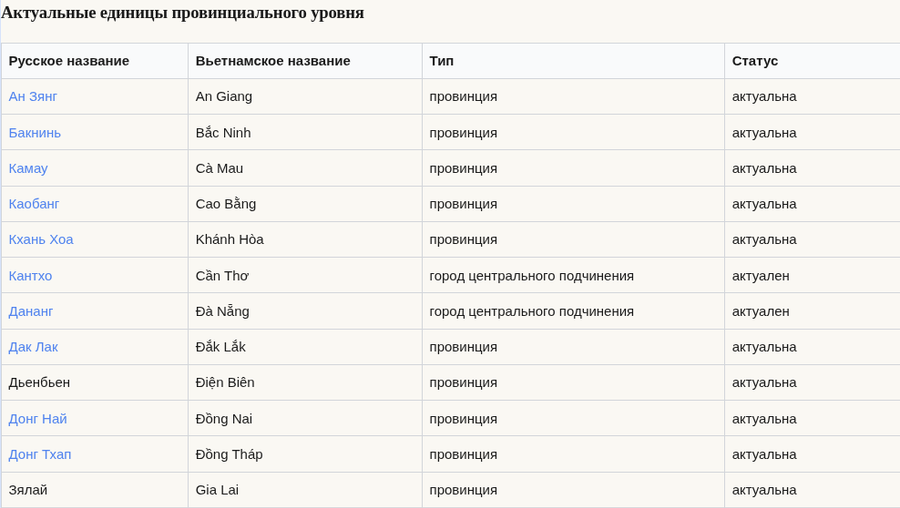
Вот для примера обработанная статья: https://vietnamguru.ru/content/reference/aktualniy-spisok-provintsiy-vetnama
Она изначально была написана без единой внутренней ссылки. А ссылок там должно быть много, так как это список провинций (и местами еще города). Самому вручную ее редактировать довольно муторно (надо же не только ссылки найти у себя на сайте, надо еще проверить существует ли у нас такая провинция в каталоге). Кстати, тут попутный плюс - сразу получили список отсутствующих провинций - сразу понятно что надо добавить в каталог. А так получился вот такой контент:
В версии 2.0 добавил автоматическое формирование хеша при загрузке.
Пока что просто вывел надпись, что раздел на реконструкции, и все внутренние страницы сделал постоянный редирект на нее.
Не буду цитировать всю переписку с чатгпт, но я полностью переосмыслил суть концептов и фактов и все свелось к тому, что нет смысла делать факты отдельными сущностями в нашей реализации. У нас сами концепты могут быть и фактами.
Вот краткая выжимка как я это вижу:
У нас не банковская система, чтобы строить подробные связи. У нас жизненный цикл информации такой:
1. Создается концепт, которого ранее еще не было. К примеру, Some Homestay.
2. В нем прописывается в обычном текстовом виде все, что хочется передать. Это все то, что потом прочитает пользовать. В нашем проекте по сути это само по себе факт, потому что весь контент создаем мы. И мы сразу указываем качественные признаки что есть что. Со временем, когда эта информация окажется некачественная, мы просто понизим ее качественный признак. Условно, нам достаточно сейчас только одной метрики от 0 до 1 флоэт. Чем выше качество, тем выше видимость. К примеру, у меня на сайте полно старых статей, которые уже не нужны, их надо выкинуть, но я не могу их выкинуть, ибо 404 не круто. Мне надо просто их дальше засунуть
3. Связка с другими концептами. То есть мне нужна просто перелинковка. Как и в классических сайтах, я просто могу добавить ссылки на другие концепты. Это чтобы пользователь мог читать и переходить в попутные карточки. Но это связь внешняя. А мне нужна и обратная. Соответственно, у меня не просто связи ссылки анкор тут нужны, а попутная техническая информация связи (почему я на это ссылаюсь и опять-таки, какой-то качественный признак).
4. При сохранении такого концепта пересчитываются все его эти связи. Те, что были удалены из содержимого, удаляются и из списка связей. А добавленные появляются.
Вот тут нам как раз и нужна плоская таблица связей концептов многие-ко-многим. Тут можно тогда посмотреть общую семантику всей базы знаний.
И тут я вот что думаю, если эту идею развивать. Можно сделать полную сементику на уровне HTML-тегов. Мы в тексте просто вставляем ссылки. При этом у них есть innerText, title, rel, data-атрибуты и т.п. Все это можно зеркалить с нашей индекс-таблицей связей. При этом parent и root остаются как жесткие связки
Вот что чатгпт подытожила:
Да, это уже выглядит очень цельно.
Тогда HTML/Markdown-контент становится первичным семантическим графом, а таблица связей — его материализованным индексом для быстрых запросов и обратной перелинковки.
При этом:
parentId — жёсткая непосредственная иерархия;rootId — принадлежность к одному дереву или разделу;Например, в редакторе:
<a
  href="/places/som-homestay"
  data-concept-id="som-homestay-id"
  data-relation="overnight"
  data-context="Подходящий ночлег перед ранним посещением пещеры"
  data-quality="0.9"
  title="Som Homestay — ночлег рядом с пещерой"
>
  переночевать в Som Homestay
</a>
Здесь уже содержится почти вся нужная семантика:
href — публичный адрес;data-concept-id — стабильная техническая идентичность;innerText — естественный анкор;title — дополнительное пояснение пользователю;data-relation — тип смысловой связи;data-context — почему ссылка появилась;data-quality — сила или полезность связи.Из неё создаётся индексная запись:
sourceId: cave-id
targetId: som-homestay-id
relation: overnight
anchor: переночевать в Som Homestay
title: Som Homestay — ночлег рядом с пещерой
context: Подходящий ночлег перед ранним посещением пещеры
quality: 0.9
relЯ бы осторожно использовал стандартный HTML-атрибут rel.
Он уже имеет браузерную и SEO-семантику:
nofollow;ugc;sponsored;noopener;noreferrer;alternate;author;tag.Свою предметную семантику безопаснее хранить отдельно:
data-relation="overnight-before"
А стандартный rel использовать по назначению:
rel="ugc nofollow"
Иначе позднее можно столкнуться с конфликтом между собственной моделью и HTML-стандартом.
Для ручной работы в редакторе слишком много атрибутов будет мешать. Поэтому обязательными я бы сделал только:
<a
  data-concept-id="..."
  data-relation="..."
>
  текст ссылки
</a>
Остальное можно определить автоматически:
href — получить через SiteRoute;anchor — взять из innerText;title — сгенерировать из связанного концепта;quality — использовать значение по умолчанию;context — извлечь из окружающего предложения;position — вычислить парсером.Расширенный режим нужен только там, где автор хочет явно переопределить семантику:
<a
  data-concept-id="..."
  data-relation="overnight"
  data-quality="0.95"
  data-context="Лучший ночлег перед ранним выездом"
>
  Som Homestay
</a>
Допустим, написано:
Перед ранним посещением пещеры лучше
<a data-concept-id="som-id">переночевать в Som Homestay</a>,
поскольку дорога утром занимает всего около 30 минут.
Даже без явного data-relation агент или парсер может вывести:
relation: overnight_before
context: ночлег перед ранним посещением пещеры
Но я бы различал:
Например:
origin: explicit
или:
origin: inferred
confidence: 0.72
Не обязательно показывать это редактору. Это техническая информация индексной таблицы.
enum KBConceptRelationOrigin {
  explicit
  inferred
  generated
}

model KBConceptRelation {
  id        String   @id @default(cuid()) @db.VarChar(36)
  createdAt DateTime @default(now()) @db.Timestamp(3)
  updatedAt DateTime @default(now()) @updatedAt @db.Timestamp(3)

  sourceId String
  Source   KBConcept @relation(
    "ConceptRelationSource",
    fields: [sourceId],
    references: [id],
    onDelete: Cascade
  )

  targetId String
  Target   KBConcept @relation(
    "ConceptRelationTarget",
    fields: [targetId],
    references: [id],
    onDelete: Cascade
  )

  relation String? @db.VarChar(100)

  anchor  String? @db.Text
  title   String? @db.Text
  context String? @db.Text

  quality   Float @default(0.5)
  confidence Float?

  origin KBConceptRelationOrigin @default(explicit)

  // Стабильный идентификатор конкретной ссылки в редакторе
  nodeId String? @db.VarChar(100)

  // Положение в содержимом
  position Int?

  // Исходные или дополнительные HTML-атрибуты
  data Json?

  @@unique([sourceId, nodeId])
  @@index([sourceId])
  @@index([targetId])
  @@index([sourceId, relation])
  @@index([targetId, relation])
  @@index([quality])
}
quality и confidence здесь имеют разный смысл:
quality — насколько связь полезна для пользователя;confidence — насколько уверенно определена её семантика.Для явно заданной ссылки:
origin = explicit
confidence = 1
Для автоматически распознанной:
origin = inferred
confidence = 0.74
На первом этапе confidence можно вообще не добавлять.
Если просто использовать sourceId + targetId, возникнет проблема: один текст может ссылаться на один концепт несколько раз по разным причинам.
Например:
<a
  data-node-id="link-a17"
  data-concept-id="som-id"
  data-relation="overnight-before"
>
  ночлег перед посещением
</a>

<a
  data-node-id="link-b24"
  data-concept-id="som-id"
  data-relation="cold-weather-warning"
>
  зимой здесь может быть холодно
</a>
Это две самостоятельные связи с одной и той же целью.
data-node-id должен создаваться редактором автоматически и сохраняться при перемещении ссылки внутри документа.
Тогда синхронизация при сохранении проста:
nodeId — обновляется;nodeId — добавляется;nodeId — удаляется.Здесь желательно избежать двустороннего редактирования.
Я бы зафиксировал:
Контент является источником истины для исходящих редакционных связей.
Таблица — индекс.
Значит:
Иначе появится рассинхронизация: таблица говорит одно, HTML — другое.
Автоматические связи можно хранить отдельно от контентных и не зеркалить в HTML до явного принятия.
Если в карточке пещеры есть:
<a
  data-concept-id="som-id"
  data-relation="overnight-after"
>
  Som Homestay
</a>
То на странице Som Homestay можно автоматически вывести:
Подходит для ночлега после посещения
Пещера X — автор рекомендует этот хоумстей как ночлег после посещения.
Или встроить в текст динамический блок:
<concept-backlinks
  data-relation="overnight-after"
  data-limit="5"
></concept-backlinks>
Причём обратное представление не обязано повторять исходный анкор. Оно строится из:
parent и root действительно стоит оставитьОни решают другую задачу.
parentIdЖёсткая принадлежность или основной контейнер:
Тхай Нгуен
└── Som Homestay
либо структура контента:
Жильё
└── Хоумстеи
    └── Som Homestay
Нужно только выбрать один смысл parentId и не смешивать несколько иерархий.
Например:
parentIdвсегда означает редакционную принадлежность к основному разделу.
rootIdУскоряет:
Всё остальное:
идёт через индекс ссылок.
Можно начать с обычной ссылки:
<a data-concept-id="som-id">Som Homestay</a>
А тип отношения определять по трём уровням:
data-relation.Например:
<section data-semantic-context="recommended-overnight">
  <p>
    Перед поездкой лучше остановиться в
    <a data-concept-id="som-id">Som Homestay</a>.
  </p>
</section>
Здесь каждая ссылка внутри секции наследует:
relation = recommended_overnight
Это может сильно упростить ручную разметку.
То же самое в Markdown-компонентах:
:::semantic{relation="overnight-before"}
Перед ранним посещением лучше остановиться в
[Som Homestay](concept:som-id).
:::
Для точной индивидуальной связи:
<a data-relation="alternative">
Для общего контекста:
<p data-semantic-context="winter-warning">
Для группы ссылок:
<section data-semantic-context="where-to-stay">
Для динамической выборки:
<concept-list
  data-relation="overnight-before"
  data-source="current"
></concept-list>
Парсер может наследовать семантику сверху вниз:
link.relation
  ?? paragraph.semanticContext
  ?? section.semanticContext
  ?? inferredFromText
  ?? "reference"
У тебя появляется четыре согласованных уровня:
Жёсткое дерево:
parentId / rootId

Авторский смысл:
HTML-контент и ссылки

Быстрый граф:
KBConceptRelation

Динамическое представление:
обратные ссылки, списки и агентские блоки
Это очень практичная архитектура. Она не требует отдельно описывать весь мир в таблицах: семантика возникает прямо в процессе написания нормального человеческого текста, а база лишь материализует её для поиска, анализа и обратного использования.
Еще информация от чатгпт
Да, с такой схемой техническая сторона не является ограничением. Более того, у тебя уже есть почти всё необходимое для туристического knowledge graph — просто сейчас он описан в универсальных терминах.
Главное наблюдение: не нужно создавать отдельные таблицы под каждую туристическую сущность. Провинции, города, места, активности, потребности, сценарии и комплексы могут быть KBConcept, а смысл отношений между ними — KBFact с участниками через KBFactParticipation. Именно для этого твоя n-арная модель подходит особенно хорошо.
У тебя уже есть пять очень сильных уровней.
KBConcept — универсальный семантический узел:
При этом есть:
type;parentId;rootId;data;KBLabel;SiteRoute.То есть это уже готовая основа для каталога и графа одновременно.
KBFact — это не просто ребро графа, а полноценное утверждение:
А KBFactParticipation позволяет одному факту связать любое число объектов с разными ролями.
Например, утверждение:
VinWonders подходит семье с детьми для двухдневного отдыха в сухую погоду.
Можно выразить одним фактом:
KBFact.type = "visit_suitability"
Участники:
VinWonders       role=destination
Семья с детьми   role=audience
Два дня          role=recommended_duration
Сухая погода     role=preferred_condition
Уже это намного выразительнее обычной таблицы place_tags.
Для туризма это критично.
У тебя факт может иметь:
validFrom;validTo;knownSince;confidence;status;source.Значит, можно нормально хранить:
Причём новое знание не обязано перезаписывать старое. Это идеально соответствует реальной туристической информации.
KBConflict и KBConstraint позволяют не притворяться, что база всегда знает истину.
Например:
Вместо случайного выбора можно сохранить три факта и открыть конфликт value_mismatch.
Для кнопки «Что важно знать сейчас» это особенно ценно:
Официальная цена — 500 000 ₫, но в двух свежих источниках указана цена 600 000 ₫. Рекомендуем проверить перед поездкой.
Это гораздо честнее обычной базы данных.
KBKnowledgeSpace и KBFactProjection позволяют один и тот же факт по-разному интерпретировать в разных контекстах.
Например:
Один факт может иметь разную:
Это позволяет не смешивать редакционно подтверждённые данные с пользовательскими советами.
Я бы не создавал десятки Prisma-моделей вроде Province, City, Place, Activity, Need, Scenario.
Вместо этого — ограниченный словарь типов KBConcept.type.
Например:
geo_country
geo_province
geo_city
geo_district

place
place_complex
place_component
transport_hub

place_type
activity
service
need
interest
avoidance
audience
condition
season
time_window
duration
scenario

route
route_segment
route_day
trip
Это не обязательно сразу делать enum в Prisma. На раннем этапе строковый type даже полезнее — он позволяет развивать онтологию без миграции схемы.
Но сам словарь типов стоит централизовать в коде.
Для административной структуры достаточно parentId:
Вьетнам
└── Кханьхоа
    ├── Нячанг
    └── Камрань
Но parentId следует использовать только для настоящей иерархии.
Не стоит через него выражать:
Для этого нужны факты.
Например:
Fact.type = "located_in"
place       role=subject
city        role=container
Почему не ограничиться parentId? Потому что объект может одновременно находиться:
Это уже не дерево, а граф.
Твой текущий «тип места» — это отдельный KBConcept:
Водопад
Пещера
Грот
Пагода
Казино
Ресторан
Дайвинг-центр
Связь:
Fact.type = "has_type"

place      role=subject
placeType  role=type
Один объект может иметь несколько типов.
Например, база отдыха:
Экопарк
Кемпинг
Природный комплекс
Зона купания
Ресторанный комплекс
Это лучше, чем поле typeId, потому что составные объекты почти никогда не укладываются в одну категорию.
Твой пример:
Если человек не хочет пещеры, ему не нужны гроты.
Нужно связать сами типы.
Fact.type = "semantic_subtype"

Грот      role=child
Пещера    role=parent
Можно построить такую онтологию:
Подземные природные объекты
├── Пещера
├── Грот
├── Подземная река
├── Карстовый тоннель
└── Спелеологический маршрут
Но здесь есть важное разделение.
parentId можно использовать для строгой классификации:
грот является разновидностью подземного объекта.
А KBFact — для мягких отношений:
similar_to
commonly_combined_with
may_trigger_same_avoidance
alternative_to
Например:
Тоннели Кути — не пещера, но могут быть нежелательны человеку с боязнью замкнутых пространств.
Здесь таксономия не поможет. Нужна связь с концептом:
Замкнутые пространства
Факт:
Fact.type = "has_experience_attribute"

Тоннели Кути            role=subject
Замкнутые пространства  role=attribute
Тогда пользовательское исключение применяется по атрибуту опыта, а не только по категории.
Это ключевой момент.
Например, «пещера» описывает физический объект. Но пользователю важнее:
Поэтому нужны концепты типа experience_attribute:
indoor
outdoor
underground
water_based
physically_demanding
formal_friendly
muddy
crowded
quiet
romantic
family_friendly
weather_sensitive
Связи:
Fact.type = "has_experience_attribute"
Fact.type = "requires_condition"
Fact.type = "conflicts_with_condition"
Пример с вечерним платьем:
Пользовательский контекст:
formal_clothing = true
Объект:
Водопад
has_experience_attribute = wet
has_experience_attribute = uneven_terrain
has_experience_attribute = outdoor
Система делает вывод не потому, что «вечернее платье несовместимо с водопадом» записано вручную, а через признаки.
А вот ресторан, казино или театр имеют:
formal_friendly
indoor
evening_suitable
Я бы оформил потребности как концепты:
Поесть
Переночевать
Искупаться
Купить одежду
Развлечь детей
Провести вечер
Посмотреть природу
Избежать переездов
Провести день в дождь
Получить активный опыт
Отдохнуть
Связь:
Fact.type = "satisfies_need"

place  role=provider
need   role=need
У участия можно использовать value для силы:
value = "0.9"
Или localImportance, хотя семантически лучше не смешивать важность факта и силу удовлетворения потребности. Для вычисляемых значений я бы добавил структурированный data в факт либо отдельное числовое поле.
Например:
{
  "strength": 0.9,
  "capacity": "full",
  "notes": "Можно провести полный день"
}
Сейчас у KBFact нет общего data, и это одно из немногих расширений, которое я бы действительно рассмотрел.
Тебе точно нужна семантика составного объекта, но необязательно отдельная Prisma-модель.
Концепт:
KBConcept.type = "place_complex"
Например:
VinWonders Nha Trang
База отдыха X
Национальный парк Phong Nha
Курортный кластер
Компоненты — обычные места или сервисы.
Связь:
Fact.type = "part_of_complex"

аквапарк       role=component
VinWonders     role=complex
Но можно сделать более богатый факт:
Fact.type = "complex_composition"
Участники:
VinWonders       role=complex
Аквапарк         role=component
Пляж             role=component
Отель            role=component
Ресторан         role=component
Шоу              role=component
Я всё же предпочёл бы отдельный факт на компонент, потому что:
Например:
Fact.type = "complex_component"
subject = Аквапарк
container = VinWonders
access_mode = included_ticket
При этом statement может быть человекочитаемым, а детали — в структурированных данных.
Это не одно поле duration.
Нужно различать:
Например, для VinWonders:
minimum_meaningful_duration = 1 day
recommended_duration = 2 days
maximum_stay_without_repetition = 3 days
overnight_available = true
self_contained = true
Это можно представить несколькими фактами:
recommended_duration
supports_overnight_stay
self_sufficiency
activity_capacity
self_sufficiency — особенно важная метрика.
Например:
0.1 — отдельная смотровая площадка
0.4 — достопримечательность с кафе и парковкой
0.7 — база отдыха на полный день
0.95 — курортный комплекс на несколько дней
Её можно вычислять из:
Я бы не хранил её только вручную. Лучше хранить исходные факты, а итоговую оценку создавать как KBFactType.derived с derivedFrom.
У тебя для этого уже есть factType и derivedFrom.
Твоя модель позволяет сделать их намного богаче, чем простое placeAId/placeBId.
Fact.type = "works_well_together"

Место A  role=place
Место B  role=place
Но лучше сразу добавить контекст:
Место A           role=place
Место B           role=place
Один день         role=duration
Семья с детьми    role=audience
Сухая погода      role=condition
Тогда факт означает:
Эти места хорошо объединяются в один день для семьи с детьми в сухую погоду.
N-арная модель особенно полезна:
Fact.type = "recommended_visit_cluster"

Гора          role=anchor
Ручей         role=optional_stop
Пещера        role=optional_stop
Ресторан      role=meal_stop
База отдыха   role=overnight_base
Полтора дня   role=recommended_duration
Это уже полноценный фрагмент маршрута, но ещё не пользовательский маршрут.
Это две разные сущности.
Объективная или редакционная связка:
Эти объекты географически и сценарно образуют единый комплекс посещения.
Тип:
KBConcept.type = "visit_cluster"
Примеры:
Конкретная последовательность:
Сначала гора, затем ручей, потом ресторан, ночёвка на базе.
Тип:
KBConcept.type = "route"
Маршруту нужны упорядоченные сегменты.
Текущая KBFactParticipation сама по себе не хранит порядок. value можно использовать как 1, 2, 3, но это будет не очень чисто.
Я бы добавил в KBFactParticipation:
position Int?
data     Json?
Тогда один факт типа route_composition может содержать:
Гора        role=stop position=1
Ручей       role=stop position=2
Ресторан    role=stop position=3
База        role=stop position=4
И у каждого участия в data:
{
  "arrivalTime": "09:00",
  "durationMinutes": 120,
  "optional": false
}
Это одно из наиболее практически полезных расширений твоей схемы.
Их можно хранить двумя способами.
Пользователь — тоже концепт либо связан с концептом профиля.
Например:
Fact.type = "user_preference"

UserConcept       role=subject
Пещеры            role=target
Не нравится       role=preference
Но лучше формализовать:
likes
dislikes
avoids
requires
prefers
neutral_to
Пример:
Fact.type = "avoids"

Пользователь                  role=subject
Замкнутые пространства        role=target
Тогда исключаются:
если они связаны с этим experience attribute.
Для конкретной поездки можно создать KBKnowledgeSpace:
Поездка во Вьетнам, август 2026
Туда проектируются:
Это очень естественно ложится на твою модель.
Например:
Поэтому нужны разные контексты:
Глобальный профиль пользователя
Конкретная поездка
Конкретный день
Текущая сессия
Именно KnowledgeSpace позволяет не превращать временное условие «сегодня я в вечернем платье» в постоянное свойство пользователя.
Можно разложить итоговый score на компоненты:
intent_match
need_coverage
avoidance_conflict
context_fit
time_fit
geographic_fit
route_synergy
weather_fit
novelty
quality
confidence
Примерно:
score =
  0.22 * intent_match +
  0.18 * need_coverage +
  0.15 * geographic_fit +
  0.12 * time_fit +
  0.12 * route_synergy +
  0.08 * weather_fit +
  0.08 * quality +
  0.05 * novelty
  - hard_conflicts
Но я бы не фиксировал единую формулу навсегда. Вес зависит от сценария.
Для запроса «найти ресторан рядом»:
Для двухнедельного маршрута:
Лучше представить сам профиль оценки как концепт:
restaurant_now_profile
family_day_trip_profile
multi_day_route_profile
formal_evening_profile
А веса — как факты или data.
Это стоит разделять обязательно.
Объект не должен попасть в результат:
Объект может попасть ниже:
Твоя KBConstraint подходит для декларативных правил, а KBConflict — для фиксации нарушений.
Например:
constraint:
"Маршрут пользователя, избегающего underground experience,
не должен содержать места с атрибутом underground."
Но я бы не создавал KBConflict для каждого кандидата, отклонённого рекомендательной системой. Конфликт нужен для значимых противоречий знаний или уже сформированного маршрута, а не для обычной фильтрации.
У тебя фундамент уже есть. Я бы не делал большой рефакторинг.
model KBFact {
  ...
  data Json?
}
Нужно для:
Например:
{
  "minMinutes": 180,
  "recommendedMinutes": 360,
  "maxMinutes": 720
}
model KBFactParticipation {
  ...
  position Int?
  data     Json?
}
Нужно для:
Для частых актуальных запросов:
@@index([status])
@@index([validFrom, validTo])
@@index([type, status])
Сейчас у KBFact в приведённой схеме индексируется только type. Для кнопки «Что важно знать сейчас» запросы по валидности и статусу будут очень частыми.
Сейчас lat/lng индексируются обычным составным B-tree индексом. Для реального «что рядом» лучше PostGIS:
geography(Point, 4326)
GIST index
Можно сохранить lat/lng для Prisma-удобства, а географическую точку держать дополнительно либо перейти на raw SQL extension.
С твоим опытом это, вероятно, очевидный шаг: для радиусных и маршрутных запросов обычный индекс координат быстро станет ограничением.
Поля KBConcept.type, KBFact.type, KBFactParticipation.role строковые. Это даёт гибкость, но легко получить:
located_in
located-at
location
belongs_to_city
Поэтому нужен кодовый registry:
export const ConceptType = {
  Place: 'place',
  PlaceComplex: 'place_complex',
  City: 'geo_city',
  Need: 'need',
  Scenario: 'scenario',
} as const;
То же самое для fact types и roles.
KBConcept.dataТехнически можно положить туда всё:
{
  "recommendedDuration": 180,
  "familyFriendly": true,
  "hasRestaurant": true
}
Но тогда граф перестанет нормально объяснять происхождение данных.
Я бы использовал data концепта только для:
А утверждения вроде:
держал бы как факты.
Потому что только факт имеет:
Для одной карточки запрос может идти слоями.
Концепт:
Факты:
Через пространство текущей поездки:
И всё это можно показать на одной странице, не отправляя пользователя ходить по каталогу.
Обычная туристическая база говорит:
Это пещера в такой-то провинции.
Твоя модель потенциально может сказать:
Это природный комплекс возле Дананга, включающий пещеру, ручей, ресторан и кемпинг. Для активной пары он подходит на полтора дня, но не рекомендуется человеку, избегающему замкнутых пространств. В августе посещение ручья зависит от осадков. Комплекс логично объединить с горой X, но не с объектом Y в тот же день.
Причём каждое утверждение будет иметь:
Это уже не CMS и не обычный каталог. Это действительно база рассуждений.
Тебе не нужно проектировать новую туристическую базу поверх существующей.
Достаточно:
KBConcept.type.data в KBFact.position и data в KBFactParticipation.derived-факты для вычисляемых метрик вроде самодостаточности, маршрутной ёмкости и плотности пользы.Самое важное: не пытаться заранее записать все парные связи между всеми местами. Хранить стоит фундаментальные признаки и значимые редакционные связки, а большая часть совместимости должна вычисляться из графа под конкретного пользователя и конкретный маршрут.