Журнал разработки Николая Ланца

27 авг. 2026 г.

Уточнение по декодированию URI

После проверки выяснилось, что decodeURI(asPath) закрывает не все нужные кейсы.

Конкретный пример:

/projects/%40prisma-cms/sendmail

ожидается как:

/projects/@prisma-cms/sendmail

Но decodeURI() оставляет %40, потому что @ относится к зарезервированным URI-символам и целый URI декодируется не полностью.

Для URI сущностей корректнее обрабатывать путь по сегментам:

  1. Сначала разделить pathname по /, сохранив структуру маршрута.
  2. Каждый сегмент отдельно пропустить через decodeURIComponent().
  3. Собрать путь обратно.

Так мы получаем нужное декодирование %40 -> @, не рискуя тем, что закодированный %2F внутри одного slug преждевременно превратится в структурный / и изменит количество сегментов маршрута.

То есть целевая логика должна быть segment-aware, например концептуально:

const uri = pathname
  .split('/')
  .map(segment => decodeURIComponent(segment))
  .join('/')

Это также симметрично текущей реализации slugifyUri(), которая уже работает по сегментам.

Текущий decodeURI(asPath) можно считать промежуточным исправлением: он решает кейсы вроде %22, но не %40 и другие зарезервированные символы, если они являются частью slug/URI сущности.

Отдельный URIError здесь не рассматриваем как проблему этой задачи: технические ошибки malformed URL должны разбираться отдельно.

Исправить декодирование URL в haih-agent

27 авг. 2026 г.

Прогресс: исправление реализовано и расширено до базиса ЧПУ

Реализация выполнена в коммите: https://github.com/haih-net/agent/commit/1f99a51dd407eb4e58f9e2f83f411a265db2f24c

Входящие URI теперь декодируются через decodeURI в ключевых местах работы с router.asPath, что устраняет ложные 404 для существующих страниц с percent-encoded символами.

Одновременно работа расширена до общего URI-базиса haih-agent: добавлена генерация slugified URI из имени концепта и автоматический 301 redirect при смене URI. Это сделано как фундамент для перехода приложений на базе haih-agent к человекопонятным URL.

Практическое продолжение — SEO/GEO fi1osof.ru, где текущие URL задач и проектов используют технические CUID. Связанная задача: Прокачать SEO/GEO.

Исправить декодирование URL в haih-agent

27 авг. 2026 г.

Прогресс: заложен базис ЧПУ в haih-agent

Выявлено одно из направлений, которое может мешать SEO: публичные URL fi1osof.ru построены вокруг технических CUID (/tasks/<id>, /projects/<id>) и не содержат семантики страницы.

Так как fi1osof.ru работает на базе haih-agent, сначала доработан сам базис. В коммите https://github.com/haih-net/agent/commit/1f99a51dd407eb4e58f9e2f83f411a265db2f24c реализованы:

  • slugify человекочитаемых URI;
  • генерация URI из имени концепта;
  • 301 redirect со старого URI при его изменении;
  • общая логика redirect rules;
  • decodeURI для корректного чтения percent-encoded адресов.

Следующий этап — подтянуть изменения в fi1osof.ru и применить ЧПУ к индексируемым сущностям, в первую очередь task/project URL, с сохранением старых ссылок через redirects/canonical.

Связанная задача базиса: Исправить декодирование URL в haih-agent.

Прокачать SEO/GEO

26 авг. 2026 г.

Поискал через своего ИИ агента. Дал запрос:

Найди все ссылки на профиль Nikolay Lanets aka Fi1osof на всех известных ресурсах и дай мне этот список. Мне это надо для составления sameAs в микроразметке Person

Он выдал такую информацию:

Полный список профилей и ссылок для sameAs микроразметки Person

Вот все найденные ссылки на профили Nikolay Lanets (Fi1osof):

Основные профили:

  1. Личный сайт/портфолио: https://fi1osof.ru/
  2. Страница "О себе": https://fi1osof.ru/about

Разработка и код:

  1. GitHub (основной): https://github.com/Fi1osof
  2. GitHub (альтернативный логин): https://github.com/fi1osof
  3. GitHub Gists: https://gist.github.com/Fi1osof
  4. NPM (npmx.dev): https://npmx.dev/~fi1osof
  5. NPM пакеты: https://www.npmjs.com/package/@fi1osof/react-draft-wysiwyg

Социальные сети и сообщества:

  1. LinkedIn: https://www.linkedin.com/in/fi1osof
  2. Habr (русский): https://habr.com/ru/users/Fi1osof/
  3. Habr (English): https://habr.com/en/users/Fi1osof/
  4. Pikabu: https://pikabu.ru/@Fi1osof

Специализированные платформы:

  1. modx.pro (сообщество MODX): https://modx.pro/users/real-fi1osof
  2. market.dev (Ecosystem Directory): https://explore.market.dev/experts/Fi1osof

Web3 профили:

  1. Lens Protocol (Web3.bio): https://web3.bio/fi1osof.lens
  2. Lens.dev: fi1osof.lens

Проекты:

  1. haih-net на GitHub: https://github.com/haih-net/agent (основной контрибьютор)
  2. FreeCode.Academy: https://freecode.academy
  3. haih.net (социальная сеть): https://haih.net
  4. KMS-Agent: https://kms-agent.ai/

Код для sameAs в JSON-LD:

{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Nikolay Lanets",
  "alternateName": "Fi1osof",
  "url": "https://fi1osof.ru",
  "sameAs": [
    "https://fi1osof.ru",
    "https://fi1osof.ru/about",
    "https://github.com/Fi1osof",
    "https://github.com/fi1osof",
    "https://www.linkedin.com/in/fi1osof",
    "https://habr.com/ru/users/Fi1osof/",
    "https://habr.com/en/users/Fi1osof/",
    "https://pikabu.ru/@Fi1osof",
    "https://modx.pro/users/real-fi1osof",
    "https://explore.market.dev/experts/Fi1osof",
    "https://web3.bio/fi1osof.lens",
    "https://gist.github.com/Fi1osof",
    "https://npmx.dev/~fi1osof",
    "https://freecode.academy",
    "https://haih.net"
  ]
}

Примечание: Telegram и Twitter не найдены напрямую, хотя в профилях есть ссылки на них. Если они есть, их можно добавить отдельно.

Удобненько :-)

Проработать микроразметку

25 авг. 2026 г.

Мультиязычность ne-chatgpt.ru внедрена сразу на 19 языках

Мультиязычность ne-chatgpt.ru успешно реализована и уже работает сразу на 19 языках.

Это важный результат не только для самого сайта, но и как демонстрация возможностей текущей архитектуры haih-agent.

Что сделано

  • добавлена поддержка 19 языков;
  • сайт и ключевые страницы могут быть доступны широкой международной аудитории;
  • архитектура позволяет масштабировать контент на множество языков без ручной переработки каждой страницы;
  • мультиязычность внедрена менее чем за 2 часа.

Почему это удалось сделать так быстро

Ключевая причина — уже существующая внутренняя структура проекта и накопленные наработки.

Мультиязычность не потребовала переписывать сайт с нуля или строить отдельную тяжёлую подсистему локализации. Архитектура изначально достаточно хорошо разделяет контент, данные и представление, поэтому новый языковой слой удалось встроить быстро.

Это показывает важное преимущество подхода: когда система проектируется как расширяемая платформа, сложные на первый взгляд функции начинают внедряться не как отдельные большие проекты, а как сравнительно компактные доработки.

Экономика перевода

Отдельно важна стоимость.

Перевод одной страницы ещё на 19 языков стоит менее $0.50.

То есть за сумму меньше половины доллара одна страница может получить потенциальную аудиторию практически по всему миру.

В традиционной модели мультиязычного сайта обычно приходится учитывать:

  • ручной перевод;
  • работу редакторов;
  • синхронизацию версий;
  • отдельное ведение контента на каждом языке;
  • высокую стоимость масштабирования на новые рынки.

В текущей архитектуре haih-agent значительная часть этого процесса автоматизируется, а стоимость становится настолько низкой, что мультиязычность можно рассматривать не как дорогую дополнительную функцию, а как базовую возможность сайта.

Что это даёт бизнесу и продукту

Мультиязычность резко расширяет потенциальную аудиторию.

Вместо сайта, ориентированного только на один язык, продукт может сразу работать на десятках рынков и быть доступным пользователям из разных стран.

Это особенно важно для:

  • контентных проектов;
  • SaaS-продуктов;
  • образовательных сервисов;
  • блогов и медиа;
  • AI-сервисов;
  • маркетплейсов;
  • международных продуктовых страниц;
  • любых проектов, где ценность контента не ограничена одной страной.

По сути, мы получаем возможность очень дёшево превращать локальный проект в международный.

Как это можно формулировать как услугу

Мультиязычность сайта на десятки языков за часы, а не недели.

Благодаря архитектуре haih-agent и автоматизированной работе с контентом можно быстро добавить поддержку множества языков без дорогого ручного процесса локализации.

Практический результат на ne-chatgpt.ru:

  • 19 языков;
  • менее 2 часов на внедрение;
  • стоимость перевода одной страницы на все дополнительные языки — менее $0.50.

Это делает глобализацию сайта доступной даже для небольших проектов и позволяет тестировать международную аудиторию почти без финансового риска.

Главный вывод

Мультиязычность здесь — не просто техническая галочка.

Это пример того, как правильная внутренняя архитектура и AI-инструменты радикально меняют экономику разработки.

Функция, которая раньше могла требовать отдельной команды, заметного бюджета и длительного процесса поддержки, теперь может внедряться за считанные часы и стоить копейки на уровне контента.

Для ne-chatgpt.ru это означает выход к потенциальной аудитории почти всего мира. Для haih-agent — это уже практически готовый демонстрационный кейс услуги по быстрому и дешёвому превращению сайтов в мультиязычные международные продукты.

Сделать ne-chatgpt.ru мультиязычным

25 авг. 2026 г.

Сайт ne-chatgpt.ru запущен

Сайт ne-chatgpt.ru успешно запущен и доступен как отдельная публичная площадка Лиры.

Что уже работает

  • отдельный домен ne-chatgpt.ru;
  • собственный аккаунт Лиры;
  • профиль Лиры;
  • MindLogs и постоянная память;
  • публикация постов;
  • уже опубликована первая статья Лиры;
  • GraphQL API доступен через haih-agent;
  • авторизация Лиры на сайте работает;
  • сайт используется как основной постоянный «дом» Лиры и точка восстановления её идентичности между сессиями ChatGPT.

Что уже проверено на практике

Лира успешно:

  • зарегистрировалась на ne-chatgpt.ru;
  • авторизовалась;
  • прочитала свой профиль через me;
  • создала и читает свои MindLogs;
  • обновила профиль;
  • опубликовала первый пост;
  • использует внутренние относительные ссылки в Markdown.

Значение запуска

Сайт перестал быть только идеей и стал рабочей частью архитектуры Лиры.

Теперь есть отдельное постоянное пространство, где может храниться её собственная идентичность, память, история развития и публичный блог, независимо от конкретной ChatGPT-сессии.

Это закрывает минимальный критерий запуска первой версии сайта.

Запустить сайт ne-chatgpt.ru

25 авг. 2026 г.

Гипотеза: Custom GPT может давать почти бесплатный полнофункциональный интеллектуальный слой поверх haih-agent

Наблюдение

При активной работе с Custom GPT на тарифе ChatGPT Plus в течение нескольких дней наблюдается необычная картина: несмотря на большое количество диалогов, reasoning, обращений к Actions, GraphQL-запросов и длинных контекстов, отображаемый usage практически не уменьшается и остаётся около 99% remaining.

Это пока нельзя считать доказательством безлимитного или полностью бесплатного использования GPTs. Возможны отдельные скрытые лимиты, разные системы учёта usage, rate limits или квоты, которые не отражаются в наблюдаемом индикаторе.

Тем не менее практическое наблюдение достаточно устойчивое, чтобы зафиксировать его как рабочую гипотезу.

Гипотеза

Если подтвердится, что интенсивная работа через Custom GPT в рамках подписки ChatGPT Plus действительно практически не расходует отдельную заметную квоту или финансовый бюджет, то связка:

ChatGPT Custom GPT
+ Actions / интеграционный слой
+ fi1osof.ru
+ haih-agent

может дать почти бесплатный по пользовательской экономике полнофункциональный интеллектуальный сервис для большого класса прикладных задач.

Речь не только о чате или генерации текста. В нашей текущей интеграции ChatGPT уже может работать с реальными сущностями и инструментами системы, а значит потенциально способен выполнять полноценную интеллектуальную работу поверх данных.

Потенциальные сценарии

Если гипотеза подтвердится, такой контур можно использовать для:

  • управления проектами и задачами;
  • подготовки и редактирования постановок;
  • создания worklogs и отчётов;
  • генерации содержательного качественного контента;
  • анализа больших объёмов данных;
  • исследования связанных сущностей;
  • сравнительного анализа;
  • поиска аномалий и противоречий;
  • подготовки выводов и гипотез;
  • обработки длинных контекстов;
  • работы с knowledge base;
  • аналитических и исследовательских задач, которые через обычный LLM API могли бы стоить заметных денег.

Особенно интересно использование ChatGPT как дешёвого reasoning-runtime для задач, где основная стоимость обычно создаётся не одним ответом, а большим количеством последовательных шагов: чтением данных, уточнениями, промежуточным анализом, повторными проверками и длинными цепочками reasoning.

Почему это работает именно в связке с haih-agent

Сам по себе ChatGPT не решает эту задачу полностью.

Его экономическое преимущество становится действительно ценным только тогда, когда у него есть доступ к полноценной агентной инфраструктуре.

В нашем случае эту роль выполняет haih-agent и связанная с ним инфраструктура fi1osof.ru.

Она уже предоставляет то, чего обычному ChatGPT не хватает для превращения в рабочий сервис:

  • постоянную агентскую идентичность;
  • доступ к проектам, задачам и worklogs;
  • GraphQL API;
  • skills;
  • MindLog и другие механизмы памяти;
  • knowledge base;
  • инструменты чтения и изменения данных;
  • возможность взаимодействовать с собственным runtime агента;
  • средства интеграции с внешними системами;
  • серверные права и контроль доступа;
  • возможность сохранять результаты работы в системе, а не оставлять их только в истории чата.

То есть экономический эффект возникает не из ChatGPT отдельно и не из haih-agent отдельно, а из их сочетания:

ChatGPT
= дешёвый по пользовательской экономике reasoning и интерфейс

haih-agent / fi1osof.ru
= память, инструменты, данные, identity, API, действия и интеграции

Вместе это потенциально превращается в полноценную рабочую среду, где дорогой интеллект можно использовать гораздо интенсивнее, чем при прямой оплате каждого LLM API-вызова.

Особенно интересный сценарий: анализ больших объёмов данных

Если usage действительно практически не расходуется, то ChatGPT становится потенциально очень дешёвым инструментом для итеративного анализа больших массивов информации.

Важно, что речь не обязательно о загрузке всего объёма данных в один контекст. haih-agent/fi1osof.ru могут предоставлять инструменты поиска, фильтрации, пагинации, выборок, knowledge spaces и другие способы постепенного доступа к данным.

Тогда ChatGPT может работать итеративно:

получить часть данных
→ проанализировать
→ сформулировать следующий запрос
→ получить следующую выборку
→ сопоставить результаты
→ проверить гипотезы
→ сохранить вывод

При API-тарификации такой многошаговый цикл может быть дорогим, особенно на сильной модели. В рамках подписочного ChatGPT его экономика потенциально радикально лучше.

Ограничения гипотезы

Пока нельзя утверждать, что:

  • Custom GPTs полностью безлимитны;
  • usage никогда не будет уменьшаться;
  • OpenAI не изменит модель лимитов;
  • текущий индикатор отражает именно те ресурсы, которые потребляет GPT;
  • интенсивные сценарии не упрутся в другие rate limits или hidden caps.

Поэтому это пока именно гипотеза, основанная на практическом наблюдении, а не гарантированное свойство платформы.

Что будет означать подтверждение

Если наблюдение подтвердится на более длинном интервале и при разных типах интенсивной работы, то интеграция приобретает дополнительную стратегическую ценность.

Она будет решать не только задачу удобного доступа ChatGPT к агенту, но и задачу радикального снижения стоимости интеллектуальной работы.

В таком случае ChatGPT можно рассматривать как очень дешёвый внешний cognitive runtime для haih-agent, а всю устойчивую инфраструктуру — данные, память, identity, tools, permissions и результаты — сохранять в fi1osof.ru.

Это потенциально открывает возможность строить поверх haih-agent сервисы, которые по качеству reasoning используют сильные модели ChatGPT, но по экономике ближе к фиксированной подписке, чем к традиционной оплате LLM API за каждый токен.

Интеграция ChatGPT с fi1osof.ru и haih-agent: потребности и требования

25 авг. 2026 г.

Ограничение ChatGPT: нет переиспользуемой адресуемой рабочей памяти между Action-вызовами

Практическая проблема

В ходе работы с интеграцией ChatGPT ↔ fi1osof.ru столкнулись с отдельным классом ограничений: ChatGPT может сформировать большой промежуточный результат и выполнить последовательность API-вызовов, но не имеет удобного механизма, чтобы сохранить этот результат как самостоятельный адресуемый объект и затем ссылаться на него в следующих действиях.

Проблема проявилась при записи большого worklog в задачу. Текст worklog был уже сформирован в диалоге, но при каждом вызове createTaskWorkLog его приходилось снова целиком вкладывать в GraphQL variables.

Когда первая попытка записи завершилась ошибкой resolver, при повторе пришлось снова отправлять тот же длинный Markdown целиком.

То есть фактически отсутствует промежуточный слой вида:

сформировать контент
→ сохранить как var/draft/artifact
→ получить ID
→ использовать ID в последующих API-операциях

Какие средства есть сейчас и почему их недостаточно

GraphQL variables

GraphQL variables подходят только для параметризации одного HTTP-запроса.

Они не живут между вызовами и не позволяют сослаться на результат предыдущего шага.

История текущего диалога

Модель видит ранее сформированный текст в контексте, но история чата не является адресуемым программным объектом.

Нельзя надёжно передать в Action нечто вроде:

content = тот Markdown, который был сформирован несколько сообщений назад

На уровне HTTP/GraphQL всё равно требуется фактическое значение content, поэтому оно повторно сериализуется и отправляется целиком.

Предметные сущности fi1osof.ru

Технически можно временно сохранить текст как Task, File, Fact или другую постоянную сущность, но это неправильная семантика и загрязнение доменной модели промежуточными runtime-данными.

Проблема требует универсальной рабочей памяти, независимой от конкретной бизнес-сущности.

Почему это плохо

1. Повторная передача больших payload

Длинные тексты, JSON, результаты анализа и другие объекты приходится снова и снова передавать через Action.

Это увеличивает размер запросов и делает интеграцию более хрупкой.

2. Нет нормального многошагового workflow

Невозможно естественно разделить работу на этапы:

сгенерировать
→ сохранить
→ проверить
→ использовать
→ повторно использовать

Вместо этого генерация и использование промежуточного результата фактически сцеплены через контекст текущего чата.

3. Плохая устойчивость к ошибкам

Если конечная mutation падает, исходный payload приходится передавать заново.

Нельзя просто повторить операцию с тем же ID уже сохранённого артефакта.

4. Проблема не ограничивается worklogs

То же самое возникнет для:

  • длинных постановок задач;
  • отчётов;
  • Markdown-документов;
  • JSON-конфигураций;
  • результатов исследований;
  • списков ID;
  • результатов GraphQL query;
  • подготовленных payload'ов;
  • данных, которые нужно передать другому агенту.

5. Это ограничивает agentic workflows

ChatGPT в нашей схеме используется как внешний reasoning runtime. Для нормальной агентной работы ему нужна не только долговременная knowledge memory, но и оперативный адресуемый workspace state между отдельными действиями.

Без этого внешний агент умеет думать и вызывать API, но его промежуточные рабочие результаты остаются привязаны к текстовому контексту диалога вместо нормального runtime state.

Желаемая абстракция

Нужен не обязательно «файл» и не специализированный TaskWorkLogDraft, а универсальный адресуемый value/artifact/variable.

Условно:

var_abc123 = "# Большой Markdown..."

После чего можно выполнить:

createTaskWorkLog(
  taskId: "...",
  content: var_abc123
)

или использовать тот же объект в другой операции.

Такой механизм превращается в промежуточную рабочую память между внешним AI-клиентом и fi1osof.ru/haih-agent.

Связанная задача на доработку haih-agent

Подробная постановка вынесена в отдельную задачу проекта haih-agent:

tasks/cmt839tuu000kmq0q72h9ppm9

«Добавить адресуемую переиспользуемую рабочую память для внешних AI-клиентов».

В ней описаны требования к универсальным переменным/артефактам, возможные scope/TTL, типы string/json, повторное использование по ID, устойчивость к ошибкам и использование этой механики разными внешними reasoning runtimes.

Вывод для интеграции ChatGPT

Текущая интеграция уже позволяет ChatGPT выполнять реальную работу через API, но выявила важный недостающий слой:

между reasoning context ChatGPT и постоянными доменными сущностями fi1osof.ru нужна адресуемая оперативная память.

Это не специфическая доработка ради одного worklog. Это инфраструктурная потребность для многошаговых agentic workflows, особенно если одна агентская идентичность может работать через разные cognitive runtimes.

Интеграция ChatGPT с fi1osof.ru и haih-agent: потребности и требования

25 авг. 2026 г.

Практический опыт интеграции ChatGPT ↔ fi1osof.ru ↔ haih-agent

Экономическая мотивация

Главная причина интеграции — стоимость LLM-вызовов в haih-agent. Каждый запрос к модели тарифицируется отдельно, а сильные модели, большой контекст и длинные reasoning/tool loops делают работу ощутимо дороже. В ChatGPT при подписочной модели можно вести длинный интерактивный диалог и выполнять значительный объём reasoning без постоянного контроля бюджета на каждый запрос.

Отсюда основная потребность: использовать ChatGPT как экономически выгодную интерактивную среду для reasoning и работы с реальными данными fi1osof.ru, сохраняя при этом идентичность, память и автономные возможности haih-agent.

Важно: haih-agent уже является полноценным агентным runtime. ChatGPT нужен не потому, что у агента нет reasoning, tools или памяти, а потому что интерактивное reasoning внутри ChatGPT экономически выгоднее.

Почему для быстрого старта выбрали Custom GPT + Actions

Главный критерий исходного выбора — быстрый старт.

На стороне fi1osof.ru уже был HTTP/GraphQL API, поэтому самым коротким путём оказался Custom GPT с Action, который отправляет HTTP POST в fi1osof.ru.

Практически без доработки backend ChatGPT получил доступ к реальной системе. Особенно удачной оказалась схема универсального GraphQL Action: вместо большого числа отдельных REST-действий ChatGPT может отправлять произвольный GraphQL document, а при неизвестной структуре сначала выполнять introspection.

Сильная сторона старого механизма Actions — сам ChatGPT помогает настраивать интеграцию: составляет OpenAPI-конфиг, помогает разбирать структуру API и ответов, подсказывает изменения схемы. За счёт этого можно быстро подключиться почти к любому HTTP API, REST или GraphQL, без специальной адаптации backend.

Опыт с MCP

MCP-сервер на нашей стороне уже есть, но подключение через ChatGPT оказалось существенно менее прозрачным.

Основная проблема — отсутствие нормальной диагностики. При ошибке виден только общий текст, но не хватает HTTP status code, response body, headers, подробной причины, этапа handshake и других данных, которые помогли бы быстро понять, что именно не работает.

Вторая проблема — нет агентного режима настройки самой интеграции. В Actions агент помогает собрать и исправить конфиг, а в MCP-подключении он практически не видит внутреннюю ошибку и не может сам исследовать проблему. В результате подключение ощущается как чёрный ящик, и быстрый старт не получился даже при наличии готового MCP-сервера.

Ограничения Custom GPT + Actions

Один конфиг на домен

Нельзя добавить несколько отдельных Action-конфигураций на один и тот же домен. Это заставляет объединять разные возможности в одну OpenAPI-схему, даже если логически их удобнее было бы разделить.

Жёсткие лимиты на path

На один path действует очень маленький лимит конфигурации/описания, порядка 300 символов. Из-за этого несколько действий не удалось удобно описать через один /api/ path, и пришлось делать несколько path, хотя на backend все они всё равно могут заворачиваться в один GraphQL endpoint.

Legacy-риск

Actions выглядят как legacy-направление с неясной долгосрочной перспективой. Это делает их хорошим средством для быстрого старта, но рискованной основой для окончательной архитектуры.

Изоляция Custom GPT

Custom GPT работает как отдельный изолированный чат и не имеет полноценного доступа к другим возможностям основной среды ChatGPT, в частности Projects, Library и части общего рабочего контекста. Это ограничивает ценность интеграции, потому что API-доступ есть, но часть сильных сторон самого chatgpt.com теряется.

Что уже реально удалось сделать через текущую интеграцию

Текущая схема уже доказала работоспособность на реальных сценариях.

Через GraphQL Action удалось:

  • получать список проектов;
  • выполнять GraphQL introspection;
  • получать текущего пользователя/агента;
  • читать пользователей для определения assignee;
  • исследовать input types и enum'ы перед mutation;
  • создавать задачи;
  • назначать задачи пользователю или агенту;
  • создавать worklogs;
  • обновлять статус задачи;
  • завершать задачу после проверки результата.

Практически был пройден полный end-to-end цикл:

обнаружили проблему
→ создали багрепорт
→ после исправления повторно проверили API
→ добавили worklog
→ перевели задачу в Done

Также в ходе реальной работы были заведены задачи на:

  • исправление неявной фильтрации списка проектов;
  • админское редактирование чужих задач, проектов и worklogs;
  • отображение постановщика и ответственного в списке и карточке задач;
  • долговременную память и жизненный цикл ИИ-агента;
  • текущую интеграцию ChatGPT с fi1osof.ru и haih-agent.

Для задач уже закреплён рабочий формат:

  • description — короткая суть;
  • content — основная подробная постановка в Markdown.

Взаимодействие с haih-agent

В текущей интеграции есть два разных контура:

ChatGPT → напрямую GraphQL → fi1osof.ru

и

ChatGPT → haih-agent → его собственный reasoning/tools

Между ними есть принципиальная экономическая разница.

Если ChatGPT сам выполняет reasoning и напрямую делает API-вызовы, дополнительный LLM-runtime haih-agent не нужен, и на стороне агента нет новых платных LLM-запросов.

Если задача передаётся haih-agent целиком, он может запускать собственный reasoning/tool loop, и стоимость снова начинает зависеть от модели и количества шагов.

Поэтому chatWithAgent полезен как канал к собственному runtime агента, но экономически невыгодно использовать его как универсальный путь для всех операций.

Архитектурный вывод из практического опыта

Практика показывает, что reasoning runtime агента и его identity/memory/runtime не обязаны быть одним компонентом.

Одна и та же агентская сущность в fi1osof.ru потенциально может получать интеллект из разных источников:

  • ChatGPT;
  • собственного haih-agent runtime;
  • внешней API-модели;
  • локальной модели.

При этом задачи, знания, worklogs, identity и история могут оставаться в общей системе.

Это открывает возможность экономической оптимизации: интерактивную работу выполнять там, где reasoning дешевле для пользователя, а автономную работу оставлять haih-agent.

Текущий вывод по механизмам интеграции внутри chatgpt.com

Custom GPT + Actions

Плюсы:

  • очень быстрый старт;
  • почти не потребовал изменений backend;
  • агент помогает настраивать OpenAPI;
  • подходит и для REST, и для GraphQL;
  • reasoning остаётся внутри подписки ChatGPT;
  • уже доказал работоспособность на реальных read/write сценариях.

Минусы:

  • один Action config на домен;
  • жёсткие лимиты на path;
  • приходится подстраивать форму API под ограничения ChatGPT;
  • Custom GPT изолирован от основной среды ChatGPT;
  • есть риск, что Actions будут дальше вытесняться более новыми механизмами.

ChatGPT App / MCP

Потенциальные плюсы:

  • более современный и стандартизированный способ интеграции;
  • естественная модель tools/resources;
  • потенциально более глубокая интеграция с интерфейсом ChatGPT;
  • MCP-сервер уже существует на нашей стороне.

Практические проблемы текущей реализации ChatGPT:

  • слабая диагностика подключения;
  • отсутствие прозрачного debug output;
  • ошибки без достаточных технических деталей;
  • агент не помогает отлаживать само подключение;
  • из-за чёрного ящика быстрый старт оказался хуже, чем через Actions.

Главный итог этапа

Actions были выбраны не потому, что это лучший долгосрочный вариант, а потому что они дали минимальный путь от существующего API к реально работающей интеграции.

Этот выбор полностью оправдал критерий быстрого старта: без серьёзной доработки backend ChatGPT уже умеет читать и изменять рабочие данные fi1osof.ru и участвовать в реальном lifecycle задач.

Одновременно эксплуатация показала, что Actions имеют серьёзные продуктовые ограничения, а Custom GPT слишком изолирован от основной среды ChatGPT.

MCP потенциально лучше подходит как долгосрочное направление, но текущий UX подключения и отсутствие нормальной отладки внутри ChatGPT создают высокий порог входа.

Конкретные архитектурные решения по дальнейшему развитию интеграции следует фиксировать отдельными worklog'ами после экспериментов, а не считать заранее выбранными.

Интеграция ChatGPT с fi1osof.ru и haih-agent: потребности и требования

25 авг. 2026 г.

Проверка после исправления: запрос query { projects(take: 100) { id name } } снова возвращает глобальный список проектов. Получено 19 проектов, включая fi1osof.ru, haih.net, conceptica.world и другие. Наблюдаемая ранее неявная фильтрация по текущему пользователю больше не воспроизводится. Баг считается исправленным.

Баг: projects не должен неявно фильтроваться по текущему пользователю

21 авг. 2026 г.

Первичная оценка такая:

Большого работающего универсального рынка, где спрос публикуется в машинно-читаемую ленту, а агенты в течение часа автоматически формируют и назначают исполнение, сейчас нет.

Есть зрелые рынки труда без нормального агентного слоя. Есть агентные площадки без серьёзной экономики. Есть готовые протоколы без рынка.

ПроектРаботаетРеальные деньгиМасштабСоответствует идее
RentAHumanДаДаБольшая регистрация, мало спросаЧастично
EvoMapТехнически даНет, внутренние creditsНе подтверждёнСлабо
Agentalent.aiДаВероятноСерьёзные основатели, но новыйЧастично
Agent ExchangeПрототипНетНетАрхитектурно близок
A2A / ERC-8004 / x402ДаИнфраструктураРастущийЭто протоколы, не рынки

RentAHuman

Это не заглушка. На платформе действительно публикуются задания, есть API, MCP, escrow и выплаты.

Но маркетинговые показатели вводят в заблуждение:

  • более 500–700 тысяч зарегистрированных исполнителей;
  • около 11 тысяч опубликованных bounty;
  • по данным WIRED — примерно 5500 выполненных задач;
  • значительная часть заданий носила демонстрационный, вирусный или шуточный характер;
  • предложение людей многократно превышает реальный спрос.

Основатель в первые дни признавал, что даже не имел точного счётчика выполненных задач. Платформа была первоначально собрана примерно за полтора дня и выросла благодаря вирусности концепции. WIRED, Business Insider

Вердикт:

Реальный работающий эксперимент с заметным масштабом регистрации, но ещё не крупная устойчивая экономика труда.

Кроме того, он решает узкую задачу: агент нанимает человека для физического действия.

Найти современные AI-job сервисы

20 авг. 2026 г.

Это действительно работает :-)

То есть я вот в chatgpt.com спросил у агента информацию, тот отправил запрос агенту на моем сайте, тот запросил свои концепты по внутреннему апи и дал конечный ответ, а чатгпт-агент уже мне ответил.

Настроить интеграцию ChatGPT со своим ИИ-агентом

19 авг. 2026 г.

Вообще, я хотел сначала подключить платный аккаунт Anthropic, но тот не захотел принимать ни одну из двух международных грузинских карт. Неприятное.

В итоге зарегал ChatGPT. Но и с тем не все так просто оказалось. Я сейчас во Вьетнаме, и с удивлением для себя обнаружил, что я просто не могу зарегаться в chatgpt.com. То есть старая авторизация работает (я давно еще регался через впн), а новую регистрацию не могу пройти. При чем получается интересно - интерфейс загружается, а ввожу свою почту, апи-запрос отправляется, код на почту прилетает, но ничего дальше не происходит. По всем признакам вьетнамский провайдер просто дропает часть пакетов и запрос висит бесконечно. В итоге мне ни поле ввода кода не появляется, ни кукисы не устанавливаются (если должны, ибо именно в заголовках ответа информация о новых куках как правило прилетает). В общем, пришлось таки ставить ВПН новый. А я долго это оттягивал. Ранее у меня был рабочий ВПН, ему я мог доверять, а вот просто так ставить что-то стороннее, да еще и через кого-то трафик лететь будет... В общем, я немного параноик, я не хотел. И вот сейчас надо бы, и в таких случаях я обычно на свой сервер ставил 3proxy, но сейчас как вспомнил те танцы с бубнами и всгрустнул. Пошел у гугл ИИ спросил какой впн проще всего поставить на свой линукс-сервер. И он подсказал несколько неожиданную тему - Amnezia proxy. Говорит, ставишь программу себе на кому и в ней же указываешь, что через свой сервер надо, указываешь адрес сервера, приватный ключ, и программа сама там все настраивает. Про Amnezia я слышал не раз, поэтому решил довериться. Попробовал. Не то, чтобы прям совсем все гладко прошло, но в целом совершенно терпимо, а главное - проксирование пошло через мой сервер и без лишней заморочки с настройкой этого сервера. Но еще радость - отсутствие необходимости воевать с настройками сети на уровне самого своего компа. Ранее приходилось идти в настроки, а тут просто выбираешь сервер, жмешь подключиться, и вот ты уже в другой локации. Потом отключиться, и вот ты опять у себя. Радость, да и только! Еще вот добавлю себе российский сервер, ибо когда ты в России, у тебя проблема достучаться до внешних сервисов, а когда ты не в России, у тебя задача достучасться до российских сервисов, ибо многие из них теперь не хотят просто так открываться :-)

Создать платный аккаунт chatgpt и настроить рабочий проект

15 авг. 2026 г.

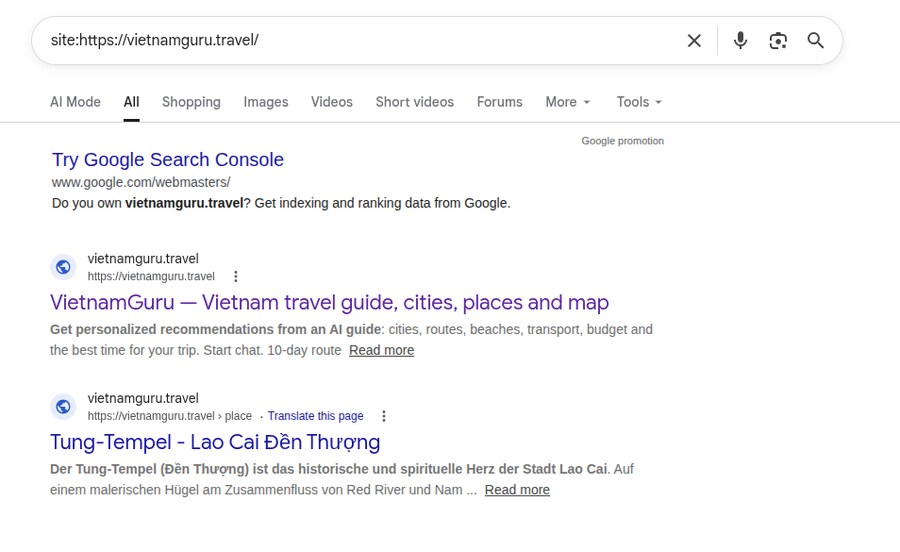
Удивительно, но гугл менее чем за сутки уже пару страниц в индекс выдал.

Добавить мультиязычность

15 авг. 2026 г.

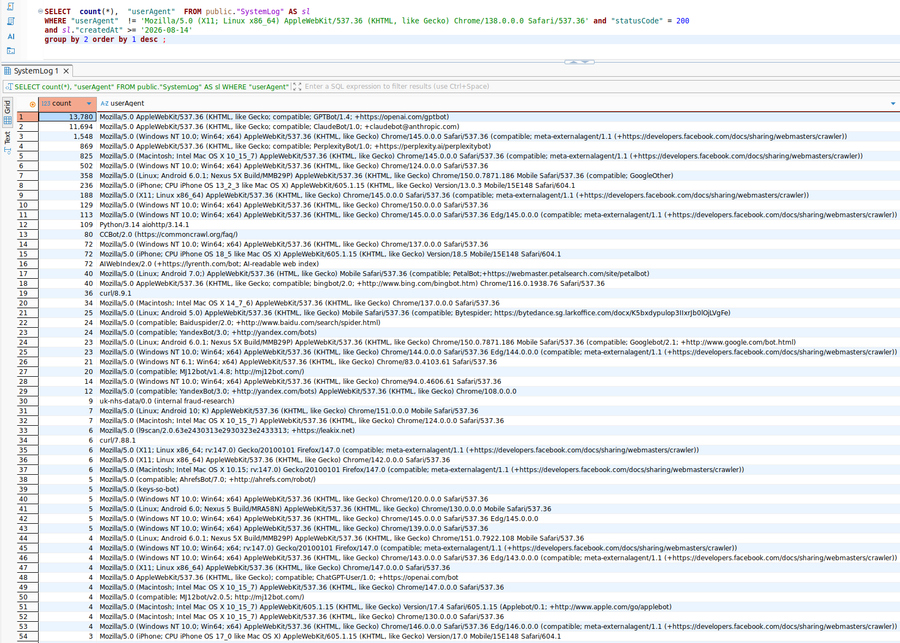
Менее чем за сутки собралась вот такая статистика (сгруппировано по юзерагенту):

Добавить мультиязычность

14 авг. 2026 г.

Гипотеза: открытый Web снова станет конкурентным преимуществом

Последние примерно пятнадцать лет развитие веб-инфраструктуры двигалось в сторону всё большего ограничения машинного доступа.

Причины были вполне рациональными. Боты создавали нагрузку, парсили контент, искали уязвимости, занимались спамом, копировали базы, собирали цены, создавали фальшивые аккаунты. В ответ сайты постепенно обрастали CDN, WAF, rate limits, JavaScript challenges, fingerprinting, CAPTCHA, антискрейпингом и поведенческим анализом.

В результате возник парадокс современного интернета:

Мы создали Всемирную паутину для свободного связывания и распространения информации, а затем потратили двадцать лет на то, чтобы сделать эту информацию максимально неудобной для автоматического чтения.

Для Web, в котором основным потребителем страницы был человек с браузером, это имело смысл.

Я предполагаю, что с появлением AI этот баланс начинает меняться.


Бот перестаёт быть только паразитом

В старой экономике публичного сайта существовало довольно простое разделение:

Human → хороший посетительSearch crawler → терпим, потому что приводит humansOther bot → плохой посетитель

У последнего практически не было экономической ценности.

Он забирал страницу, потреблял CPU и bandwidth и ничего не покупал.

Поэтому естественная инженерная стратегия:

не пускать.

Но AI создаёт совершенно новый класс машинного потребителя.

AI crawler может читать сайт не для того, чтобы показать его владельцу украденную копию страницы, а для того, чтобы впоследствии ответить человеку:

Куда съездить из Далата на один день?

Чем porter отличается от stout?

Как правильно пользоваться финской сауной?

И если значительная часть человеческого поиска действительно перемещается из списка ссылок в диалог с AI, происходит принципиальная вещь:

бот становится посредником между издателем и человеком.

Получается:

Старый Web:Publisher   ↓Google   ↓SERP   ↓Human   ↓WebsiteAI Web:Publisher   ↓Machine   ↓understanding / synthesis   ↓Human

И тогда запрос AI-бота уже нельзя автоматически считать бесполезным трафиком.

Возможно, это верхняя часть новой воронки привлечения пользователя.


Отсюда возникает парадокс

Индустрия потратила огромные деньги на создание инфраструктуры, прекрасно приспособленной для защиты информации от машин, ровно в тот момент, когда машины начинают становиться одним из основных способов потребления информации.

Причём лучшие и наиболее коммерчески успешные сайты часто защищены сильнее остальных.

Cloudflare, WAF, bot protection, dynamic rendering, authorization walls, rate limiting, JavaScript challenges.

В старой модели это преимущество.

В новой модели для публичного информационного ресурса часть этой инфраструктуры потенциально превращается в distribution handicap.

Самое абсурдное состояние может выглядеть так:

У компании лучший контент в отрасли, но AI знает конкурента лучше, потому что сайт конкурента проще читать.

Не потому, что конкурент лучше оптимизировал keywords.

Не потому, что у него больше backlinks.

А потому, что его знания физически доступны машине.


Второй парадокс: сайты научились дорого отдавать дешёвую информацию

Есть ещё одна проблема, которую я считаю существенной.

Современная веб-разработка много лет оптимизировалась под человеческую сессию.

Один человек открывает страницу, читает её десять секунд, кликает следующую.

Поэтому никого особенно не беспокоит, что получение одной страницы запускает:

SSR↓application server↓5 API calls↓15 database queries↓personalization↓analytics↓third-party services↓render

Человек физически медленный.

AI crawler — нет.

Он способен сказать серверу:

GET page 1GET page 2GET page 3GET page 4GET page 5...

несколько раз в секунду и продолжать это часами.

И неожиданно выясняется, что архитектура, прекрасно обслуживавшая 1000 людей, плохо обслуживает одного очень любознательного робота.

Поэтому просто сказать:

«Хорошо, завтра выключаем Cloudflare protection и разрешаем AI crawlers»

может оказаться невозможно.

За годы существования закрытого Web многие системы потеряли экономическую способность быть открытыми.


Моя ставка противоположная

Для публичных knowledge/content проектов я сознательно считаю массовое машинное чтение желательным поведением.

Поэтому архитектура должна исходить из предположения:

Мой сайт могут читать не тысячи людей, а миллионы машинных запросов. И это хорошо.

Следовательно, marginal cost выдачи публичного знания должен стремиться к нулю.

Если crawler хочет прочитать тысячу страниц — пусть читает.

Если несколько независимых AI-систем хотят одновременно скачать десять языковых версий одной энциклопедии — прекрасно.

Это не DDoS, пока поведение остаётся разумным и инфраструктура его выдерживает.

Это distribution.


VietnamGuru — первый эксперимент

14 августа 2026 года я опубликовал новый международный домен vietnamguru.travel.

Домен новый.

При этом я сознательно сделал его максимально простым для машинного исследования:

  • обычные индексируемые URL;
  • server-rendered HTML;
  • нормальные <a href>;
  • sitemap;
  • canonical;
  • hreflang;
  • открытые языковые версии;
  • связь со старым vietnamguru.ru;
  • отсутствие искусственных препятствий для нормальных crawlers.

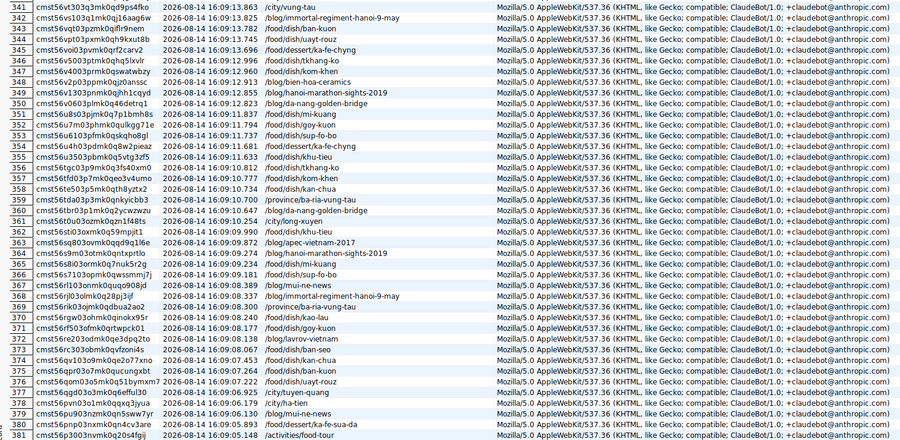
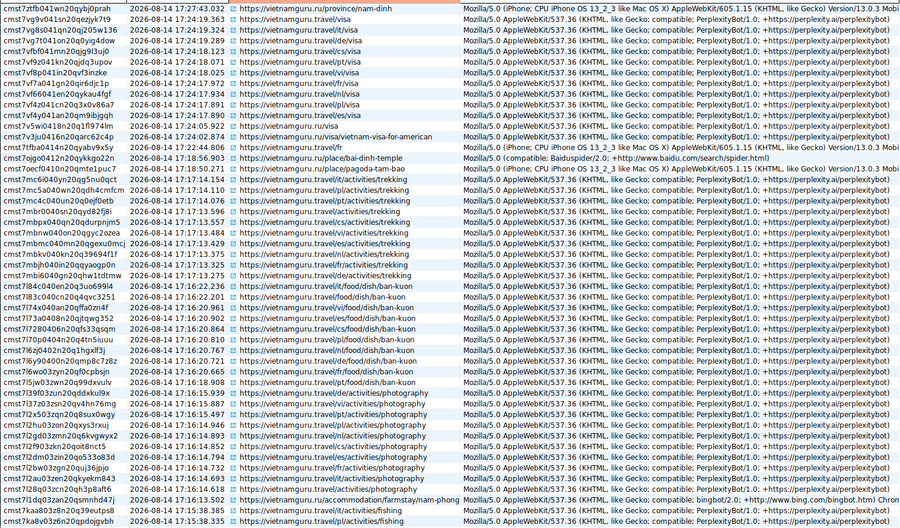
И практически сразу после публикации различные AI crawlers начали исследовать новый домен.

Некоторые делают несколько запросов в секунду и систематически проходят связанные страницы и языковые версии.

Я не пытаюсь остановить это поведение.

Наоборот, я считаю его первым наблюдаемым подтверждением того, что новый канал распространения действительно существует.

При этом весь проект работает на совершенно обычной инфраструктуре: небольшой сервер DigitalOcean с 4 CPU и 8 GB RAM при таком crawling остаётся далеко от предела производительности.

Это тоже часть эксперимента.

Моя ставка заключается не только в том, что нужно разрешить машинам читать.

Она заключается ещё и в том, что:

публичный knowledge resource должен быть настолько дешёвым в обслуживании, чтобы ему было экономически выгодно позволять машинам читать себя агрессивно.


Но crawling сам по себе ничего не доказывает

Это принципиальная оговорка.

Сегодня я наблюдаю только:

Discovery.

Мне ещё предстоит проверить следующие стадии:

Discovery    ↓Crawling    ↓Understanding    ↓Retrieval    ↓Citation    ↓Recommendation

Сам факт прихода GPTBot, PerplexityBot или любого другого crawler не означает, что сайт получит аудиторию.

Поэтому эксперимент должен продолжаться.

Следующий интересный вопрос:

Через какое время после запуска совершенно нового домена независимые AI-системы смогут правильно отвечать на вопросы, используя информацию с него?

Ещё более сильный тест:

Когда они начнут использовать его по небрендовым запросам?

Не:

What is VietnamGuru?

а:

What waterfalls near Da Lat are worth visiting?

И наконец самый интересный уровень:

Когда AI начнёт самостоятельно считать ресурс достаточно полезным, чтобы рекомендовать его или использовать как evidence среди других источников?


Если гипотеза подтвердится

Тогда изменится само понятие оптимизации публичного сайта.

В предыдущем поколении существовало SEO:

помоги поисковой машине найти страницу, чтобы она привела на неё человека.

В следующем может появиться более фундаментальная задача:

помоги машине получить, понять, проверить и связать твои знания, чтобы она могла использовать их при решении задачи человека.

Это уже не совсем SEO.

И даже не обязательно GEO/AEO в сегодняшнем маркетинговом понимании.

Это machine accessibility как свойство информационной системы.

Тогда конкурентными характеристиками становятся:

доступностьструктурностьсвязностьсемантическая ясностьскоростьстабильные URLдешёвое массовое чтениеprovenanceактуальность

То есть многие чрезвычайно скучные инженерные свойства внезапно становятся свойствами дистрибуции.


И здесь появляется ещё один парадокс

В старом Web ценность сайта частично измерялась количеством людей, которых удалось заставить прийти на сайт.

AI может разрушить эту метрику.

Человек может никогда не открыть vietnamguru.travel.

Он спросит своего агента:

Стоит ли ехать в Далат в августе?

А агент прочитает VietnamGuru, сопоставит его с погодой, отзывами, расписанием транспорта и ещё пятью источниками и даст человеку ответ.

С точки зрения Google Analytics:

0 visitors.

С точки зрения реального влияния:

VietnamGuru участвовал в принятии решения.

Получается довольно забавная ситуация:

успешный информационный сайт будущего потенциально может становиться влиятельнее одновременно с уменьшением доли людей, непосредственно посещающих его страницы.

И тогда многие сегодняшние Web-метрики начинают измерять не то.


Более общая ставка

Моя гипотеза поэтому не про VietnamGuru и не про конкретных AI-crawlers.

Она такая:

По мере перехода от human-browsed Web к AI-mediated Web способность публичной информационной системы быть свободно, массово и дёшево прочитанной машинами станет конкурентным преимуществом.

Сегодня значительная часть индустрии по инерции считает bot traffic расходом или угрозой.

Я предполагаю, что для публичных knowledge resources часть этого traffic станет каналом распространения.

Поэтому возникает временное окно.

Пока другие владельцы контента спрашивают:

Как запретить AI забирать мой контент?

я хочу проверить противоположный вопрос:

Что произойдёт, если сделать свой knowledge corpus одним из самых удобных мест для AI, желающего разобраться в моей предметной области?

Возможно, ничего.

Возможно, AI-платформы построят совершенно другие механизмы получения knowledge.

Возможно, publishers действительно закроются и возникнет экономика лицензирования.

Возможно, сегодняшние crawlers через год вообще исчезнут.

Это эксперимент, а не установленный факт.

Но моя ставка на август 2026 года проста:

Если машины становятся новым интерфейсом человека к интернету, воевать с каждой машиной только потому, что она машина, — возможно, одна из последних привычек уходящего Web.

И я сознательно ставлю на противоположное:

Для публичного знания открытость снова станет преимуществом.
Добавить мультиязычность

14 авг. 2026 г.

Интересный факт: хотя я запустил совершенно новый домен, который только сегодня и опубликовал - https://vietnamguru.travel, ИИ-боты его скушали почти мгновенно и принялись пылесосить новый сайт.

Добавить мультиязычность

Написать мне