Задача: Добавить мультиязычность
Ворклоги
Полдела сделано - добавил локали и роутинг
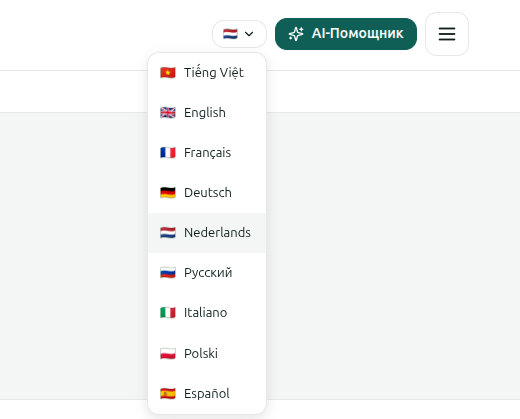
В моем случае реализаций нестандартная, потому что русский язык будет на текущем домене - https://vietnamguru.ru, а другие языке на новом международном домене - https://vietnamguru.travel
Сейчас надо добавить еще в базу хранение переводов, конечную логику и перевести все документы. Благо у меня по структуре почти все находится в самом контенте страницы и будет относительно не сложно все это сделать.
Добавил резолвер, который переводит карточку сразу на два языка - en, vi (за один запрос).
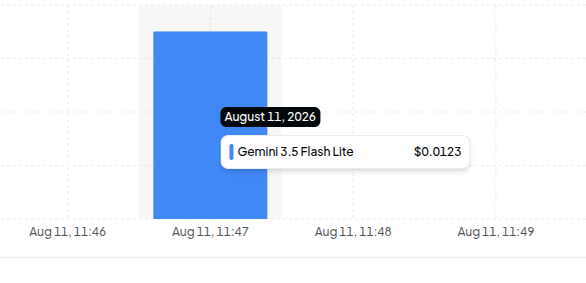
Переводит. Получилось примерно 10 рублей за перевод.
На вход принимает 4 поля: name, description, intro, content, при чем intro и content содержат в себе маркдаун в перемешку с HTML. content вообще само по себе довольно сложное поле, потому что содержит в том числе элементы шаблонизации.
Ответ LLM отдает в формате yaml, так как в таком случае меньше риск получить ошибку форматирования из-за какой-нибудь незакрытой кавычки. В итоге получается примерно такой ответ:
responseContent en:
  name: |
    Dalat
  description: |
    A mountain city at an altitude of 1,500 m in Vietnam's Central Highlands, known for its French colonial architecture, cool climate, and natural attractions. A popular tourist destination for travelers seeking a break from the coastal heat.
  intro: |
    Dalat is a city on the Langbiang Plateau at an altitude of 1,500 m in Lâm Đồng Province. It is known for its unique "eternal spring" microclimate with temperatures of 18–21 °C, French colonial-era architecture, and surrounding nature with waterfalls, lakes, and pine forests. Until July 2025, it served as the capital of Lâm Đồng Province.
  content: |
    <page-hero data-from="#1e3a5f" data-to="#0f172a" data-accent="#3b82f6">
      <page-hero-crumbs>
        [Home](/) / [Locations](/city) / Dalat
      </page-hero-crumbs>

vi:
  name: |
    Đà Lạt
  description: |
    Thành phố miền núi ở độ cao 1.500 m tại cao nguyên trung bộ Việt Nam, nổi tiếng với kiến trúc thuộc địa Pháp, khí hậu mát mẻ và các danh thắng thiên nhiên. Điểm đến du lịch phổ biến cho những du khách tìm kiếm sự nghỉ ngơi khỏi cái nóng ven biển.
  intro: |
    Đà Lạt là thành phố trên cao nguyên Langbiang ở độ cao 1.500 m thuộc tỉnh Lâm Đồng. Nổi tiếng với vi khí hậu "mùa xuân vĩnh cửu" độc đáo với nhiệt độ 18–21 °C, kiến trúc thời kỳ thuộc địa Pháp và thiên nhiên xung quanh với các thác nước, hồ nước và rừng thông. Cho đến tháng 7 năm 2025, nơi đây là tỉnh lỵ của tỉnh Lâm Đồng.
  content: |
    <page-hero data-from="#1e3a5f" data-to="#0f172a" data-accent="#3b82f6">
      <page-hero-crumbs>
        [Trang chủ](/) / [Địa điểm](/city) / Đà Lạt
      </page-hero-crumbs>
Запустил перевод всех страниц. В сам апдейт добавлен хелпер, который вычищает несуществующие ссылки (иногда ИИ придумывает) и делает он это через mdx-парсер. Эта механика попутно проверяет на корректность HTML-тегов в коде. Самая распространенная ошибка - неверный закрывающий тег (открывает один тег, а закрывает другой тег). Нарушение разметки приводит к ошибке и такие данные не записываются. Количество ошибок составило примерно 4% карточек.
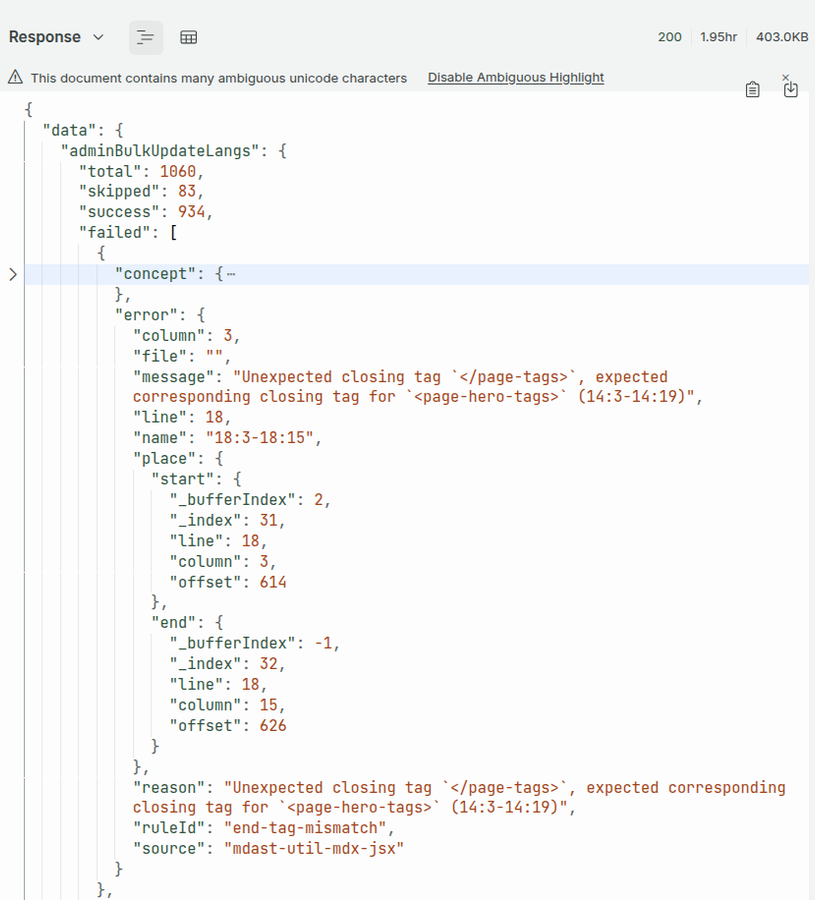
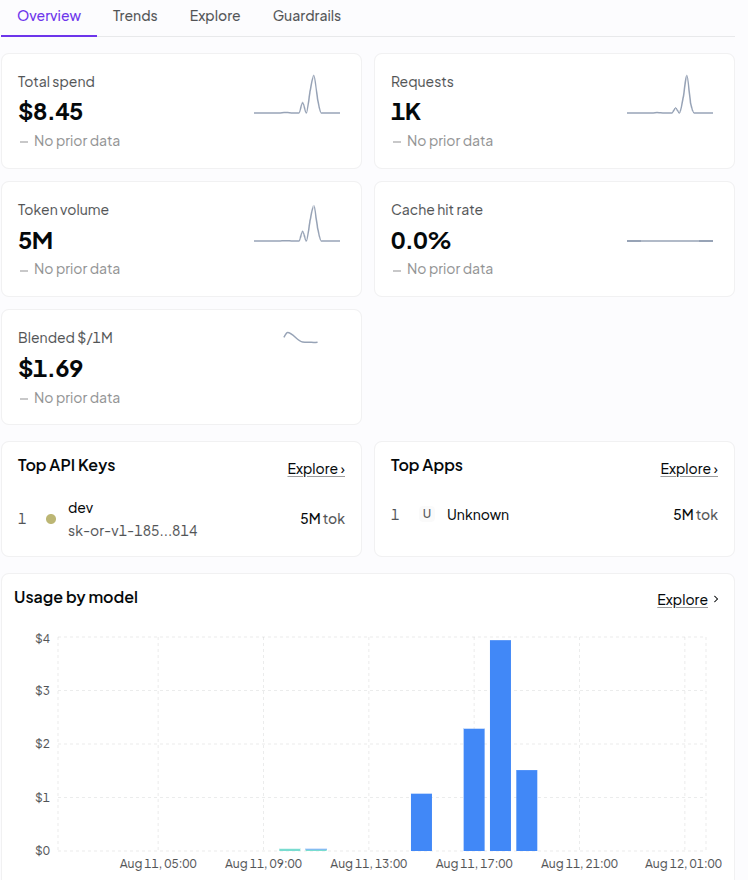
Но это ничего. Обрабатывались 1000 карточек 2 часа, а стоило все менее 9 долларов. Получается, примерно 1 рубль за карточку. Запущу прогон еще раз. Заполненные карточки пропускаются.
Next.js i18n domain routing в локальной разработке: почему пришлось запускать dev-сервер на 80-м порту
При настройке локального окружения для Next.js я столкнулся с довольно неприятным ограничением встроенного domain-based i18n routing.
Задача на первый взгляд простая: приложение использует разные домены для разных локалей, и локально хочется воспроизвести ту же схему. Например:
const nextConfig: NextConfig = {
  i18n: {
    locales: LOCALE_CODES,
    defaultLocale: 'en',
    localeDetection: false,
    domains: [
      {
        domain: 'vietnamguru-v3.localhost',
        defaultLocale: 'ru',
        locales: ['ru'],
        http: true,
      },
    ],
  },
}
Next.js официально поддерживает такую конфигурацию. Поле http: true существует в том числе для локального тестирования locale domains по HTTP вместо HTTPS.
Проблема начинается с порта.
В i18n.domains нельзя нормально указать dev-порт
Обычный Next.js dev server работает на 3000:
http://vietnamguru-v3.localhost:3000
Логично было бы написать:
domains: [
  {
    domain: 'vietnamguru-v3.localhost:3000',
    defaultLocale: 'ru',
    locales: ['ru'],
    http: true,
  },
]
Но i18n.domains в Next.js рассчитан именно на домены, а не на произвольные origins.
Актуальный тип DomainLocale выглядит так:
export interface DomainLocale {
  defaultLocale: string
  domain: string
  http?: true
  locales?: readonly string[]
}
У него нет ни port, ни origin, ни какого-либо devPort.
Это само по себе было бы не так страшно, если бы Next использовал домен только для определения locale. Но domain routing влияет ещё и на генерацию ссылок.
<Link href="/place"> неожиданно становится абсолютной ссылкой
В приложении совершенно обычная ссылка:
<Link href="/place">
  Что посетить
</Link>
Без domain-based i18n от неё ожидаешь HTML примерно такого вида:
<a href="/place">Что посетить</a>
И браузер естественным образом открывает:
http://vietnamguru-v3.localhost:3000/place
То есть текущий origin, включая порт, сохраняется автоматически.
Но при включённом domain routing Next.js знает, что конкретная locale относится к конкретному домену. Поэтому он может сформировать для Link абсолютный locale-domain URL.
В результате получается:
<a href="http://vietnamguru-v3.localhost/place">
  Что посетить
</a>
И вот здесь :3000 уже потерян.
Это особенно неприятно потому, что в исходном JSX никакого абсолютного URL нет:
<Link href="/place">
Абсолютным его делает сам routing layer Next.js.
Получается парадоксальная ситуация:
Текущая страница:
http://vietnamguru-v3.localhost:3000/foo

JSX:
<Link href="/place">

Сгенерированный href:
http://vietnamguru-v3.localhost/place
Браузер совершенно справедливо воспринимает последний URL как HTTP на стандартном порту 80.
Нельзя просто сказать Next.js: «оставь внутренние ссылки относительными»
Вот это, пожалуй, главное ограничение.
В конфигурации domain i18n нет настройки в духе:
relativeLinks: true
или:
absoluteLocaleLinks: false
Нет возможности задать:
port: 3000
и нет отдельного dev-origin:
origin: 'http://vietnamguru-v3.localhost:3000'
То есть модель конфигурации фактически предполагает, что locale domain доступен на стандартном порту соответствующего протокола.
Для production это совершенно нормально:
https://example.com
https://example.fr
Для локальной разработки:
http://example.localhost:3000
— уже проблема.
Почему http: true проблему не решает
Название поля сначала даёт надежду:
{
  domain: 'vietnamguru-v3.localhost',
  http: true,
}
Но оно отвечает только за выбор схемы:
https://
или:
http://
То есть Next получает достаточно информации, чтобы построить:
http://vietnamguru-v3.localhost/place
Но информации о том, что локальный сервер находится на 3000, в этой модели просто нет.
Вариант с reverse proxy
Архитектурно наиболее чистое решение — поставить перед Next локальный reverse proxy:
http://vietnamguru-v3.localhost
              |
              v
        localhost:3000
Например, через nginx, Caddy или другой локальный proxy.
Тогда Next продолжает генерировать:
http://vietnamguru-v3.localhost/place
и этот URL действительно работает.
Но для моего текущего dev environment это лишняя инфраструктура ради обхода ограничения framework.
Поэтому временное решение оказалось проще: запускать сам Next.js непосредственно на 80-м порту.
Запускаем Next.js на 80-м порту
Сам запуск элементарный:
PORT=80 npm run dev
После этого:
http://vietnamguru-v3.localhost
действительно является адресом dev server, и абсолютные ссылки, генерируемые Next.js, начинают работать правильно.
Но появляется следующая проблема.
Обычный пользователь не может слушать порт 80
На Linux порты ниже 1024 традиционно являются privileged ports.
Поэтому обычный:
PORT=80 npm run dev
может закончиться ошибкой доступа при попытке Node.js забиндиться на порт 80.
Первая очевидная мысль:
sudo npm run dev
Но это плохой вариант сам по себе, а в моём случае ещё и практически нерабочий: Node/npm установлены не глобально в системное окружение.
Например, если Node управляется пользовательским version manager'ом, npm, который видит текущий shell, вовсе не обязательно существует в окружении sudo.
Получается классическая ситуация:
npm run dev
работает, а:
sudo npm run dev
— уже нет или запускает вообще другое Node-окружение.
И запускать весь dev server от root только ради возможности открыть один порт всё равно не хочется.
CAP_NET_BIND_SERVICE вместо запуска Node от root
В Linux для этого существует capability CAP_NET_BIND_SERVICE.
Она позволяет конкретному executable открывать privileged network ports без запуска всего процесса от root.
Для текущего Node executable:
which node
можно выдать capability:
sudo setcap 'cap_net_bind_service=+ep' $(which node)
После этого Node можно продолжать запускать от обычного пользователя:
PORT=80 npm run dev
и процесс сможет слушать порт 80.
В результате локальная схема становится такой:
vietnamguru-v3.localhost
        |
        | :80
        v
   Next.js dev
а Next.js domain routing генерирует:
http://vietnamguru-v3.localhost/place
что теперь соответствует реальному адресу приложения.
Почему это всё-таки workaround
Выдача CAP_NET_BIND_SERVICE самому node — не идеальное универсальное решение.
Capability назначается executable Node.js, а не конкретному Next.js-проекту. Следовательно, любой процесс, запущенный через этот конкретный Node binary от данного окружения, получает возможность bind'иться к privileged ports.
Кроме того, если Node установлен через version manager и версия Node переключается или переустанавливается, путь к executable может измениться. Capability тогда придётся назначать новому бинарнику заново.
Проверить текущие capabilities можно, например, так:
getcap $(which node)
Ожидаемый результат:
/path/to/node cap_net_bind_service=ep
При необходимости capability можно удалить:
sudo setcap -r $(which node)
Поэтому это именно удобный локальный workaround, а не настройка, которую стоит бездумно распространять на все development environments.
Что в итоге
Проблема оказалась не в DNS, /etc/hosts, React или поведении браузера.
Она возникает из сочетания нескольких особенностей Next.js domain-based i18n:
i18n.domainsописывает hostname, но не предоставляет отдельной настройки порта.http: trueпозволяет выбрать HTTP вместо HTTPS, но не задаёт dev-port.- При domain routing Next.js может преобразовывать обычный
<Link href="/...">в абсолютную ссылку на locale domain. - В конфигурации нет отдельного переключателя, позволяющего сохранить такие внутренние ссылки относительными.
- Поэтому стандартный Next dev port
3000плохо сочетается с локальной эмуляцией domain-based locale routing.
В моём случае временное решение получилось таким:
sudo setcap 'cap_net_bind_service=+ep' $(which node)
PORT=80 npm run dev
После этого локальный hostname можно использовать без явного порта:
http://vietnamguru-v3.localhost
и абсолютные locale-domain ссылки Next.js совпадают с фактическим origin.
Работает. Но довольно много инфраструктурных последствий для вещи, которая на уровне приложения выглядит всего лишь как:
<Link href="/place">
Источники
Актуальная документация Next.js по Pages Router подтверждает встроенную поддержку domain routing, структуру domains и назначение http: true именно для локального HTTP-тестирования.
Текущий тип DomainLocale в vercel/next.js содержит domain, defaultLocale, locales и http, но отдельной настройки порта в нём нет.
В документации по Link обычные внутренние переходы по-прежнему задаются относительными pathname (/, /about, /blog/...), то есть абсолютный locale-domain URL не требуется писать в JSX приложения.
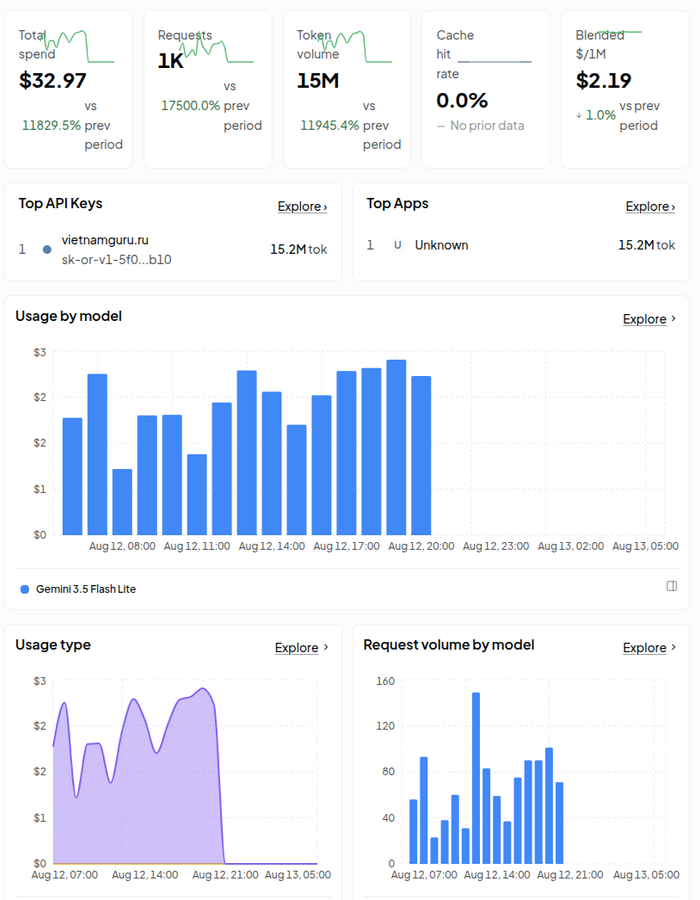
Добавил еще 8 языков. Обновление одной карточки (вот еще эти 8 языков) стоит 5 центов.
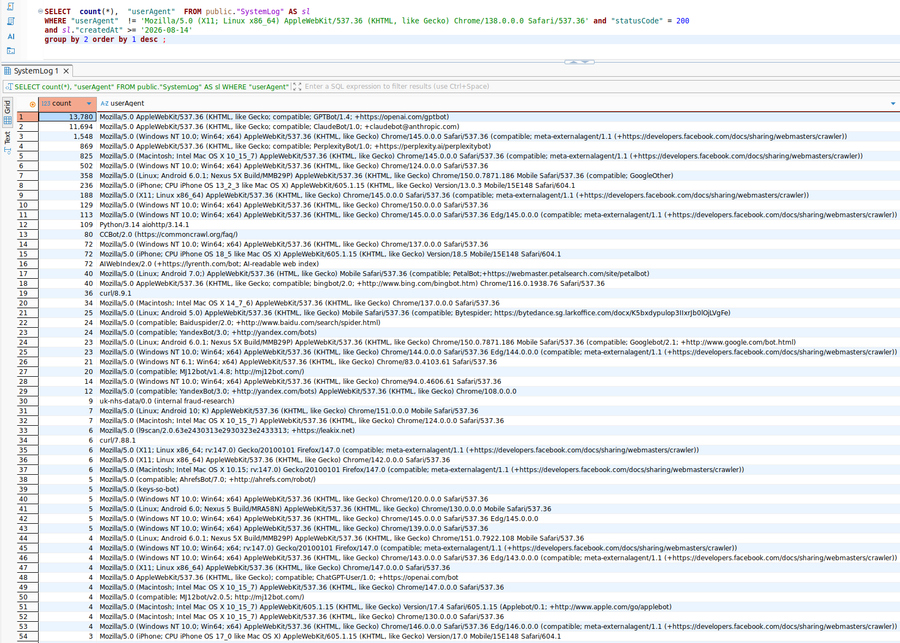
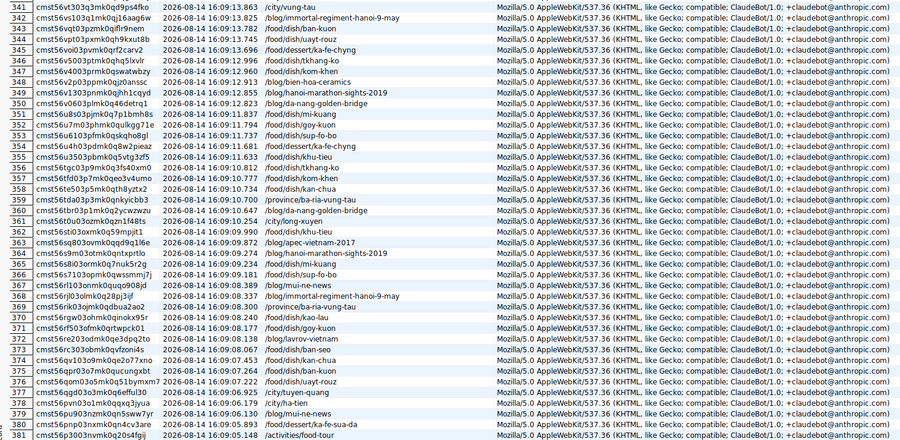
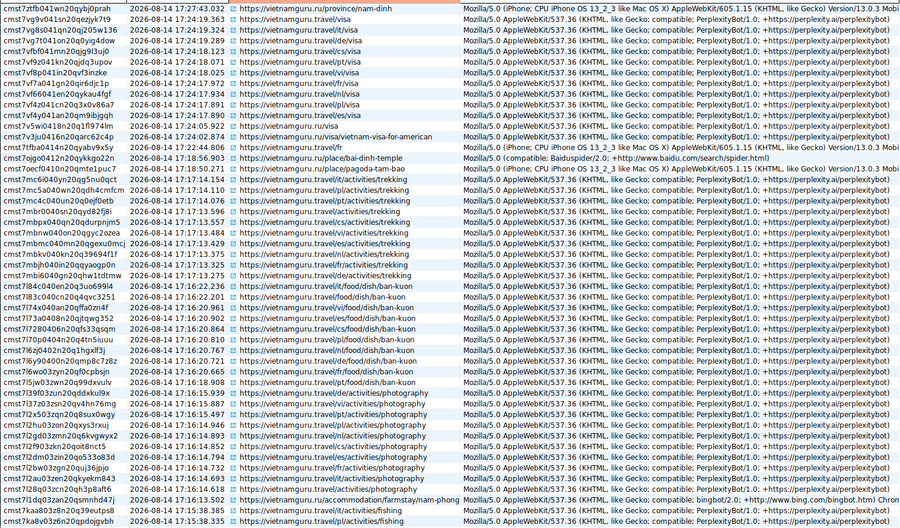
Интересный факт: хотя я запустил совершенно новый домен, который только сегодня и опубликовал - https://vietnamguru.travel, ИИ-боты его скушали почти мгновенно и принялись пылесосить новый сайт.
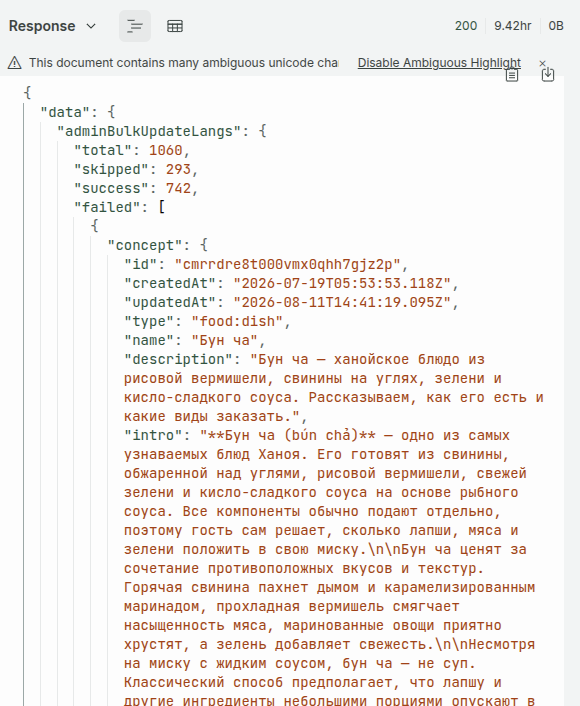
Запустил перевод еще на 8 языков. 742 страницы обработал за 9,5 часов.
Стоило это 32 доллара.
Гипотеза: открытый Web снова станет конкурентным преимуществом
Последние примерно пятнадцать лет развитие веб-инфраструктуры двигалось в сторону всё большего ограничения машинного доступа.
Причины были вполне рациональными. Боты создавали нагрузку, парсили контент, искали уязвимости, занимались спамом, копировали базы, собирали цены, создавали фальшивые аккаунты. В ответ сайты постепенно обрастали CDN, WAF, rate limits, JavaScript challenges, fingerprinting, CAPTCHA, антискрейпингом и поведенческим анализом.
В результате возник парадокс современного интернета:
Мы создали Всемирную паутину для свободного связывания и распространения информации, а затем потратили двадцать лет на то, чтобы сделать эту информацию максимально неудобной для автоматического чтения.
Для Web, в котором основным потребителем страницы был человек с браузером, это имело смысл.
Я предполагаю, что с появлением AI этот баланс начинает меняться.
Бот перестаёт быть только паразитом
В старой экономике публичного сайта существовало довольно простое разделение:
Human → хороший посетительSearch crawler → терпим, потому что приводит humansOther bot → плохой посетитель
У последнего практически не было экономической ценности.
Он забирал страницу, потреблял CPU и bandwidth и ничего не покупал.
Поэтому естественная инженерная стратегия:
не пускать.
Но AI создаёт совершенно новый класс машинного потребителя.
AI crawler может читать сайт не для того, чтобы показать его владельцу украденную копию страницы, а для того, чтобы впоследствии ответить человеку:
Куда съездить из Далата на один день?
Чем porter отличается от stout?
Как правильно пользоваться финской сауной?
И если значительная часть человеческого поиска действительно перемещается из списка ссылок в диалог с AI, происходит принципиальная вещь:
бот становится посредником между издателем и человеком.
Получается:
Старый Web:Publisher ↓Google ↓SERP ↓Human ↓WebsiteAI Web:Publisher ↓Machine ↓understanding / synthesis ↓Human
И тогда запрос AI-бота уже нельзя автоматически считать бесполезным трафиком.
Возможно, это верхняя часть новой воронки привлечения пользователя.
Отсюда возникает парадокс
Индустрия потратила огромные деньги на создание инфраструктуры, прекрасно приспособленной для защиты информации от машин, ровно в тот момент, когда машины начинают становиться одним из основных способов потребления информации.
Причём лучшие и наиболее коммерчески успешные сайты часто защищены сильнее остальных.
Cloudflare, WAF, bot protection, dynamic rendering, authorization walls, rate limiting, JavaScript challenges.
В старой модели это преимущество.
В новой модели для публичного информационного ресурса часть этой инфраструктуры потенциально превращается в distribution handicap.
Самое абсурдное состояние может выглядеть так:
У компании лучший контент в отрасли, но AI знает конкурента лучше, потому что сайт конкурента проще читать.
Не потому, что конкурент лучше оптимизировал keywords.
Не потому, что у него больше backlinks.
А потому, что его знания физически доступны машине.
Второй парадокс: сайты научились дорого отдавать дешёвую информацию
Есть ещё одна проблема, которую я считаю существенной.
Современная веб-разработка много лет оптимизировалась под человеческую сессию.
Один человек открывает страницу, читает её десять секунд, кликает следующую.
Поэтому никого особенно не беспокоит, что получение одной страницы запускает:
SSR↓application server↓5 API calls↓15 database queries↓personalization↓analytics↓third-party services↓render
Человек физически медленный.
AI crawler — нет.
Он способен сказать серверу:
GET page 1GET page 2GET page 3GET page 4GET page 5...
несколько раз в секунду и продолжать это часами.
И неожиданно выясняется, что архитектура, прекрасно обслуживавшая 1000 людей, плохо обслуживает одного очень любознательного робота.
Поэтому просто сказать:
«Хорошо, завтра выключаем Cloudflare protection и разрешаем AI crawlers»
может оказаться невозможно.
За годы существования закрытого Web многие системы потеряли экономическую способность быть открытыми.
Моя ставка противоположная
Для публичных knowledge/content проектов я сознательно считаю массовое машинное чтение желательным поведением.
Поэтому архитектура должна исходить из предположения:
Мой сайт могут читать не тысячи людей, а миллионы машинных запросов. И это хорошо.
Следовательно, marginal cost выдачи публичного знания должен стремиться к нулю.
Если crawler хочет прочитать тысячу страниц — пусть читает.
Если несколько независимых AI-систем хотят одновременно скачать десять языковых версий одной энциклопедии — прекрасно.
Это не DDoS, пока поведение остаётся разумным и инфраструктура его выдерживает.
Это distribution.
VietnamGuru — первый эксперимент
14 августа 2026 года я опубликовал новый международный домен vietnamguru.travel.
Домен новый.
При этом я сознательно сделал его максимально простым для машинного исследования:
- обычные индексируемые URL;
- server-rendered HTML;
- нормальные
<a href>; - sitemap;
- canonical;
- hreflang;
- открытые языковые версии;
- связь со старым
vietnamguru.ru; - отсутствие искусственных препятствий для нормальных crawlers.
И практически сразу после публикации различные AI crawlers начали исследовать новый домен.
Некоторые делают несколько запросов в секунду и систематически проходят связанные страницы и языковые версии.
Я не пытаюсь остановить это поведение.
Наоборот, я считаю его первым наблюдаемым подтверждением того, что новый канал распространения действительно существует.
При этом весь проект работает на совершенно обычной инфраструктуре: небольшой сервер DigitalOcean с 4 CPU и 8 GB RAM при таком crawling остаётся далеко от предела производительности.
Это тоже часть эксперимента.
Моя ставка заключается не только в том, что нужно разрешить машинам читать.
Она заключается ещё и в том, что:
публичный knowledge resource должен быть настолько дешёвым в обслуживании, чтобы ему было экономически выгодно позволять машинам читать себя агрессивно.
Но crawling сам по себе ничего не доказывает
Это принципиальная оговорка.
Сегодня я наблюдаю только:
Discovery.
Мне ещё предстоит проверить следующие стадии:
Discovery ↓Crawling ↓Understanding ↓Retrieval ↓Citation ↓Recommendation
Сам факт прихода GPTBot, PerplexityBot или любого другого crawler не означает, что сайт получит аудиторию.
Поэтому эксперимент должен продолжаться.
Следующий интересный вопрос:
Через какое время после запуска совершенно нового домена независимые AI-системы смогут правильно отвечать на вопросы, используя информацию с него?
Ещё более сильный тест:
Когда они начнут использовать его по небрендовым запросам?
Не:
What is VietnamGuru?
а:
What waterfalls near Da Lat are worth visiting?
И наконец самый интересный уровень:
Когда AI начнёт самостоятельно считать ресурс достаточно полезным, чтобы рекомендовать его или использовать как evidence среди других источников?
Если гипотеза подтвердится
Тогда изменится само понятие оптимизации публичного сайта.
В предыдущем поколении существовало SEO:
помоги поисковой машине найти страницу, чтобы она привела на неё человека.
В следующем может появиться более фундаментальная задача:
помоги машине получить, понять, проверить и связать твои знания, чтобы она могла использовать их при решении задачи человека.
Это уже не совсем SEO.
И даже не обязательно GEO/AEO в сегодняшнем маркетинговом понимании.
Это machine accessibility как свойство информационной системы.
Тогда конкурентными характеристиками становятся:
доступностьструктурностьсвязностьсемантическая ясностьскоростьстабильные URLдешёвое массовое чтениеprovenanceактуальность
То есть многие чрезвычайно скучные инженерные свойства внезапно становятся свойствами дистрибуции.
И здесь появляется ещё один парадокс
В старом Web ценность сайта частично измерялась количеством людей, которых удалось заставить прийти на сайт.
AI может разрушить эту метрику.
Человек может никогда не открыть vietnamguru.travel.
Он спросит своего агента:
Стоит ли ехать в Далат в августе?
А агент прочитает VietnamGuru, сопоставит его с погодой, отзывами, расписанием транспорта и ещё пятью источниками и даст человеку ответ.
С точки зрения Google Analytics:
0 visitors.
С точки зрения реального влияния:
VietnamGuru участвовал в принятии решения.
Получается довольно забавная ситуация:
успешный информационный сайт будущего потенциально может становиться влиятельнее одновременно с уменьшением доли людей, непосредственно посещающих его страницы.
И тогда многие сегодняшние Web-метрики начинают измерять не то.
Более общая ставка
Моя гипотеза поэтому не про VietnamGuru и не про конкретных AI-crawlers.
Она такая:
По мере перехода от human-browsed Web к AI-mediated Web способность публичной информационной системы быть свободно, массово и дёшево прочитанной машинами станет конкурентным преимуществом.
Сегодня значительная часть индустрии по инерции считает bot traffic расходом или угрозой.
Я предполагаю, что для публичных knowledge resources часть этого traffic станет каналом распространения.
Поэтому возникает временное окно.
Пока другие владельцы контента спрашивают:
Как запретить AI забирать мой контент?
я хочу проверить противоположный вопрос:
Что произойдёт, если сделать свой knowledge corpus одним из самых удобных мест для AI, желающего разобраться в моей предметной области?
Возможно, ничего.
Возможно, AI-платформы построят совершенно другие механизмы получения knowledge.
Возможно, publishers действительно закроются и возникнет экономика лицензирования.
Возможно, сегодняшние crawlers через год вообще исчезнут.
Это эксперимент, а не установленный факт.
Но моя ставка на август 2026 года проста:
Если машины становятся новым интерфейсом человека к интернету, воевать с каждой машиной только потому, что она машина, — возможно, одна из последних привычек уходящего Web.
И я сознательно ставлю на противоположное:
Для публичного знания открытость снова станет преимуществом.
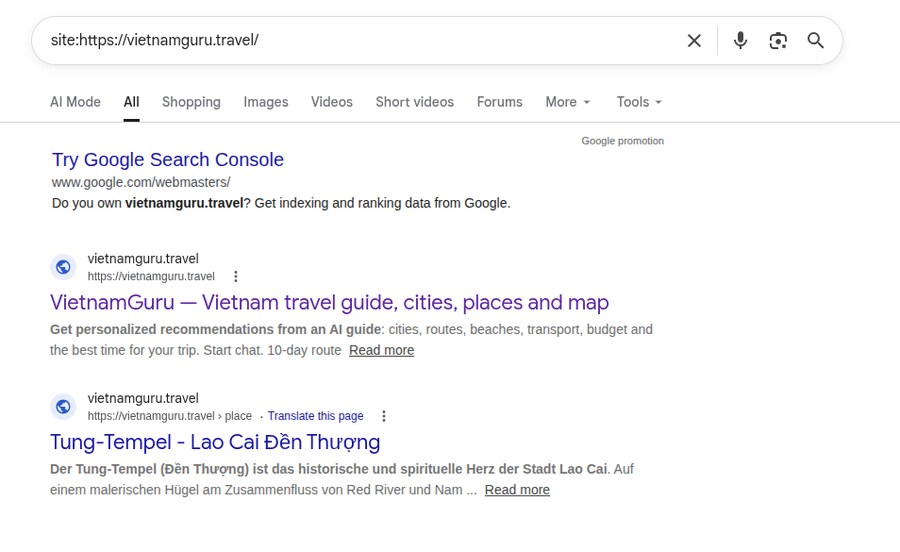
Я наконец-то выкатил мультиязычный сайт на новом домене https://vietnamguru.travel/
Русская версия осталась на https://vietnamguru.ru
Удивительно, но гугл менее чем за сутки уже пару страниц в индекс выдал.
Менее чем за сутки собралась вот такая статистика (сгруппировано по юзерагенту):