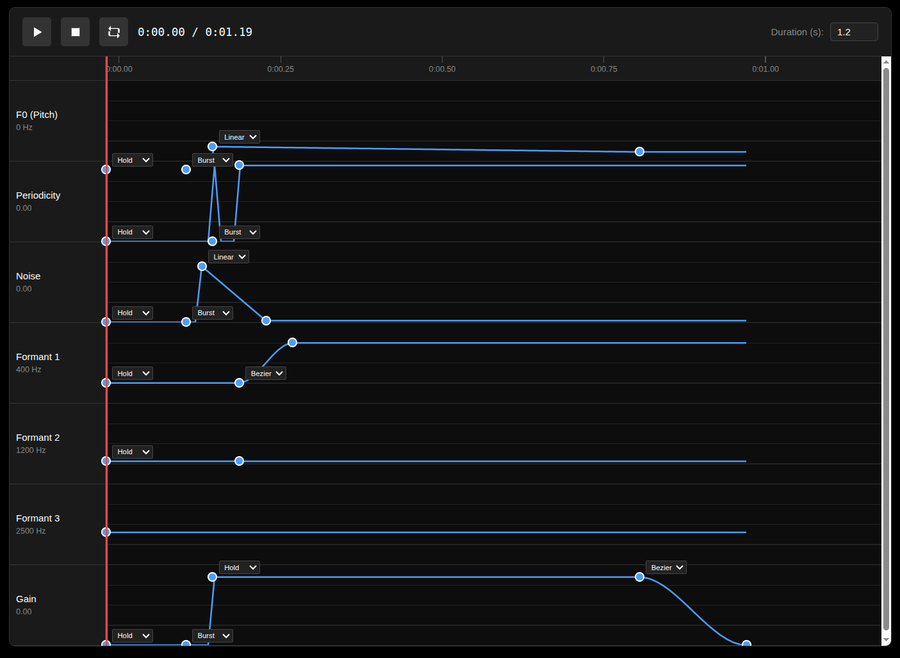
Создать визуальную лабораторию временных сценариев VoiceSynthesizer
Цель
Создать новый визуальный интерфейс не для косметического редактирования уже готового VoiceScenario, а как экспериментальную лабораторию синтеза речи.
Основная задача интерфейса — дать возможность вручную исследовать:
- какие параметры синтезатора;
- в какой последовательности;
- в какие моменты времени;
- с какими значениями и законами изменения
дают тот или иной слышимый результат.
Мы заранее НЕ предполагаем, что знаем правильный сценарий для конкретного звука. Интерфейс нужен именно для поиска: пользователь двигает временные точки и параметры, слушает результат, а найденные интересные звучания затем можно сохранять и отдавать вместе с логами/сценарием на последующий анализ.
Общая модель интерфейса
Интерфейс должен быть организован как многодорожечная временная диаграмма, логически похожая одновременно на:
- automation lanes в DAW;
- keyframe editor;
- диаграмму Ганта только в смысле общей временной оси и синхронизации событий.
Это НЕ классический Gantt и не список set/animate команд.
Координаты
Для каждой дорожки:
- горизонтальная ось = время;
- вертикальная ось = значение параметра;
- параметр задаётся набором редактируемых точек
(time, value); - точку можно перетаскивать горизонтально, меняя момент события;
- точку можно перетаскивать вертикально, меняя значение;
- между точками задаётся закон перехода.
UI может нормализовать вертикальную шкалу к 0..1, но физическое значение параметра должно сохранять собственный диапазон и единицы (Hz, gain и т.п.).
Отдельная общая длительность звучания
Нужен независимый параметр общей длительности сценария.
Это принципиально: управляющие параметры могут быть выставлены или изменены только в начале, но полученное состояние должно продолжать звучать долго.
Примеры смысловой модели:
- коротко выставили состояние и держим длинное
ААААА; - ранние события формируют
МА, а затем состояние долго удерживаетААААААА; - после последней keyframe-точки значение каждого control продолжает удерживаться до общей длительности сценария.
Длительность не должна автоматически обрезаться по последней управляющей точке.
Циклическое воспроизведение
Обязательно предусмотреть переключатель «Циклично».
В циклическом режиме:
- сценарий проигрывается снова сразу после окончания;
- пользователю не нужно каждый раз нажимать Play;
- изменения параметров/точек должны попадать в следующий цикл воспроизведения;
- пользователь может двигать точку или значение и за несколько повторов подряд услышать несколько вариантов результата.
Это ключевой режим именно для ручного поиска звучаний.
Дорожки параметров
На первом этапе редактор должен работать со всеми существующими параметрами VoiceControlState.
Для каждой дорожки нужно видеть:
- имя control;
- его физическое значение;
- нормализованное положение в вертикальной шкале;
- keyframe-точки;
- удержание значения между событиями;
- форму перехода между точками.
Редактор должен показывать фактическую временную траекторию параметра, а не только активные участки animate.
Типы переходов и преобразователей
Архитектуру сразу проектировать так, чтобы между точками существовал не только один вид animate.
Нужна расширяемая модель преобразователя/модулятора временного участка.
Минимально предусмотреть возможность в дальнейшем иметь разные типы:
- hold / постоянное значение;
- linear transition;
- bezier transition;
- периодический модуль;
- синусоидальная модуляция по формуле;
- импульс / burst;
- повторяющееся биение;
- шумовая или иная стохастическая модуляция;
- другие функции времени.
То есть на временную ленту в перспективе должен помещаться не только keyframe, но и преобразователь, который на заданном интервале формирует сложную траекторию параметра.
Пример смысла: параметр может иметь стабильную базу, но поверх неё на участке времени работает периодическая модуляция.
Связь с физиологией речи
Архитектуру редактора нельзя проектировать так, будто каждый control полностью независим физически.
У человека один речевой аппарат:
- один язык;
- одна конфигурация губ;
- один рот/ротовая полость;
- один голосовой тракт;
- одна система голосовых связок и воздушного потока.
Нельзя одновременно задать взаимоисключающие артикуляционные состояния так, словно существуют два независимых языка или две независимые формы рта.
Пока текущий DSP работает в акустическом пространстве (f0, periodicity, noise, resonances, gains и т.д.), но редактор должен быть спроектирован так, чтобы в будущем можно было вводить связанные физиологические/артикуляционные преобразователи, которые управляют сразу несколькими DSP controls согласованно.
Примеры смысловых преобразователей, которые могут появиться позже:
- открытие/закрытие рта;
- изменение положения языка;
- накопление и release давления;
- краткий взрывной burst;
- устойчивый поток воздуха;
- дрожание/биение артикулятора для
Р; - переход между артикуляционными состояниями.
Важно: это не требование немедленно реализовать полноценную физиологическую модель. Требование — не закрыть архитектурой такую возможность.
Особый смысл временной структуры
Редактор должен исходить из того, что звук имеет смысл только во времени.
Например, взрывной согласный — это не одно значение параметра, а последовательность фаз:
- подготовка/закрытие;
- накопление;
- release;
- burst;
- шумовой или голосовой хвост;
- переход в следующий звук.
А устойчивый звук может быть результатом стабильного состояния, которое после короткого входного перехода удерживается долго.
Поэтому пользователь должен видеть и редактировать композицию фаз во времени, а не только список чисел.
Что сохранять
Найденный эксперимент должен быть воспроизводимым.
Нужно уметь сохранить:
- общую длительность;
- все дорожки и keyframes;
- типы переходов/преобразователей;
- их параметры;
- итоговый
VoiceScenarioили компилируемое представление; - при необходимости метаданные эксперимента.
Существующий VoiceScenario можно использовать как runtime/формат исполнения, но UI не должен быть ограничен его текущей command-centric формой. Допустим отдельный экспериментальный/keyframe-формат, который компилируется в runtime-представление.
Связь с существующим runtime
Редактор должен использовать тот же общий runtime VoiceScenario, который используется синтезатором и визуализатором, после соответствующего рефакторинга.
Нельзя иметь отдельную семантику исполнения параметров только внутри UI.
Фактическое звучание и фактически отображаемые траектории должны происходить из одной state machine.
Что НЕ является целью первого этапа
Сейчас не требуется:
- автоматически угадать правильный звук;
- автоматически построить фонему;
- добавить новые акустические метрики только ради визуализации;
- сразу построить полноценную физиологическую модель речевого аппарата;
- заменить decoder.
Первая прикладная цель — максимально упростить ручное экспериментирование:
- быстро расставить временные точки;
- менять значения;
- слышать результат в цикле;
- понимать последовательность собственных действий;
- сохранять удачные варианты;
- отдавать найденный сценарий и его логи на дальнейший анализ.
Критерий результата
Пользователь может открыть лабораторию, задать общую длительность, включить Циклично, расставлять и двигать keyframe-точки нескольких параметров по общей временной шкале и непрерывно слышать, как изменения влияют на звучание.
Интерфейс должен помогать именно искать неизвестные заранее звучания, а не требовать заранее понимать, какой JSON нужно написать.