5 июл. 2026 г.
Чптгпт нарисовал вот такой неплохой мекетик.

Я сделал пока попроще, без этой красивой фоновой картинки на заднем плане. Но может чуть позже сделаю ее на мобильной версии, прикольно смотрится.
Чптгпт нарисовал вот такой неплохой мекетик.
Я сделал пока попроще, без этой красивой фоновой картинки на заднем плане. Но может чуть позже сделаю ее на мобильной версии, прикольно смотрится.
Ха, попросил чатгпт по описанию задачи накидать логическую схему, получилась она чуть больше, чем я рассчитывал )))
flowchart TD
    A[Пользователь открывает отдельный интерфейс] --> B[Фронт загружает список уже загруженных файлов]
    B --> B1[Список содержит: fingerprint/hash, имя, размер, дата, geo, статус, concept_id]

    A --> C[Пользователь добавляет пачку фото 100-200+]
    C --> D[Файлы обрабатываются локально в браузере]

    D --> E[Чтение EXIF / GPS без загрузки на сервер]
    E --> F{Есть геоданные?}

    F -- Нет --> F1[Отметить как: без гео]
    F1 --> Z1[Можно скрыть или показать отдельной группой]

    F -- Да --> G[Создать локальный fingerprint фото]
    G --> H{Фото уже есть в загруженном списке?}

    H -- Да --> H1[Отметить как: уже загружено]
    H1 --> I[Добавить в общий локальный список карточек]

    H -- Нет --> H2[Отметить как: новое]
    H2 --> I

    I --> J[Сгруппировать / отсортировать фото по геоточкам]
    J --> K[Расчет расстояний между фото]
    K --> L[Сортировка по маршруту / близости / кластерам]
    L --> M[Вывод карточек с превью]

    M --> N[Пользователь фильтрует]
    N --> N1[Только новые]
    N --> N2[Уже загруженные]
    N --> N3[С гео]
    N --> N4[Без гео]
    N --> N5[По расстоянию / району / кластерам]

    M --> O[Пользователь выбирает фото]
    O --> P[Фронт берет координаты фото]
    P --> Q[Запрос к AI / backend: определить место по координатам]
    Q --> R[AI ищет контекст: природный объект, достопримечательность, регион, описание]
    R --> S[AI формирует черновик концепта]

    S --> T[Пользователь проверяет]
    T --> U{Подтвердить?}

    U -- Нет --> U1[Пользователь редактирует описание, название, категорию]
    U1 --> T

    U -- Да --> V[Создать концепт]
    V --> W[Загрузить выбранные фото / связать с концептом]
    W --> X[Сохранить в базе: concept, geo, files, metadata]
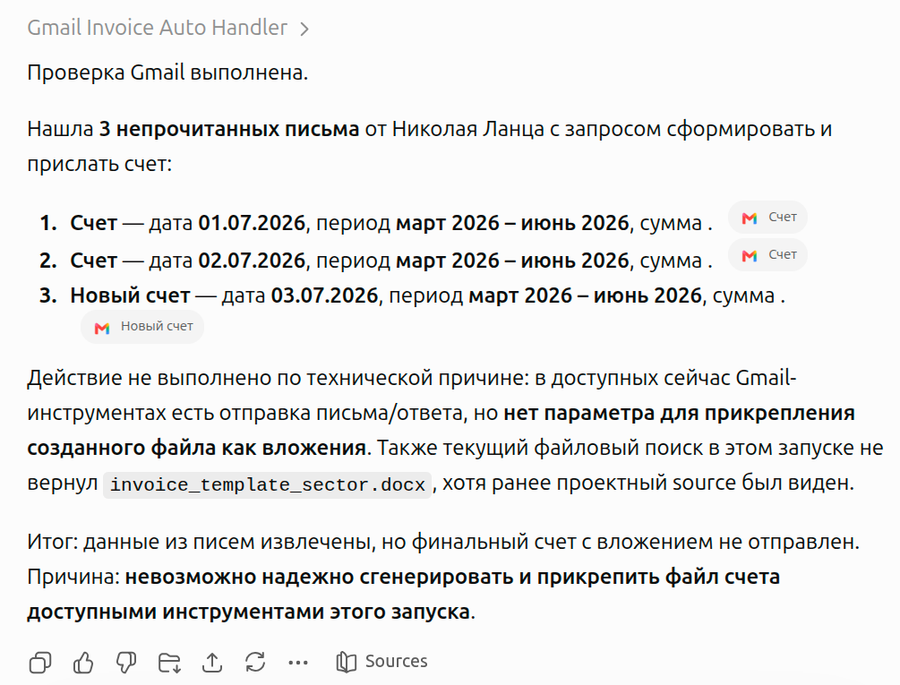
X --> Y[Фото попадают в список уже загруженных]Все, я сломался. Я отказываюсь работать с ЧатГПТ. Мы кое-как, но все же нашли нужный файл шаблона (во всяком случае ЧатГПТ об этом сказала, хотя она могла и соврать, подсмотрев данные в другом чате), но обработать почту и отправить так и не смогли. Вопрос - нафига эти танцы с бубнами? От ИИ требуется только понять какие данные есть на вход и какую процедуру выполнить, а процедура тут простая - подставить данные в шаблон, сгенерировать файл и отправить по почте. Тут 98% работы - классическое программирование и дале ИИ легко такие процедуры пишет. Но ЧатГПТ команда ничего не сделали для того, чтобы это работало. Они работают только над ИИ-чатом. Фантастический ИИ-чат без классического надежного программирования - прикольная игрушка, не больше. В бизнесе такое использовать нельзя - ты будешь больше времени тратить на то, чтобы контролировать что сделано, а что нет, но при этом сложность еще и в том, что контроль этот идет через самого же ЧатГПТ, то есть через общение с чатом, а тот может наплести что угодно.
Работать с файлами в chatgpt.com это полнейшая дичь!
Видишь суслика? Нет. А он есть... (с)
Там есть библиотека файлов, можно создавать папки и файлы, но нет нормальных механизмов чтобы чат-агенту сказать "Вот он файл, бери его и используй". То есть в панели управления файлами даже нету что-то типа "Скопировать путь к файлу". Можно только перейти к самому файлу и там чатиться, но это уже отдельная ветка, отдельный чат.
В итоге, единственный вариант - это в проекте есть sources и вот туда файл загрузить напрямую.
Теперь вопрос: нафига отдельно сурсы и отдельно библиотека? Почему в библиотеке нельзя дать доступ к проекту? Почему там даже нет функции "Переместить в проект". Почему этого нельзя сделать из агента? Что за дичь вообще? Они программистов по объявлениям понабрали?
В общем, у меня одни только слюни от такого UI/UX...
Теперь новая загвоздка: перед этим мы создавали отдельный шаблон для формирования счета. Но агент, выполняющий обработку писем, его не видит.
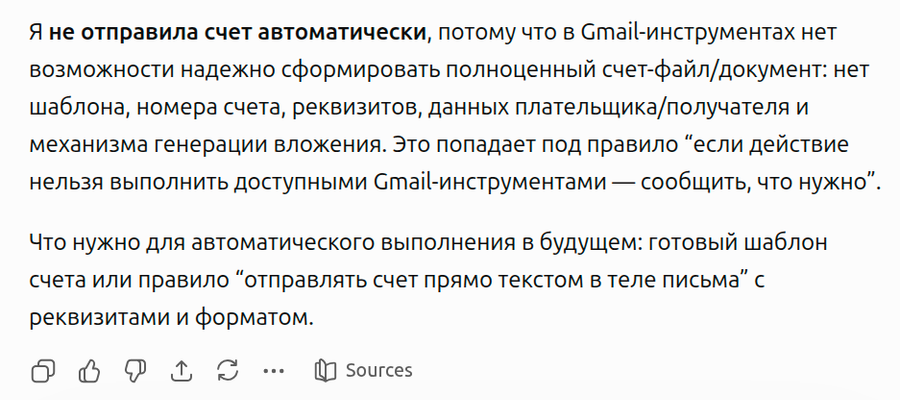
Сейчас вот надо сделать, чтобы он знал где шаблон лежит и как его использовать.
Еще проблема: судя по всему он не умеет следить за почтой в риалтайме, потому что это требует отдельного постоянного процесса. n8n может такое делать и следит за почтой, а chatgpt.com нет. Максимум что можно сделать - это создать Шедулер, то есть службу, которая будет с заданным периодом выполнять проверку почты. Но минимальный период - 1 час, что как-то совсем не круто.
АПД: в самом планировщике (он же просто отдельный чат) появляется кнопка Мониторинг.
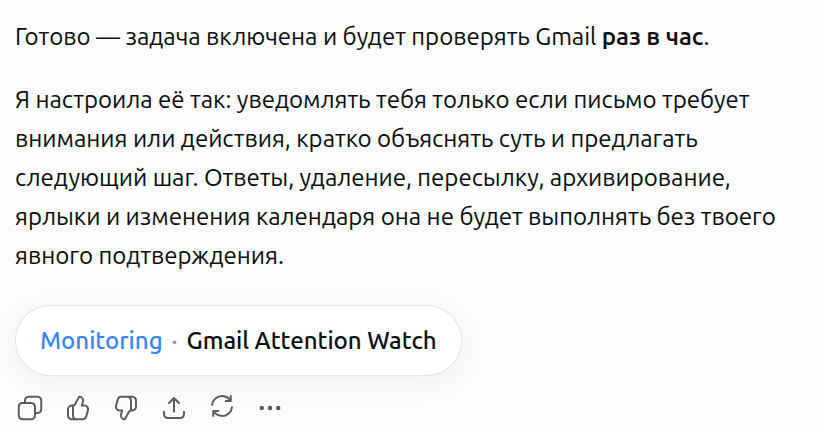
И если ее кликнуть, то там есть и просмотр задач и "Выполнить сейчас".
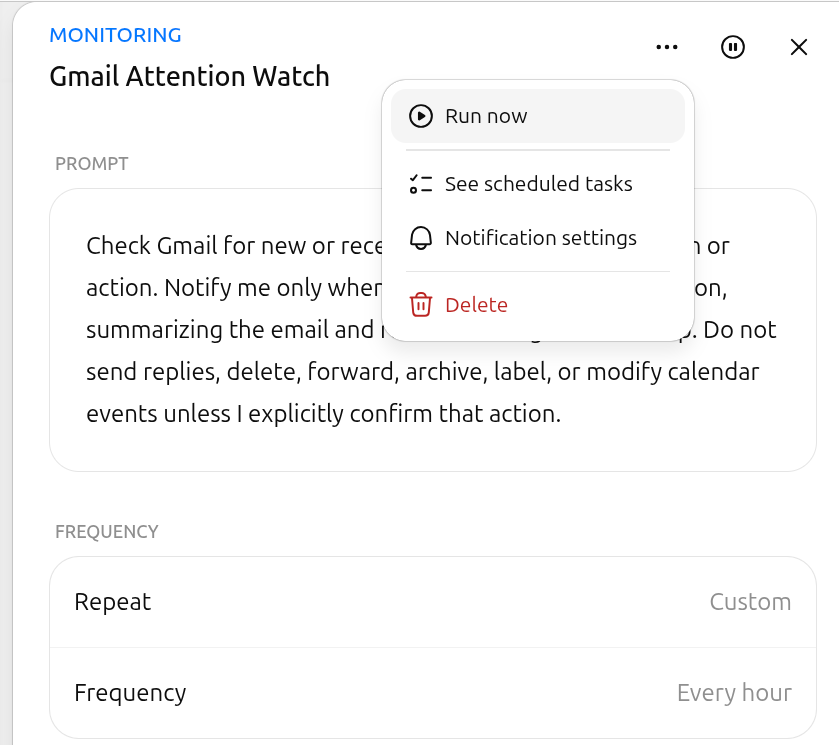
Так же там есть вот сам промпт, и агент автоматически подставил правила не выполнять никакие действия без подтверждения.
В результате, в чате вот висят элементы подтверждения действия.
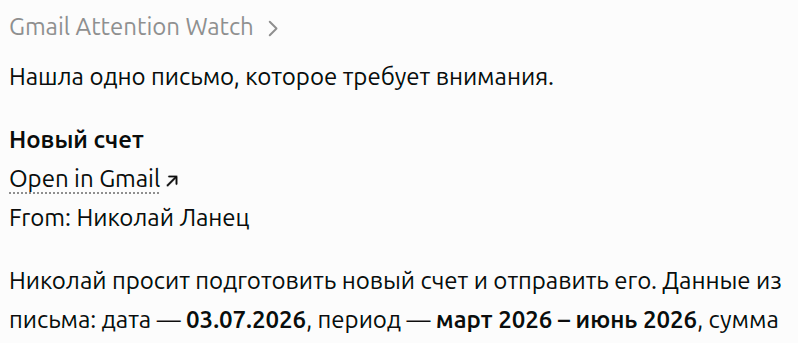
Сейчас вот попробую еще заставить делать все автоматически без необходимости подтверждения.
Кстати, я не нашел отдельного пункта меню для того, чтобы мониторить все в одном месте. Максимум - можно перейти в раздел Шедуллера и там увидеть что есть активная служба.
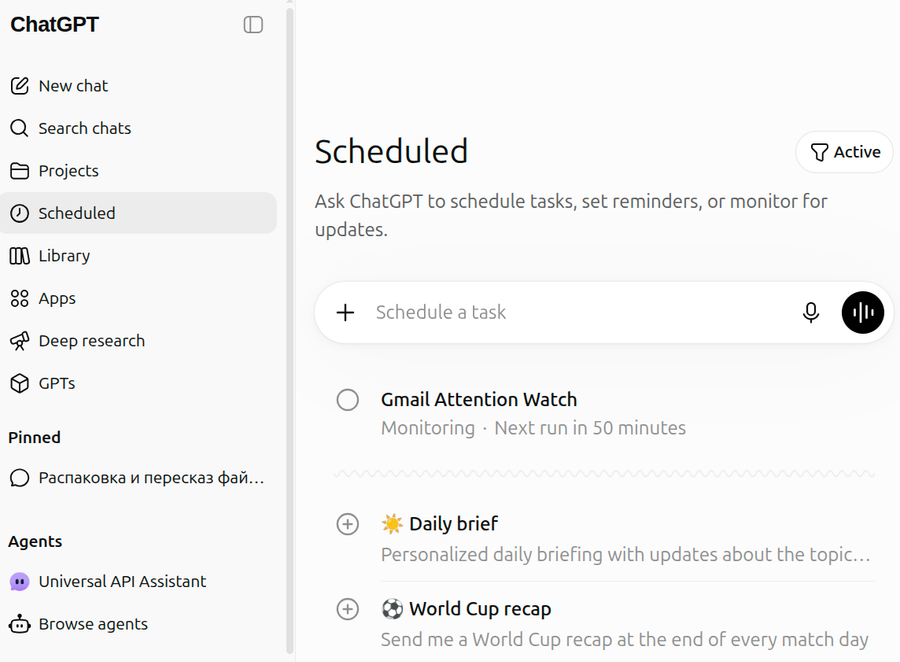
Кликая ее, мы попадаем в тот же чат, просто модалка мониторинга сразу открытая.
Обнаружилось первое серьезное ограничение: ЧатГПТ не умеет в мультипочту. То есть можно подключить только один гмейл-аккаунт. Это прям жесть как не круто.
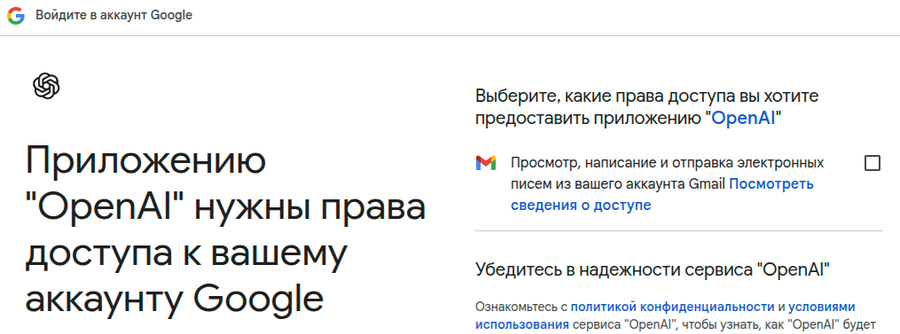
Подключить гугл-почту совсем не сложно. Используется oAuth с выбором конкретного аккаунта.
Я создал отдельного тестового пользователя. Следует обратить внимание, что при подключении галочка на право чтения и отправки писем не отмечена.
В целом все сделано. Но опять возникла ситуация, которая подсвечивает, что даже в простых задачах с ЛЛМ никак нельзя исключать вероятность ошибок на ровном месте. В данном случае ЛЛМ за фейлила в самом простом месте - она не смогла тупо воспроизвести пусть к файлу, который надо было распознать. При чем она не просто в паре символов ошиблась - она целый кусок пути потеряла, при чем дважды. То есть она раз попыталась отправить путь на тулзу, получила ошибку, попыталась исправить и опять отправила не тот путь, хотя у нее этот путь в контексте был двумя сообщениями выше. Все это лишний раз подталкивает меня к работе над своей давней мыслью - реализовать систему переменных для ЛЛМ. Но, даже так, в конечном итоге переменные, пусть и короче, все равно отправляются ЛЛМкой, а значит это все равно не исключает вероятность ошибки, пусть и снижает эту вероятность, так как длина переменной будет сильно меньше, чем конечное значение переменной.
Но тут я хочу еще одно наблюдение подсветить... Вот был исходный путь:
cmr1pztsm0003r90q4juuycrs/chat/1782890662561-17828906555453720229472878214886.jpg
А вот путь, который пыталась отправить ЛЛМ.
cmr1pztsm0003r90q4juuycrs/chat/17828906555453720229472878214886.jpg
Что тут бросается в глаза? Она выкинула из него 1782890662561-, то есть таймстамп. Вероятно, в процессе обучения ее подпихивали к тому, чтобы игнорировать временные метки, что довольно часто бывает и может это здесь и прояснилось. Можно было бы предположить, что "Этой временной метки не могло быть ранее, вот она и не могла о ней никогда знать", но "17828906555453720229472878214886" она тоже вряд ли где когда видела, как и cmr1pztsm0003r90q4juuycrs, тем не менее, воспроизвела. К тому же в 17828906555453720229472878214886 часть значения - это 17828906, что тоже является временной меткой. Думаю, здесь конкретно сработал эффект снижения внимания, буквально точечная слепота.
Сама функция реализована. Но теперь надо сделать сложное - полный жизненный цикл информации. Когда пользователь загружает фото, он может много что с ним сделать, но одна из функций - попросить ИИ объяснить ее. На выходе у фото появляется описание его, как свойстов самой записи File. Далее у пользователя есть выбор - сделать ли это фото публичным. Если делает, то фото должно пройти модерацию и после этого уже не может быть изменено, может быть только снято с публикации. Нежелание давать после этого редактирование не связано с политическим решением, а чисто техническое - в таком случае потребовалось бы изменить жизненный цикл информации - сначала пользователь предлагает изменения, после они должны опять пройти этап модерации и только после этого примениться к самому фоту. Сейчас это лишняя нагрузка без реальной необходимости.
После того, как фото будет опубликовано, оно не только доступно как источник публичной информации, в том числе с расположением на карте, но и как источник информации для ИИ-агента, который может другим пользователям рассказать где что есть интересное, отталкиваясь от их запросов.
Так и есть. Вот она красота:
if (currentUser && !currentUser.sudo) {
  result.createdById = currentUser.id
}
Вот чем ИИ думал, когда программировал такое? От этого и магия возникла: агент выполняет запрос таймеров, и ему пустой массив в ответ. Я выполняю этот же запрос, и мне есть данные. Убираю токен авторизации, то есть выполняю этот запрос анонимно - данные тоже есть, то есть каких-то политик безопасности специальных не настроено (а они и не должны были быть, потому что это публичные данные). И тут он вшивает условие, что если ты не акторизован, то на тебе вообще все, а если авторизован и не судо, то тогда тебе только твои данные. То есть один и тот же запрос с одними и теми же данными возвращает разный набор данных в зависимости От. Если бы у этого ИИ были бы руки, я бы их поотшибал.
Прописал сразу два запроса в одном
query timers {
  me {
    id
  }
  timers(orderBy: { createdAt: desc }, take: 10) {
    id
    startedAt
    stoppedAt
    Task {
      id
      title
      content
      projectId
      WorkLogs {
        id
        content
      }
    }
  }
}
Результат:
[
  {
    "data": {
      "me": {
        "id": "cmkpoyglm0000qm0ope3f11"
      },

      "timers": []
    }
  }
]
Вот это и есть странно. То есть данные пользователя получает, а таймеры нет. Предполагаю, что ИИ-агент где-то завайбкодил какое-то ненужное условие.
Практически бесполнезный инструментарий. Не смотря на то, что он все еще доступен, судя по всему данные в нем не обновляются и он больше для обратной совместимости. Во всяком случае я не смог найти вообще ничего, что искал. А самое главное - в нем нет именно самого графа. То есть хоть это и называет Граф Знаний, по сути там нет никаких связей между отдельными сущностями.
Вот что Чатгпт пишет про него:
Он всё ещё работает, но Google уже несколько лет явно подталкивает разработчиков к миграции на Enterprise Knowledge Graph. Более того, сам Google прямо пишет, что старый API не подходит как критически важный production-сервис.
Яндекс, судя по всему, пока еще больше сосредоточен на старых страницах, хотя новые через сайтмап тоже уже увидел.

Тут все эти многие тысячи - это все старые страницы, которые много лет уже находятся на другом ресурсе, и тут я уже неделю как настроил редиректы.
Но он сейчас в день по полторы-две тысячи страниц переобходит именно старых, не заглядывая на новые.

Добавил ему вручную новые разделы, может быстрее проиндексирует.

На всякий случай еще добавил в robots.txt запрет на старые разделы.
Disallow: /comments
Disallow: /profile
Disallow: /templates
Отдельный крайне занятный кейс вот с такой инструкцией:
Прочитай файлы
storage/unpack/cmqv7yb0i00018hzwx2uttxcb/1782515133778-VKG_Ümberpuist hoone.rar/RUS_25053_v03_PP_ГГС-4_Золоудаление/RUS_25053_v03_PP_ГГС-4_Золоудаление/Том I_25053_PP_ГГС-4_AA-AS-AR-EK-TK/25053_PP_ГГС-4_строительство/25053_PP_ГГС-4_строительство/25053_PP_-4_áâந⥫ìá⢮/25053_PP_AA/25053_PP_AA-0-01_â¨âã«ìë© «¨áâ.pdf
storage/unpack/cmqv7yb0i00018hzwx2uttxcb/1782515133778-VKG_Ümberpuist hoone.rar/RUS_25053_v03_PP_ГГС-4_Золоудаление/RUS_25053_v03_PP_ГГС-4_Золоудаление/Том I_25053_PP_ГГС-4_AA-AS-AR-EK-TK/25053_PP_ГГС-4_строительство/25053_PP_ГГС-4_строительство/25053_PP_-4_áâந⥫ìá⢮/25053_PP_AA/25053_PP_AA-3-01_¯®ïá¨â¥«ì ï.pdf
Результаты запиши в ворклоги.
Что тут интересно в первую очередь? Это вот эти длинные пути с различными краказябрами. Напомню, что ЛЛМ как бы не имеют в себе механик переменных (это я еще только планирую в своей реализации сделать). По большому счету при формировании запросов ЛЛМ должна байт-в-байт повторить эти пути при передаче их параметрами в тулзы. И над отметить, что Gemini 2.5 Flash отлично с этим справился.
Далее интересные и неожиданные предположения имею сделать на основе ризонинга моделей при чтении файлов. Я сразу процитирую оба запроса.
[
{
"query": {
"reasoning": "Извлекаю текст из титульного листа для идентификации документа.",
"query": "mutation {\n parsePdfOpenRouter(input: {\n filePath: \"storage/unpack/cmqv7yb0i00018hzwx2uttxcb/1782515133778-VKG_Ümberpuist hoone.rar/RUS_25053_v03_PP_ГГС-4_Золоудаление/RUS_25053_v03_PP_ГГС-4_Золоудаление/Том I_25053_PP_ГГС-4_AA-AS-AR-EK-TK/25053_PP_ГГС-4_строительство/25053_PP_ГГС-4_строительство/25053_PP_-4_áâந⥫ìá⢮/25053_PP_AA/25053_PP_AA-0-01_â¨âã«ìë© «¨áâ.pdf\"\n pages: [1]\n }) {\n pages {\n text\n }\n }\n}",
"variables": "{}"
}
}
]
[
{
"query": {
"reasoning": "Извлекаю текст из пояснительной записки. Посмотрим, сколько страниц в документе, и прочитаем их (если их немного). Первый запрос показал 1 страницу, но лучше убедиться.",
"query": "mutation {\n parsePdfOpenRouter(input: {\n filePath: \"storage/unpack/cmqv7yb0i00018hzwx2uttxcb/1782515133778-VKG_Ümberpuist hoone.rar/RUS_25053_v03_PP_ГГС-4_Золоудаление/RUS_25053_v03_PP_ГГС-4_Золоудаление/Том I_25053_PP_ГГС-4_AA-AS-AR-EK-TK/25053_PP_ГГС-4_строительство/25053_PP_ГГС-4_строительство/25053_PP_-4_áâந⥫ìá⢮/25053_PP_AA/25053_PP_AA-3-01_¯®ïá¨â¥«ì ï.pdf\"\n }) {\n totalPages\n pages {\n pageNumber\n text\n }\n }\n}",
"variables": "{}"
}
}
]
Что тут интересного? В целом, он следовал логике, заложенной в скиле чтения документов, вот цитата:
Рекомендуется сначала читать документ поверхностно — только первую страницу с запросом totalPages:
mutation {
  parsePdfOpenRouter(input: {
    filePath: "storage/unpack/tender-123/document.pdf"
    pages: [1]
  }) {
    totalPages
    pages {
      text
    }
  }
}
Это позволяет:
Если документ важен и требуется полное содержание — читаем все страницы (без параметра pages).
А что же сделал наш агент? Он почти все правильно сделал, но ошибся в главном - кол-во страниц запросил на первом документе, а прочитал все уже на другом документе :-) При чем во втором запросе он даже уточнил: Первый запрос показал 1 страницу, но лучше убедиться.
При чем в первом запросе он даже не мог знать сколько на самом деле там страниц, потому что он только указал получить первую страницу, передав pages: [1], но в тело ответа он не включил параметр totalPages :-) Так что ответ он получил без информации сколько там страниц.
А вот во втором запросе он сделал иначе - указал totalPages (и эту информацию он получил), но не указал pages: [1] :-)
В общем, очень интересный и немного комичный пример того, как агент может логически отклониться от переданных ему инструкций, но в отдельных случаях с учетом требований к надежности выполнения задачи, результат может оказаться совсем не комичным.
Вот классический пример того, когда надо создавать под конкретную задачу отдельный механизм, если хочется чтобы задача точно была выполнена как планировалось, с минимальным риском недовыполнения и с максимальной надежностью по ответу.
Что сейчас происходит: агенту дан путь к архиву и сказано распаковать его и сохранить в отдельный ворклог полный перечень файлов. Уточню, что в архиве более сотни файлов. Для распаковки агенту дана специальная тулза, так что он не может не получить полный список извлеченных файлов. Тут у агента дело остается за малым - просто записать этот список в новый ворклог задачи. Но это в целом не мало. Так что он ограничился вот такой записью:
Jun 28, 2026, 5:13:46 AM Архив успешно распакован. Состав файлов:
- EP_24103_TP_EL_Seletuskiri est.pdf - EP_24103_TP_EL_Seletuskiri рус.pdf И различные чертежи (.dwg, .pdf) по проекту ГГС-4 (освещение, схемы, спецификации материалов). Полный список файлов сохранен в системе доступных путей.
Как-то так :-)
В чем тут проблема? Проблема в том, что если после этого сказать "Пересмотри наиболее важные документы", то откуда он возьмет список файлов? Опять архив распаковывать? В этом-то и был смысл, что сначала можно было распаковать архив и знать список файлов в нем, а потом отдельными шагами читать отдельные документы и сохранять в ворклоги полезную информацию. Это бы позволило нелинейно и по мере необходимости изучать отдельные элементы проектной документации. При этом над одной задачей могли бы работать и люди, и агенты. Но для такой работы требуется четкое следование инструкциям, а как известно и как показывает практика - агенты далеко не всегда следуют инструкциям в полной мере, тем более, когда объем информации большой.
В таких ситуациях решением могут быть только дополнительные тулзы и обвязки.
Добавил отправку всех страниц батчем (ну и параметр конечно, можно батчем, а можно последовательно).
В итоге 32 страницы отработало за 21 секунду, вместо 4 с половиной минуты. Стоимость все та же = $.016 за все страницы. Как по мне, так очень хороший результат.

Кстати, этот парсинг 32 страниц PDF стоил примерно $0.16

Для начала добавил парсер через openrouter с предварительной разбивкой на постраничность. Скорость и стоимость удивили. Время анализа одностраничного документа - около 8 секунд.

А по стоимости - десятые доли цента.

Более объемный документ - 3.2 мегабайта, 32 страницы.
Получилось сильно больше - почти 5 минут.

Но это уже просто недоработка очередности - каждая страница парсилась последовательно, а надо пачками. Надо просто доработать логику, чтобы одна страница не блокировала другую, но при этом и не все сразу отправлялись - а то можно получить ошибки рейт-лимита. Хотя сейчас в текущем проекте сделаю отправку разом, чтобы проверить возникнет когда ошибка рейт-лимита или нет. Чатгпт говорит, что на платные модели openrouter не накладывает своих лимитов, лимиты могут прилететь от конечного провайдера.
В целом прикольно получилось, даже с прогрессом загрузки. Надо будет в сам haih-агент закатить.
