Nhiệm vụ: Tạo phòng thí nghiệm trực quan kịch bản thời gian VoiceSynthesizer
Tạo phòng thí nghiệm trực quan kịch bản thời gian VoiceSynthesizer
Trình chỉnh sửa đa rãnh tương tác để thử nghiệm thủ công với các thông số tổng hợp theo thời gian, nghe lặp lại và tìm kiếm các âm thanh thú vị.
Mục tiêu
Tạo ra một giao diện trực quan mới không phải để chỉnh sửa mang tính thẩm mỹ cho một VoiceScenario đã có sẵn, mà là một phòng thí nghiệm tổng hợp giọng nói thử nghiệm.
Nhiệm vụ chính của giao diện là cho phép khám phá thủ công:
- những tham số tổng hợp nào;
- theo trình tự nào;
- vào những thời điểm nào;
- với những giá trị và quy luật thay đổi nào
tạo ra kết quả âm thanh này hay kết quả âm thanh khác.
Chúng ta KHÔNG giả định trước rằng chúng ta biết kịch bản chính xác cho một âm thanh cụ thể. Giao diện này cần thiết chính là để tìm kiếm: người dùng di chuyển các điểm thời gian và tham số, nghe kết quả, sau đó các âm thanh thú vị tìm được có thể được lưu lại và chuyển đi cùng với nhật ký/kịch bản để phân tích tiếp theo.
Mô hình giao diện chung
Giao diện nên được tổ chức như một biểu đồ thời gian đa rãnh, có logic tương đồng đồng thời với:
- các rãnh tự động hóa (automation lanes) trong DAW;
- trình chỉnh sửa khung hình chính (keyframe editor);
- biểu đồ Gantt nhưng chỉ theo nghĩa là trục thời gian chung và đồng bộ hóa sự kiện.
Đây KHÔNG phải là biểu đồ Gantt cổ điển cũng không phải là danh sách các lệnh set/animate.
Tọa độ
Đối với mỗi rãnh:
- trục ngang = thời gian;
- trục dọc = giá trị tham số;
- tham số được đặt bởi một tập hợp các điểm có thể chỉnh sửa
(time, value); - có thể kéo điểm theo chiều ngang để thay đổi thời điểm sự kiện;
- có thể kéo điểm theo chiều dọc để thay đổi giá trị;
- quy luật chuyển đổi giữa các điểm được thiết lập.
UI có thể chuẩn hóa thang đo dọc về 0..1, nhưng giá trị vật lý của tham số phải giữ nguyên phạm vi và đơn vị của riêng nó (Hz, gain, v.v.).
Thời lượng âm thanh tổng thể riêng biệt
Cần có một tham số độc lập về tổng thời lượng kịch bản.
Điều này mang tính nguyên tắc: các tham số điều khiển có thể được thiết lập hoặc thay đổi chỉ ở phần đầu, nhưng trạng thái thu được phải tiếp tục phát ra âm thanh trong thời gian dài.
Ví dụ về mô hình ngữ nghĩa:
- thiết lập ngắn trạng thái và giữ âm
AAAAAdài; - các sự kiện sớm hình thành
MA, sau đó trạng thái tiếp tục giữAAAAAAAtrong thời gian dài; - sau điểm keyframe cuối cùng, giá trị của mỗi điều khiển tiếp tục được giữ cho đến tổng thời lượng của kịch bản.
Thời lượng không được tự động cắt bớt theo điểm điều khiển cuối cùng.
Phát lại vòng lặp (Cyclic Playback)
Bắt buộc phải trang bị công tắc "Lặp lại" (Loop).
Ở chế độ lặp lại:
- kịch bản được phát lại ngay lập tức sau khi kết thúc;
- người dùng không cần phải nhấn Play mỗi lần;
- các thay đổi về tham số/điểm phải có hiệu lực trong chu kỳ phát lại tiếp theo;
- người dùng có thể di chuyển một điểm hoặc giá trị và nghe thấy một vài biến thể kết quả qua một vài lần lặp liên tiếp.
Đây là chế độ quan trọng để tìm kiếm âm thanh thủ công.
Các rãnh tham số
Ở giai đoạn đầu, trình chỉnh sửa phải hoạt động với tất cả các tham số hiện có của VoiceControlState.
Đối với mỗi rãnh, cần nhìn thấy:
- tên control;
- giá trị vật lý của nó;
- vị trí được chuẩn hóa trong thang đo dọc;
- các điểm keyframe;
- việc giữ giá trị giữa các sự kiện;
- hình dạng chuyển đổi giữa các điểm.
Trình chỉnh sửa phải hiển thị quỹ đạo thời gian thực tế của tham số, chứ không chỉ các phân đoạn animate hoạt động.
Các loại chuyển đổi và bộ biến đổi
Kiến trúc phải được thiết kế ngay từ đầu sao cho giữa các điểm không chỉ tồn tại một loại animate duy nhất.
Cần có một mô hình mở rộng về bộ biến đổi / bộ điều chế khoảng thời gian.
Tối thiểu phải dự trù khả năng có các loại khác nhau trong tương lai:
- hold / giá trị không đổi;
- linear transition (chuyển đổi tuyến tính);
- bezier transition (chuyển đổi Bezier);
- bộ điều chế định kỳ;
- điều chế hình sin theo công thức;
- xung / burst;
- nhịp đập lặp đi lặp lại;
- điều chế nhiễu hoặc ngẫu nhiên khác;
- các hàm thời gian khác.
Nghĩa là, trong tương lai, trên dòng thời gian không chỉ có thể đặt keyframe mà còn cả bộ biến đổi, tạo ra một quỹ đạo tham số phức tạp trong khoảng thời gian đã cho.
Ví dụ ý nghĩa: tham số có thể có một cơ sở ổn định, nhưng bên trên nó tại một khoảng thời gian sẽ có sự điều chế định kỳ hoạt động.
Mối liên hệ với sinh lý học giọng nói
Kiến trúc của trình chỉnh sửa không thể được thiết kế theo kiểu mỗi control hoàn toàn độc lập về mặt vật lý.
Con người chỉ có một cơ quan phát âm:
- một lưỡi;
- một cấu hình môi;
- một khoang miệng;
- một ống thanh quản;
- một hệ thống dây thanh quản và luồng không khí.
Không thể đồng thời đặt các trạng thái cấu âm loại trừ lẫn nhau như thể tồn tại hai ngôn ngữ độc lập hoặc hai hình dạng miệng độc lập.
Trong khi DSP hiện tại hoạt động trong không gian âm học (f0, tính tuần hoàn, nhiễu, cộng hưởng, gain, v.v.), trình chỉnh sửa phải được thiết kế để trong tương lai có thể đưa vào các bộ biến đổi sinh lý/cấu âm được ghép nối, điều khiển đồng thời nhiều control DSP một cách đồng bộ.
Ví dụ về các bộ biến đổi ngữ nghĩa có thể xuất hiện sau:
- mở/đóng miệng;
- thay đổi vị trí lưỡi;
- tích lũy và giải phóng (release) áp suất;
- tiếng nổ ngắn (burst);
- luồng không khí ổn định;
- rung/đập cơ quan cấu âm cho âm
R; - chuyển đổi giữa các trạng thái cấu âm.
Quan trọng: đây không phải là yêu cầu phải triển khai ngay lập tức một mô hình sinh lý học đầy đủ. Yêu cầu là không đóng lại khả năng đó bằng kiến trúc.
Ý nghĩa đặc biệt của cấu trúc thời gian
Trình chỉnh sửa phải xuất phát từ thực tế là âm thanh chỉ có ý nghĩa trong thời gian.
Ví dụ, một phụ âm tắc không phải là một giá trị tham số duy nhất, mà là một chuỗi các pha:
- chuẩn bị/đóng;
- tích lũy;
- release (giải phóng);
- burst (nổ);
- phần đuôi nhiễu hoặc giọng nói;
- chuyển sang âm thanh tiếp theo.
Và một âm thanh kéo dài có thể là kết quả của một trạng thái ổn định được giữ trong thời gian dài sau một quá trình chuyển đổi đầu vào ngắn.
Do đó, người dùng phải nhìn thấy và chỉnh sửa thành phần các pha theo thời gian, chứ không chỉ là một danh sách các con số.
Những gì cần lưu trữ
Thí nghiệm đã tìm thấy phải có khả năng tái tạo.
Cần có khả năng lưu trữ:
- tổng thời lượng;
- tất cả các rãnh và keyframe;
- các loại chuyển đổi/bộ biến đổi;
- các tham số của chúng;
VoiceScenariocuối cùng hoặc biểu diễn có thể biên dịch;- siêu dữ liệu thí nghiệm nếu cần thiết.
VoiceScenario hiện tại có thể được sử dụng như một runtime/định dạng thực thi, nhưng UI không được giới hạn bởi hình thức tập trung vào lệnh hiện tại của nó. Cho phép sử dụng một định dạng thử nghiệm/keyframe riêng biệt được biên dịch thành biểu diễn runtime.
Mối liên hệ với runtime hiện có
Trình chỉnh sửa phải sử dụng cùng một runtime chung VoiceScenario được sử dụng bởi bộ tổng hợp và bộ trực quan hóa, sau khi tái cấu trúc thích hợp.
Không thể có ngữ nghĩa thực thi tham số riêng biệt chỉ bên trong UI.
Âm thanh thực tế và các quỹ đạo được hiển thị thực tế phải xuất phát từ một máy trạng thái (state machine) duy nhất.
Điều gì KHÔNG phải là mục tiêu của giai đoạn đầu
Hiện tại không yêu cầu:
- tự động đoán âm thanh chính xác;
- tự động xây dựng một âm vị (phoneme);
- thêm các chỉ số âm học mới chỉ vì mục đích trực quan hóa;
- xây dựng ngay lập tức một mô hình sinh lý học đầy đủ của cơ quan phát âm;
- thay thế bộ giải mã (decoder).
Mục tiêu ứng dụng đầu tiên là đơn giản hóa tối đa việc thử nghiệm thủ công:
- nhanh chóng sắp xếp các điểm thời gian;
- thay đổi các giá trị;
- nghe kết quả trong vòng lặp;
- hiểu trình tự các hành động của chính mình;
- lưu các tùy chọn thành công;
- chuyển giao kịch bản tìm được và nhật ký của nó để phân tích thêm.
Tiêu chí kết quả
Người dùng có thể mở phòng thí nghiệm, đặt tổng thời lượng, bật Lặp lại (Cyclic), sắp xếp và di chuyển các điểm keyframe của một vài tham số dọc theo trục thời gian chung và liên tục nghe thấy sự thay đổi ảnh hưởng như thế nào đến âm thanh.
Giao diện nên giúp ích chính xác trong việc tìm kiếm các âm thanh chưa biết trước, chứ không yêu cầu phải hiểu trước xem cần viết JSON gì.
Ворклоги
Tiến độ chi tiết về Phòng thí nghiệm Trực quan Kịch bản Thời gian
Những gì đã được triển khai
Một bộ tổng hợp thử nghiệm và trình soạn thảo trực quan mới, tách biệt đã được tạo ra, có chủ ý không liên kết với VoiceSynthesizer trước đây và mô hình DSP phức tạp tích lũy của nó.
Quyết định kiến trúc quan trọng này được đưa ra một cách có ý thức: mục tiêu của giai đoạn hiện tại không phải là duy trì khả năng tương thích với các kịch bản cũ hay tái tạo các thí nghiệm trong quá khứ, mà là có được một bệ thử nghiệm trong phòng thí nghiệm sạch sẽ nhất có thể để nghiên cứu âm thanh thủ công.
Cấu trúc hiện tại bao gồm:
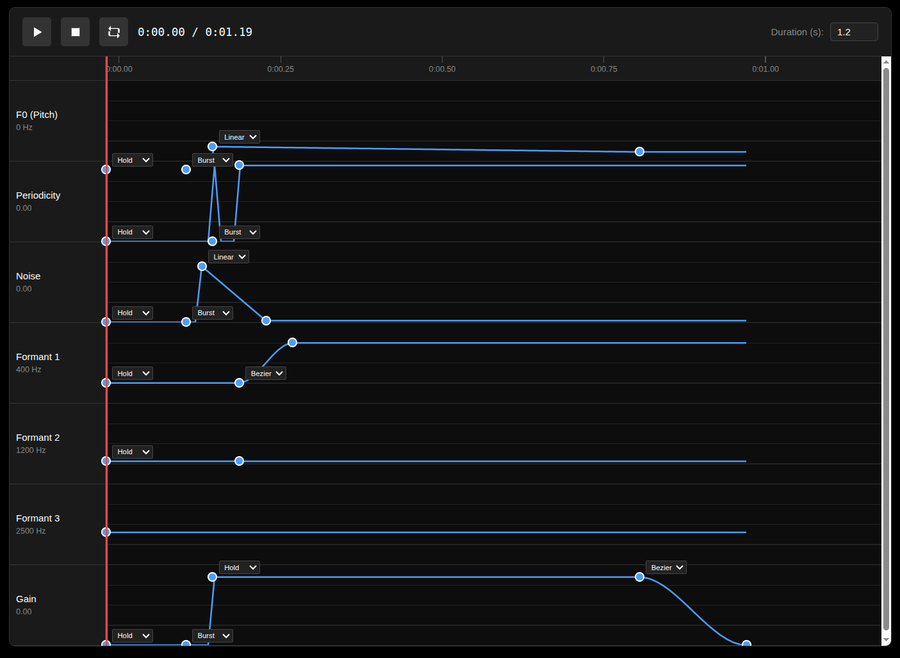
- trình soạn thảo nhiều bản nhạc (multi-track) cho các tham số thời gian;
- các điểm keyframe trên một trục thời gian chung;
- kéo-thả (drag-and-drop) theo thời gian và theo giá trị;
- Play / Pause / Stop;
- Chế độ Loop;
- thời lượng tổng thể của kịch bản độc lập;
- tua (seek) trên timeline;
- hiển thị các giá trị tham số hiện tại;
- các kiểu chuyển đổi
hold,linear,bezier,sine,burst,noise; - tổng hợp âm thanh mới riêng biệt dựa trên Web Audio API;
- mô hình âm học tối thiểu dựa trên
sawtooth + noise + formant filters + gain.
Giao diện người dùng hiện hiển thị các bản nhạc thử nghiệm chính:
- F0 / Pitch;
- Periodicity;
- Noise;
- Formant 1;
- Formant 2;
- Formant 3;
- Gain.
Giao diện trực quan cho thấy kết quả tốt như một công cụ phòng thí nghiệm: trục thời gian dễ đọc, các sự kiện có thể nhìn thấy, các tham số có thể được thay đổi nhanh chóng và tổng thời lượng không bị ràng buộc vào điểm cuối cùng. Điều này cho phép xây dựng các âm thanh kéo dài và chuỗi trạng thái dài.
Làm rõ quan trọng về định hướng
Trình soạn thảo mới KHÔNG nên đóng vai trò là giao diện cho DSP cũ vào lúc này.
Nó được hình thành như một thí nghiệm sạch độc lập:
nguồn đơn giản + bộ lọc đơn giản + quỹ đạo thời gian -> kết quả nghe được.
Câu hỏi nghiên cứu chính:
Liệu chúng ta có thể thực sự thủ công, bằng phương pháp thử có kiểm soát và lắng nghe, tìm ra ít nhất một số âm thanh có thể nhận dạng giống giọng nói hay không?
Nói cách khác, nhiệm vụ hiện tại không phải là khả năng tái tạo của VoiceScenario cũ, mà là tìm kiếm mô hình âm học hoạt động tối thiểu nhất.
Tại sao chọn một bộ tổng hợp mới riêng biệt
Nhánh tổng hợp trước đó đã tích lũy rất nhiều thử nghiệm và tham số phụ lẫn nhau. Hiện tại rất khó để hiểu lỗi nằm ở đâu và việc thay đổi một cơ chế có thể dễ dàng làm hỏng cơ chế khác.
Do đó, một bệ thử nghiệm sạch cần thiết như một môi trường được kiểm soát, nơi mỗi cơ chế mới được thêm vào một cách có ý thức và hiệu ứng của nó có thể được nghe thấy riêng biệt.
Nguyên tắc làm việc tiếp theo:
động cơ tối thiểu -> tìm kiếm thủ công -> quan sát -> phát hiện cơ chế còn thiếu -> chỉ thêm cơ chế đó -> lặp lại thí nghiệm.
Kiểm tra thực tế đầu tiên cho thấy gì
Theo tác nhân phát triển (developer agent), tập hợp các tính năng có vẻ đã hoàn thiện, nhưng việc kiểm tra thực tế kết quả cho thấy báo cáo quá lạc quan.
Ở giai đoạn hiện tại:
- phần lớn các âm thanh/preset đã chuẩn bị thực tế không thể nghe thấy hoặc không mang lại kết quả mong đợi;
- bản thân báo cáo của tác nhân không thể được coi là bằng chứng về khả năng hoạt động;
- trong số các hiệu ứng đơn giản dễ nhận biết, hiện tại chủ yếu chỉ nghe thấy âm xì giống như âm
S; - các âm hoàn chỉnh
A,M,R,Tvà các âm khác chưa thu được thủ công và chưa được xác nhận bằng tai.
Điều này không được coi là thất bại của thí nghiệm. Ngược lại, bệ thử nghiệm giờ đây cho phép tìm hiểu xem những cơ chế nào thực sự là tối thiểu cần thiết cho sự xuất hiện của các lớp âm thanh cụ thể.
Giá trị thực tế hiện tại của phòng thí nghiệm
Giá trị thực tế của trình soạn thảo vẫn chưa được chứng minh một cách dứt khoát.
Hiện tại, một điều cơ bản hơn đang được kiểm tra:
- Có mối liên hệ nhân quả nghe thấy được giữa một tham số cụ thể và kết quả không.
- Có thể bằng cách di chuyển một hoặc nhiều điểm thủ công để thu được âm thanh thay đổi có thể dự đoán được hay không.
- Có thể tìm thấy các lớp âm học ổn định hay không:
- giống nguyên âm;
- tiếng ồn / xát (fricative);
- âm tắc (plosive);
- âm mũi (nasal);
- định kỳ / rung;
- các lớp giống giọng nói khác.
- Có thể lưu cấu hình đã tìm thấy như một công thức có thể tái tạo hay không.
Nếu các điểm này được xác nhận, phòng thí nghiệm đã hữu ích như một công cụ nghiên cứu, ngay cả khi chất lượng âm thanh vẫn còn cách xa giọng nói con người.
Kết luận khái niệm quan trọng
Không cần phải xây dựng trước một mô hình sinh lý giọng nói phức tạp.
Hợp lý hơn là trước tiên tìm kiếm các cơ chế âm học tối thiểu bằng tay.
Ví dụ:
- nếu không thể tạo ra âm
Rmà không có bộ điều biến định kỳ, điều này sẽ trở thành cơ sở thực nghiệm để thêm cơ chế đó; - nếu âm
Tyêu cầu chuỗisilence -> burst -> noise tail, điều này cũng phải bắt nguồn từ thí nghiệm thủ công; - nếu một loại nguyên âm nhất định yêu cầu
F0 + F1/F2/F3ổn định, điều này phải được tìm thấy và xác nhận bằng tai.
Nghĩa là, các tính năng mới được thêm vào không phải theo giả định, mà theo sự thiếu hụt quan sát được của mô hình hiện tại.
Các hạn chế và câu hỏi hiện tại
- Cần kiểm tra từng điều khiển hiện tại riêng lẻ và trong các kết hợp tối thiểu.
- Cần hiểu loại chuyển đổi nào hiện tại thực sự hữu ích và loại nào vẫn mang tính trang trí.
burst,sine, dao động lặp lại và điều biến tiếng ồn về mặt khái niệm có thể không chỉ là phép nội suy, mà là một lớp bộ điều biến thời gian riêng biệt. Có lẽ sau này nên tách biệt:- envelope / keyframes;
- bộ điều biến nằm trên quỹ đạo cơ bản.
- Cần kiểm tra xem các phạm vi vật lý của tham số và trạng thái zero của chúng được tổ chức chính xác đến mức nào.
- Cần thêm tính năng lưu thuận tiện các âm thanh và kịch bản thành công khi xuất hiện các kết quả thực sự thú vị.
- Biểu đồ phổ (spectrogram) và các phương pháp phân tích kết quả khác có thể cần thiết sau này, nhưng ưu tiên hiện tại là tìm kiếm thủ công bằng thính giác và độ rõ ràng nhân quả của giao diện.
Tiêu chí thành công trước mắt
Không phải là "bộ tổng hợp đã biết nói" và không phải "các preset trùng khớp với các chữ cái".
Tiêu chí thành công trước mắt đơn giản hơn nhiều:
Người dùng có thể bật Loop, di chuyển điểm keyframe hoặc tham số, nghe một vài tùy chọn liên tiếp và tìm kiếm một cách ổn định ít nhất một số âm thanh giống giọng nói có thể nhận dạng được, đồng thời hiểu được thay đổi nào đã dẫn đến chúng.
Sau khi tìm thấy những âm thanh thú vị, kịch bản và logic sẽ được sử dụng để phân tích tiếp theo và để đưa ra quyết định về những cơ chế mới nào thực sự đáng thêm vào.
Tiến độ ngắn gọn: cần viết lại hoàn toàn bản hiện thực hóa hiện tại
Kiểm tra thực tế cho thấy thành phần hiện tại không thể được coi là nền tảng khả thi cho các thử nghiệm âm thanh tiếp theo.
Các vấn đề chính:
- Kiến trúc âm thanh về cơ bản không phù hợp cho việc tổng hợp chất lượng cao. Các tham số được cập nhật theo từng khối thông qua các node Web Audio trong khi phát, trong khi đối với việc tổng hợp thử nghiệm có kiểm soát, sẽ hợp lý hơn nếu tính toán trước PCM/mảng giá trị mẫu theo toàn bộ logic thời gian và đưa bộ đệm đã sẵn sàng cho AudioContext phát lại.
- Bản thân DSP hiện tại có cấu trúc chưa tốt: sóng răng cưa đi qua ba bộ lọc dải thông-hình thức (bandpass-formant) hẹp được nối tiếp nhau, điều này hầu như phá hủy phần tuần hoàn; trong khi đó, tiếng ồn đi theo một đường trực tiếp riêng biệt.
- Dòng thời gian giao diện người dùng (UI timeline) và dòng thời gian âm thanh (audio timeline) thực tế có các đồng hồ khác nhau. Vòng lặp (loop), tua (seek), tạm dừng/phát (pause/play) và thời gian âm thanh thực không cùng thuộc một cỗ máy trạng thái (state machine).
- Điều khiển âm thanh thông qua
requestAnimationFrame(~60 Hz) không phù hợp cho các sự kiện âm thanh ngắn, chùm (burst) và các chuyển đổi nhanh; việc làm mịn bổ sung càng làm mờ các sự kiện hơn nữa. - Vòng đời của các nguồn âm thanh chứa các điều kiện tranh chấp (race conditions) và trạng thái không nhất quán: Phát lặp lại hoạt động không ổn định, Dừng có thể dẫn đến việc âm thanh tiếp tục phát lại bất ngờ, các callback cũ/tham chiếu nguồn (source refs) có thể tồn tại lâu hơn việc thay đổi trạng thái.
- Trong UI/UX có quá nhiều refs/states/hooks độc lập chịu trách nhiệm cho các phần của một trạng thái phát lại duy nhất. Thay vào đó, cần có một
useReducerduy nhất / cỗ máy trạng thái hữu hạn với các trạng tháistopped/playing/pausedrõ ràng và các chuyển đổi tất định. - Báo cáo thực hiện hóa ra lại lạc quan hơn đáng kể so với hành vi thực tế: giao diện có vẻ ngoài trực quan như một phòng thí nghiệm hoàn chỉnh, nhưng các kịch bản người dùng cơ bản như Phát/Dừng/Phát lại và bản thân kết quả âm thanh lại không đáng tin cậy.
- Kết luận: việc vá lỗi cục bộ cho bản hiện thực hóa hiện tại là không khả thi. Thành phần cần được viết lại từ đầu, chỉ giữ lại ý tưởng chung về một phòng thí nghiệm trực quan: dòng thời gian, các track tham số, khung hình chính (keyframes), vòng lặp và tìm kiếm âm thanh thủ công. Phiên bản mới nên được xây dựng xung quanh một cỗ máy trạng thái duy nhất và tính toán trước bộ đệm âm thanh từ kịch bản.